explain 可以模拟优化器执行sql 语句,从而分析sql语句处理过程,得到sql语句或者表结构性能瓶颈
MySQL架构体系
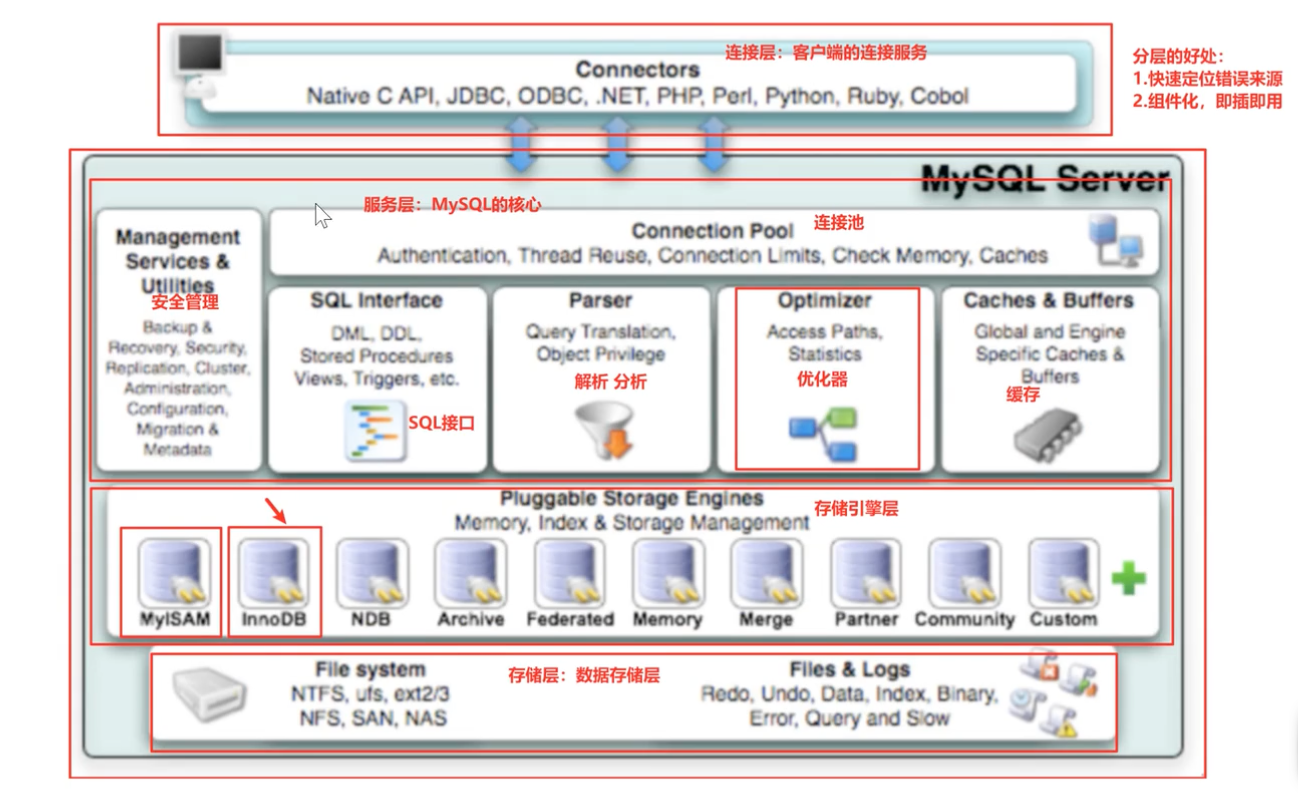
MySQL是由连接池、SQL接口、解析器、优化器、缓存、存储引擎、文件系统组成的,可以分为四层:
• 连接层
• 服务层
• 引擎层
• 文件系统层
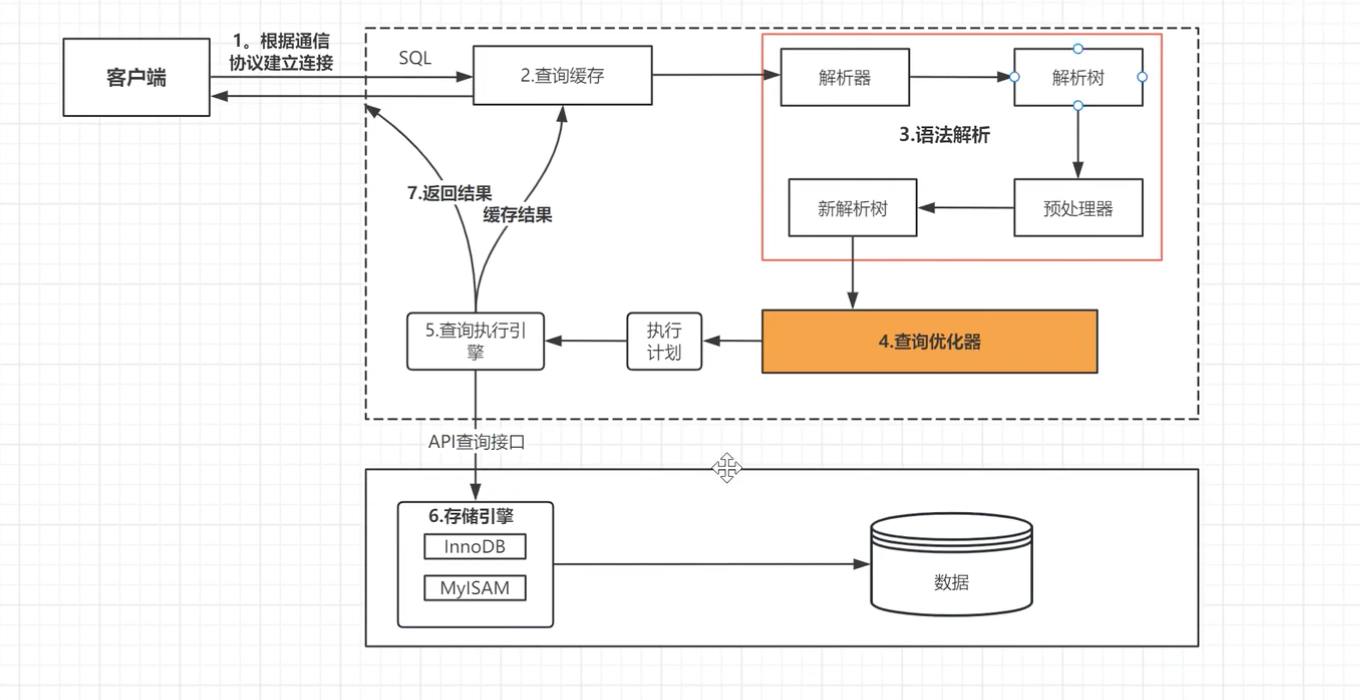
MYSQL 查询过程
主要字段
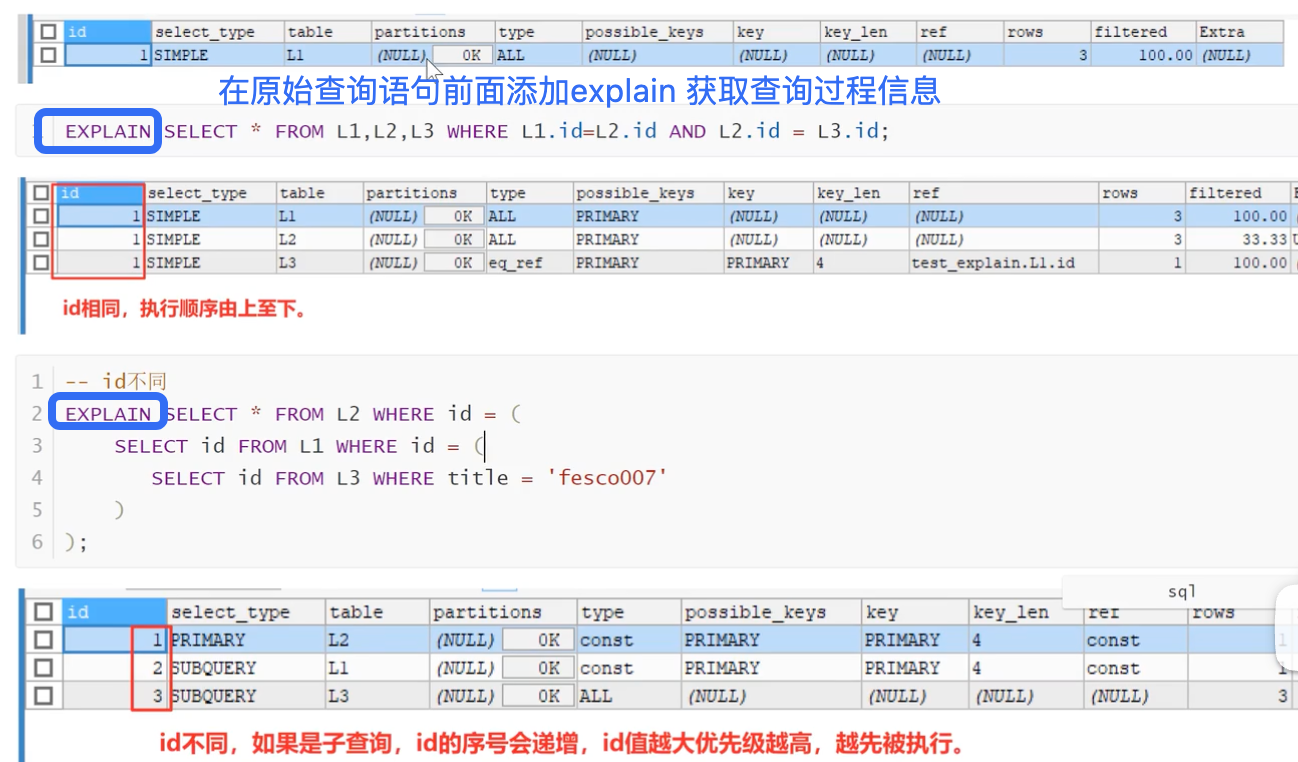
id字段
1 | --创建数据库 |
id字段表示的是查询的序列号,包含一组数字,表示查询中执行子句或者操作表的顺序
select_type字段
- table:表名
- select_type:表示【查询类型】,主要用于区别普通查询、联合查询、子查询等等复杂查询。
1. simple
1 | -- simple |

simple 表示简单的 select 查询,查询中不包含子查询和 UNION。
2. primary / subquery(复杂查询)
1 | -- 复杂查询 |
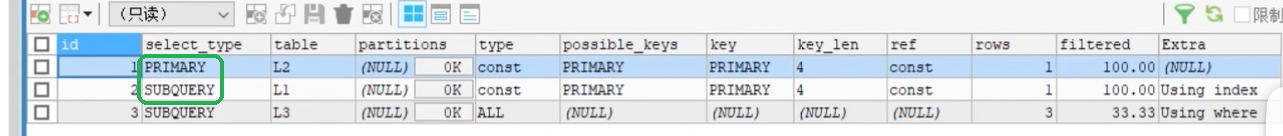
- primary:查询中如果包含任何复杂的子部分,最外层查询将会被标记为 primary
- subquery:在 select 或者 where 列表中包含的子查询
3. union / derived / union result(合并查询)
1 | -- 合并查询 注意UNION连接L3和L4,L3被标记为derived,L4被标记为union |
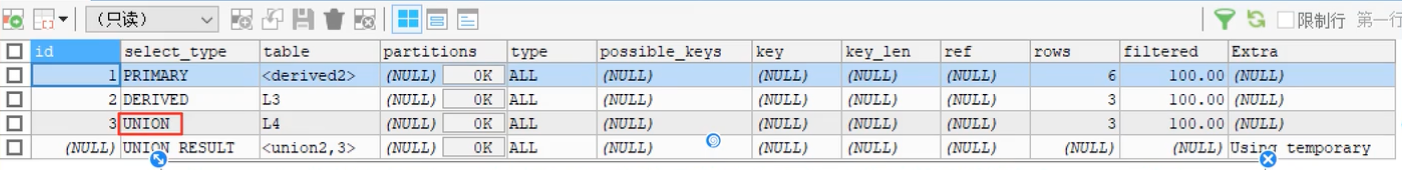
- union:union 连接的两个 select 查询,除了第一个查询被标记为 derived,第二个及以后的表的 select_type 都是 union
- derived:在 from 列表中包含的子查询被标记为 derived(派生表)
- union result:union 的结果
type字段
type字段显示的是连接类型,type描述了找到所需要的数据,所使用的【扫描方式】,是一个非常重要的指标。
– 完整的连接类型比较多
system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery >
index_subquery > range > index > ALL
– 简化之后,我们可以只关注一下几种
system > const > eq_ref > ref > range > index > ALL
一般来说,需要保证查询至少到 range 级别,最好是能到 ref,否则就证明我们的 SQL 需要进行优化调整。
type 字段值的含义:
- system:表中就仅仅只有一行数据的时候,比较少见。
- const:const 表示命中的是主键索引或者是唯一索引,表示通过索引一次就获取到对应的数据记录。
1 | EXPLAIN SELECT * FROM L1 WHERE id = 3; |
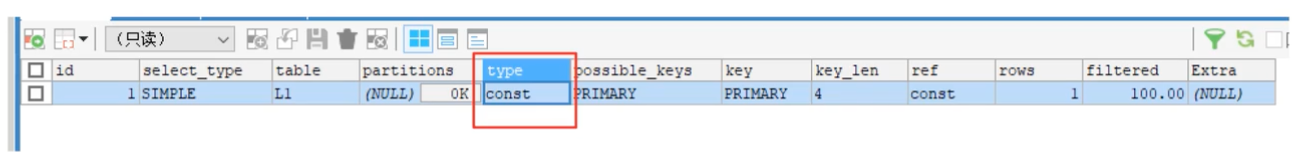
主键索引等值查询,type 为 const。
1 | -- 为L1表添加唯一索引 |
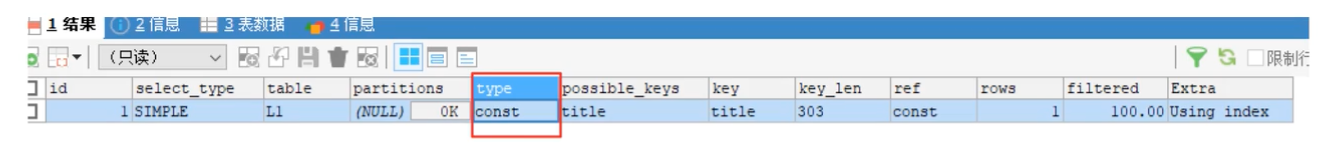
唯一索引等值查询,type 同样为 const,Extra 为 Using index。
- eq_ref:对于前一个表中的每一行,后表只有一行被扫描。只有当连表使用索引的部分都是主键或者唯一非空索引时,才会出现。
1 | -- 准备测试数据 |

user 表(u)type 为 ALL,全表扫描 4 行;user_balance 表(ub)通过主键关联,type 为 eq_ref,key 为 PRIMARY,ref 为 test_explain.u.id,对 user 表的每一行只在 user_balance 中扫描一行。
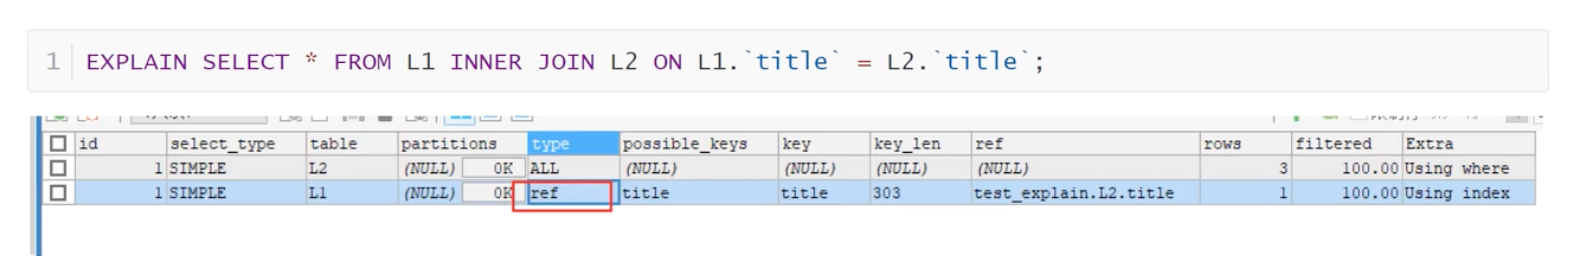
- ref:使用了普通索引(非唯一性索引),对于前表的每一行,后表有可能有多于一行的数据被扫描,会返回所有匹配某个单独值的行。
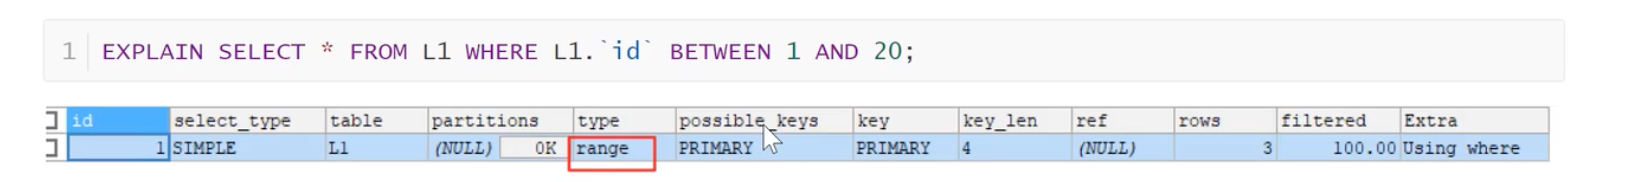
- range:索引上的范围查询,检索给定范围的行。between、in函数、>、<都是范围查询
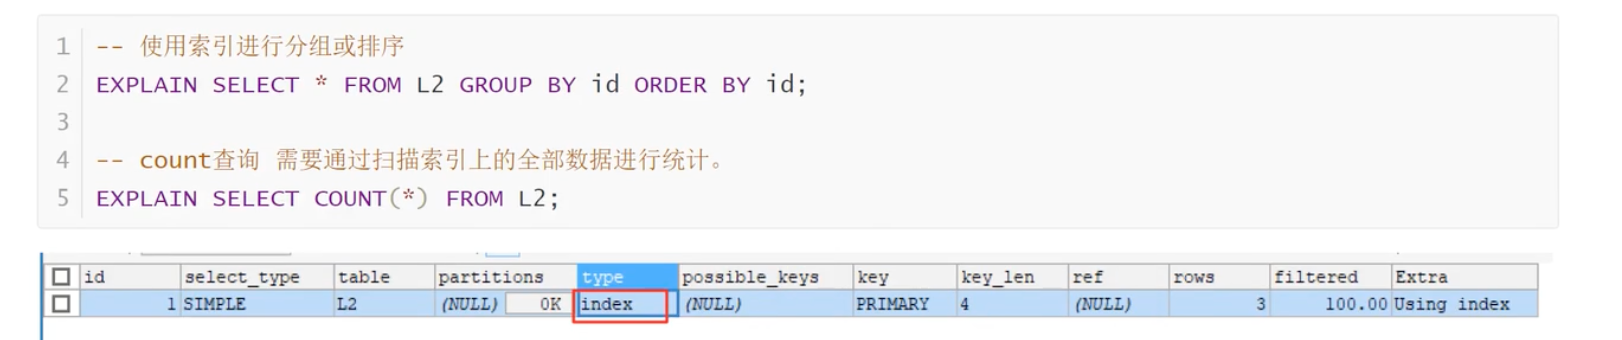
- index:出现index 表示SQL使用了索引,但是没有通过索引进行过滤。需要扫描索引上的全部数据。
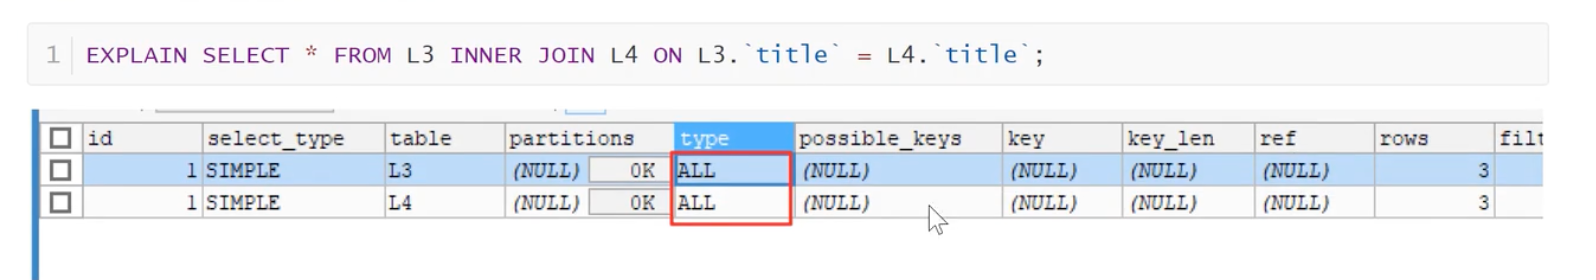
- ALL:全表扫描,没有使用索引。
type类型总结:
• system:不进行磁盘I0,查询系统表,仅仅返回一条数据
• const:查找主键索引,最多返回1或者0条数据。属于精确查找
• eq_ref:查找唯一索引,返回数据最多1条,属于精确查找
• ref:查找非唯一性索引,返回匹配某一条数据的多行记录,属于精确查找。
• range: 查找某个索引的部分索引,只检索给定范围的行级,属于范围查找。
• index:查找所有的索引树,比ALL快一些。
• ALL:不使用任何索引,直接全表扫描
possible_keys 与 key说明
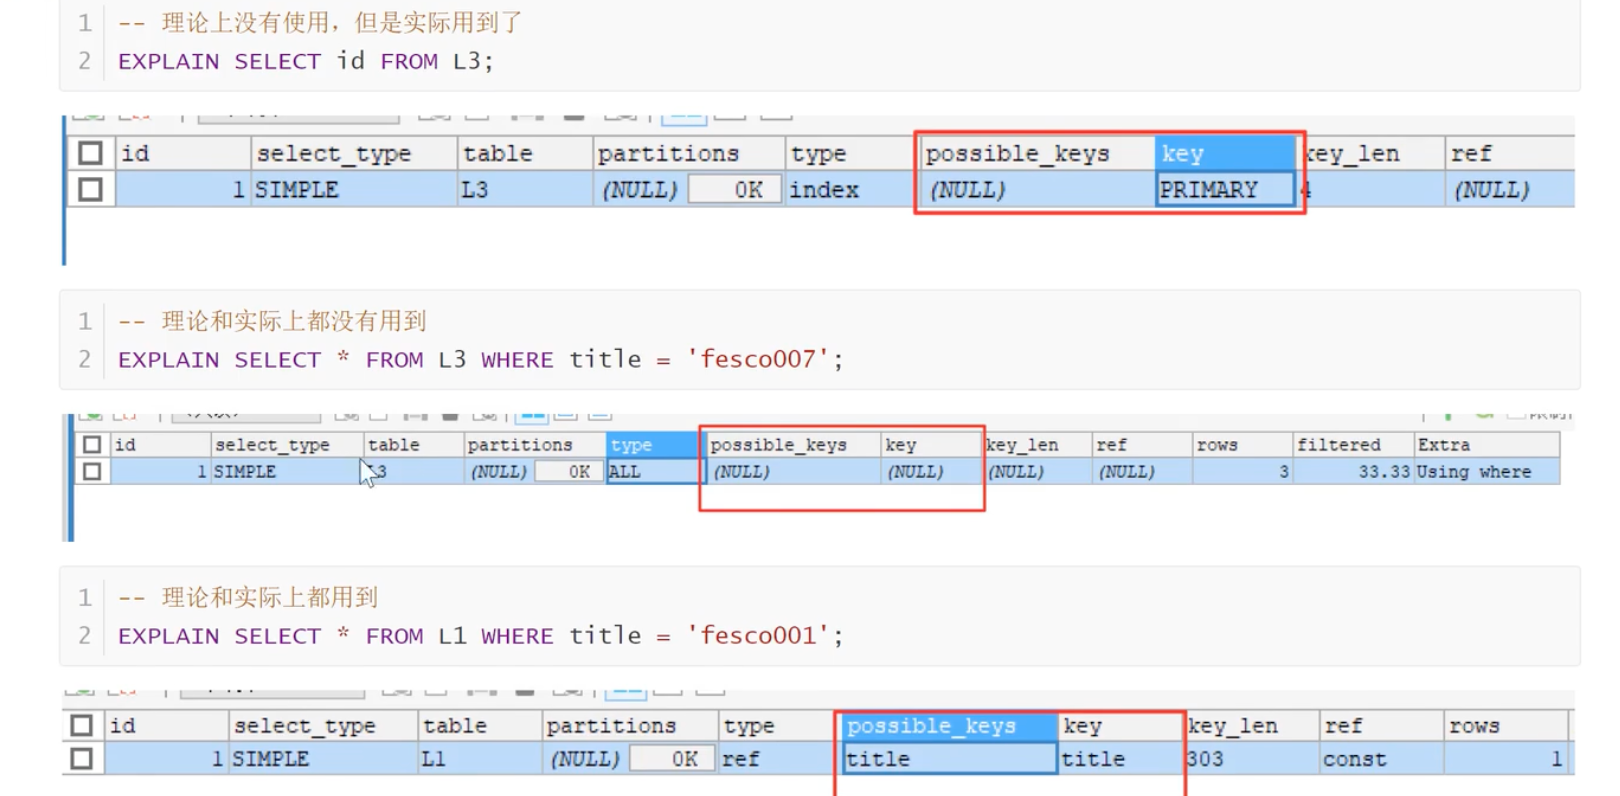
- possible_keys:显示可能应用到这张表上的索引,一个或者多个,查询涉及到的字段上如果存在索引,该索引将会被列出,但是实际查询不一定用到。
- key:实际使用的索引,若为null,则表示没有用到索引。两种可能
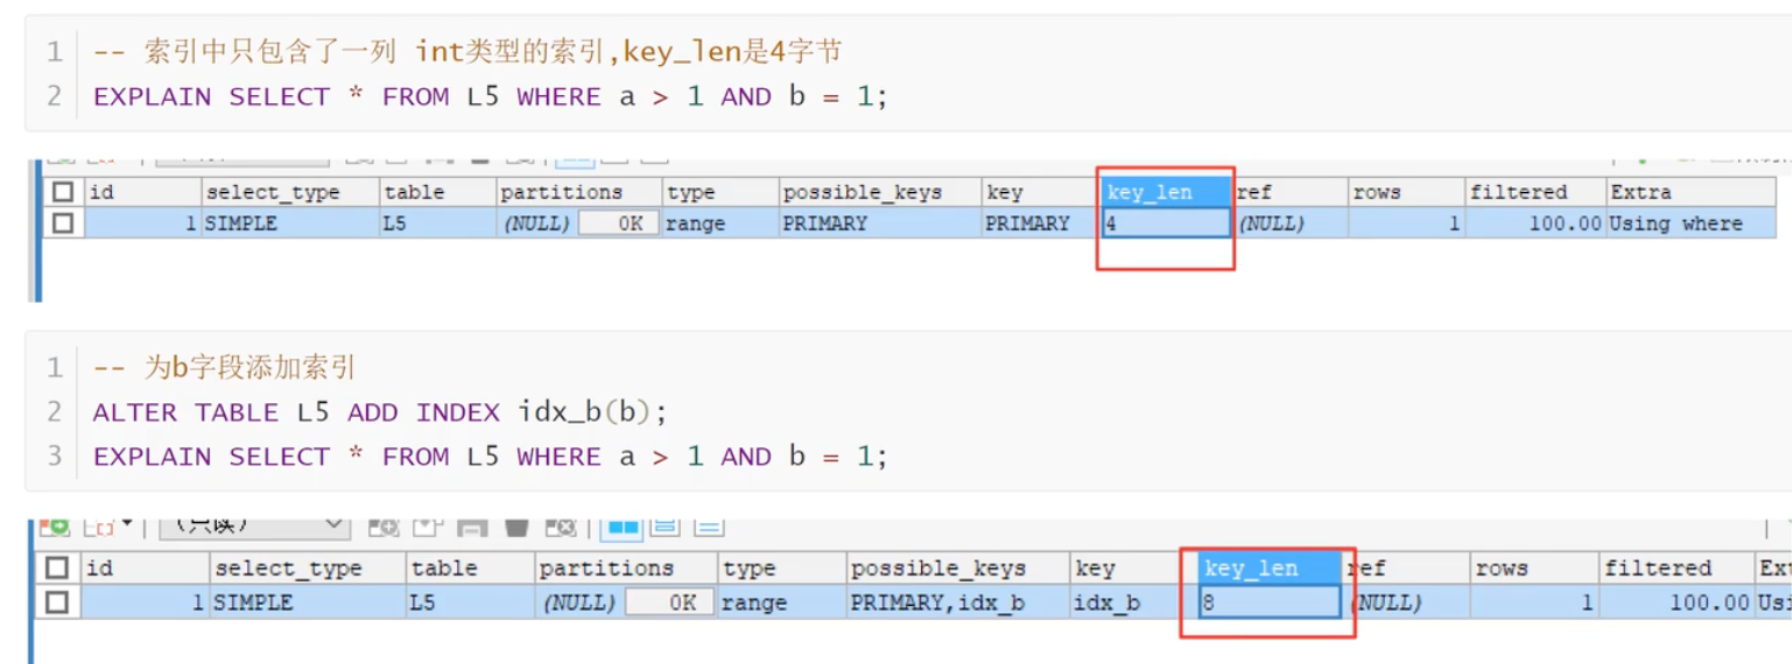
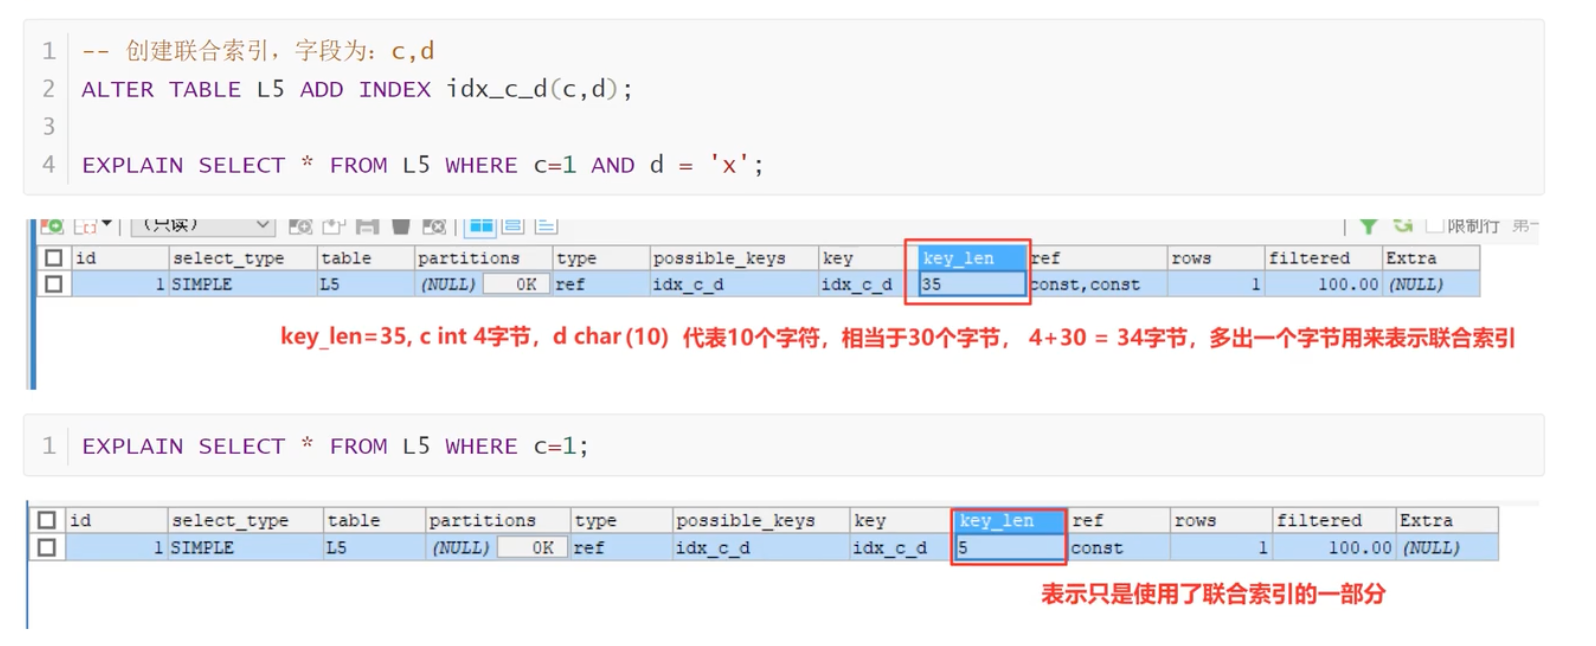
key_len:表示索引中使用的字节数,可以通过该列计算查询中使用的索引的长度。
key_len字段能够帮助你检查是否充分的利用了索引,ken_len越长,说明索引利用的越充分
1 | CREATE TABLE L5( |
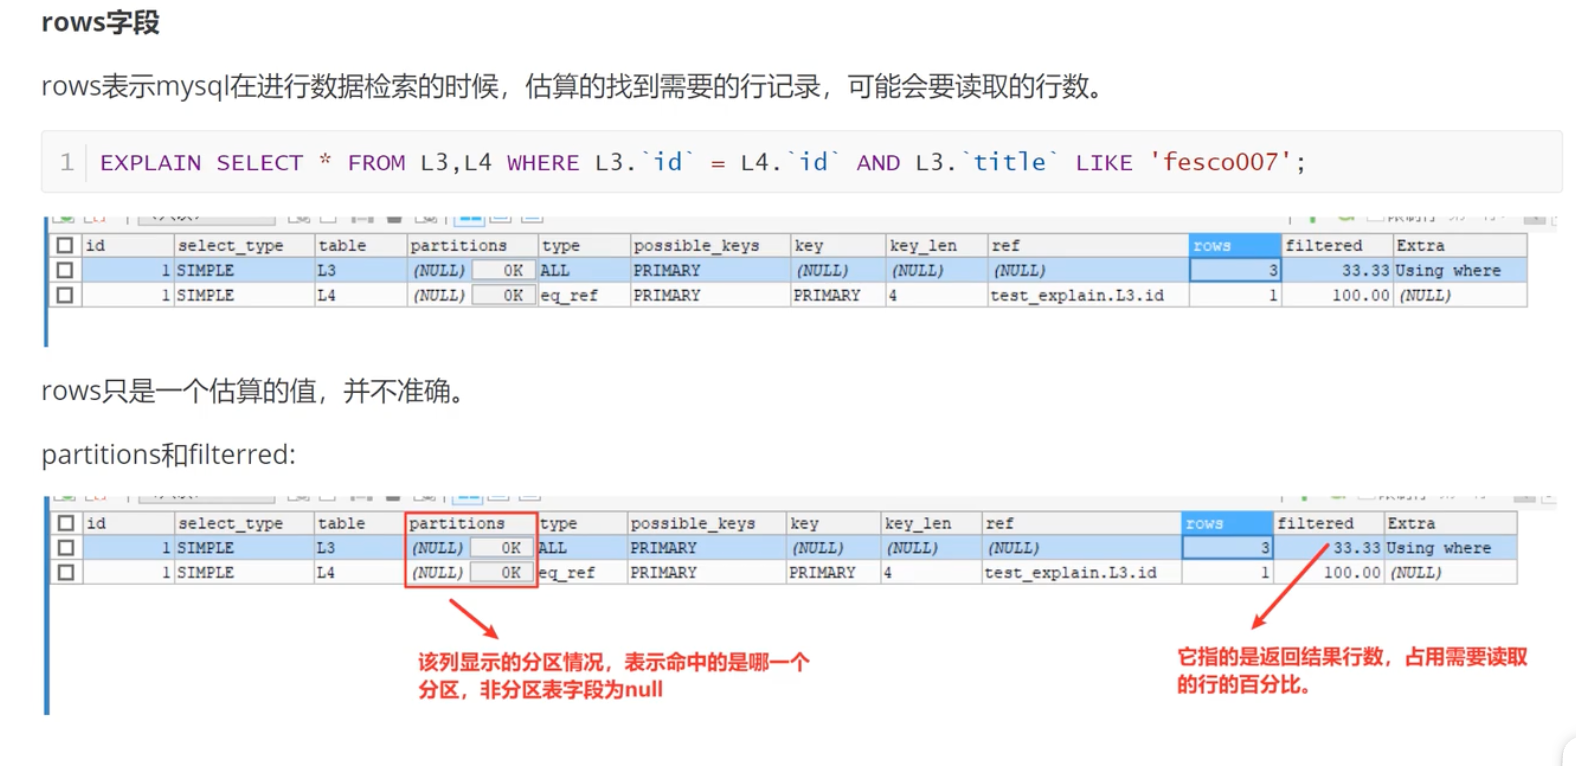
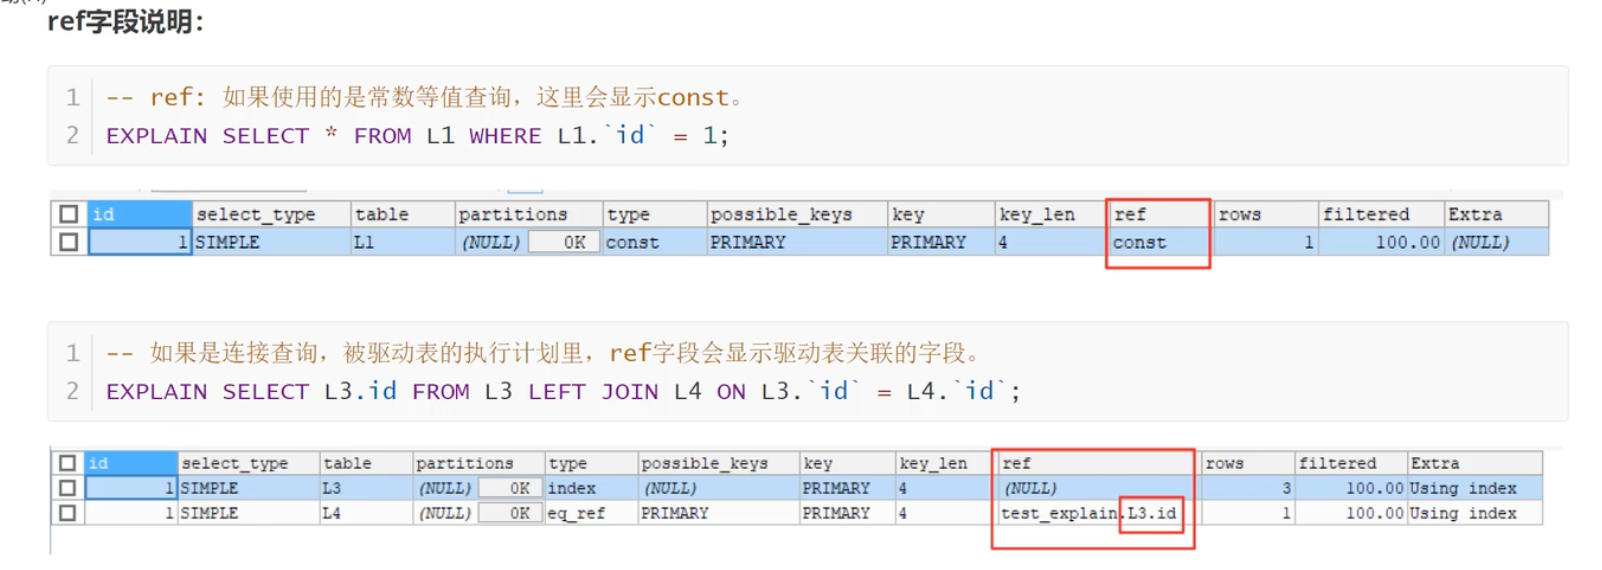
ref/rows/patition/filtered字段说明
分区/分表/分库
解决的层次不同、拆分粒度不同。可以按”从单机到分布式”的顺序来理解:分区 → 分表 → 分库,拆分力度依次增大。
一、分区(Partition)
层次:单库单表内部,逻辑上还是一张表。
做法:把一张表的数据,按某种规则(如范围、哈希、列表)拆成多个物理文件存放,但对应用来说仍然是一张表,SQL 不用改。
常见分区类型
| 类型 | 说明 | 举例 |
|---|---|---|
| RANGE 分区 | 按范围 | 按年份分区:2023、2024、2025 |
| LIST 分区 | 按枚举值 | 按地区:华北、华东、华南 |
| HASH 分区 | 按哈希取模 | HASH(id) % 4 |
| KEY 分区 | 类似 HASH,用 MySQL 内部函数 | — |
特点
- ✅ 应用无感知:SQL 不变,还是查同一张表。
- ✅ 单库内解决:不涉及多库、多实例。
- ❌ 仍受单机限制:数据量、连接数、磁盘 I/O 还是同一台机器。
- ❌ 跨分区查询可能变慢:如果 WHERE 条件没带分区键,要扫描所有分区。
适用场景
单表数据量过大(如几千万到上亿),但还没到需要拆库的程度。
二、分表(Sharding / 分表)
层次:同一个库内,把一张表拆成多张独立的表。
做法:按规则把数据分散到 orders_0、orders_1、orders_2…… 多张表里。应用需要知道数据在哪张表,或者通过中间件路由。
常见拆分方式
| 方式 | 说明 |
|---|---|
| 水平分表 | 按行拆分,每张表结构相同,数据不同 |
| 垂直分表 | 按列拆分,把不常用或大字段拆到另一张表 |
特点
- ✅ 突破单表数据量瓶颈:每张表数据变少,查询更快。
- ✅ 仍在同一个库:事务、连接还在一起,相对简单。
- ❌ 应用需要改:SQL 要改表名,或引入中间件。
- ❌ 跨表查询麻烦:
JOIN、ORDER BY、COUNT等要合并结果。 - ❌ 仍受单库限制:磁盘、连接数、CPU 还是同一台机器。
适用场景
单表数据量极大,但单库的整体压力还能承受。
三、分库(分库)
层次:把数据拆分到多个数据库实例(可能在不同机器上)。
做法:按规则把不同的表,或同一张表的不同部分,放到不同的数据库实例中。通常和分表结合,形成 “分库分表”。
常见拆分方式
| 方式 | 说明 |
|---|---|
| 垂直分库 | 按业务拆,如订单库、用户库、商品库 |
| 水平分库 | 同一张表的数据分散到多个库 |
特点
- ✅ 突破单机瓶颈:CPU、内存、磁盘、连接数都能横向扩展。
- ✅ 提升可用性:一个库挂了,其他库还能用。
- ❌ 架构复杂度高:需要处理分布式事务、跨库 JOIN、全局 ID、数据一致性。
- ❌ 运维成本高:多实例部署、监控、备份、扩容。
适用场景
单库已经扛不住,数据量、并发量都到了单机上限。
四、三者对比
| 维度 | 分区 | 分表 | 分库 |
|---|---|---|---|
| 拆分层次 | 单库单表内 | 单库内多表 | 多库多实例 |
| 应用是否感知 | 无感知 | 需改 SQL / 中间件 | 需改 SQL / 中间件 |
| 突破的瓶颈 | 单表数据量 | 单表数据量 | 单机整体性能 |
| 事务 | 本地事务 | 本地事务 | 分布式事务 |
| 跨节点 JOIN | 分区内可 | 需合并 | 很难 |
| 复杂度 | 低 | 中 | 高 |
| 典型工具 | MySQL 原生分区 | ShardingSphere、MyCat | ShardingSphere、Vitess |
五、演进顺序(推荐路径)
实际架构演进通常是:
1 | 单库单表 |
核心原则:能分区就不分表,能分表就不分库。因为每往上一层,复杂度、运维成本、开发成本都大幅上升。分库分表是最后的手段,不是首选。
六、一句话总结
- 分区:一张表在单库内拆成多个物理文件,应用无感知。
- 分表:一张表拆成多张表,还在同一个库,应用要改。
- 分库:数据拆到多个数据库实例,突破单机瓶颈,但复杂度最高。
三者是递进关系,拆分力度和复杂度依次增大,应按需选择,避免过度设计。
Extra字段说明
1 | CREATE TABLE users( |
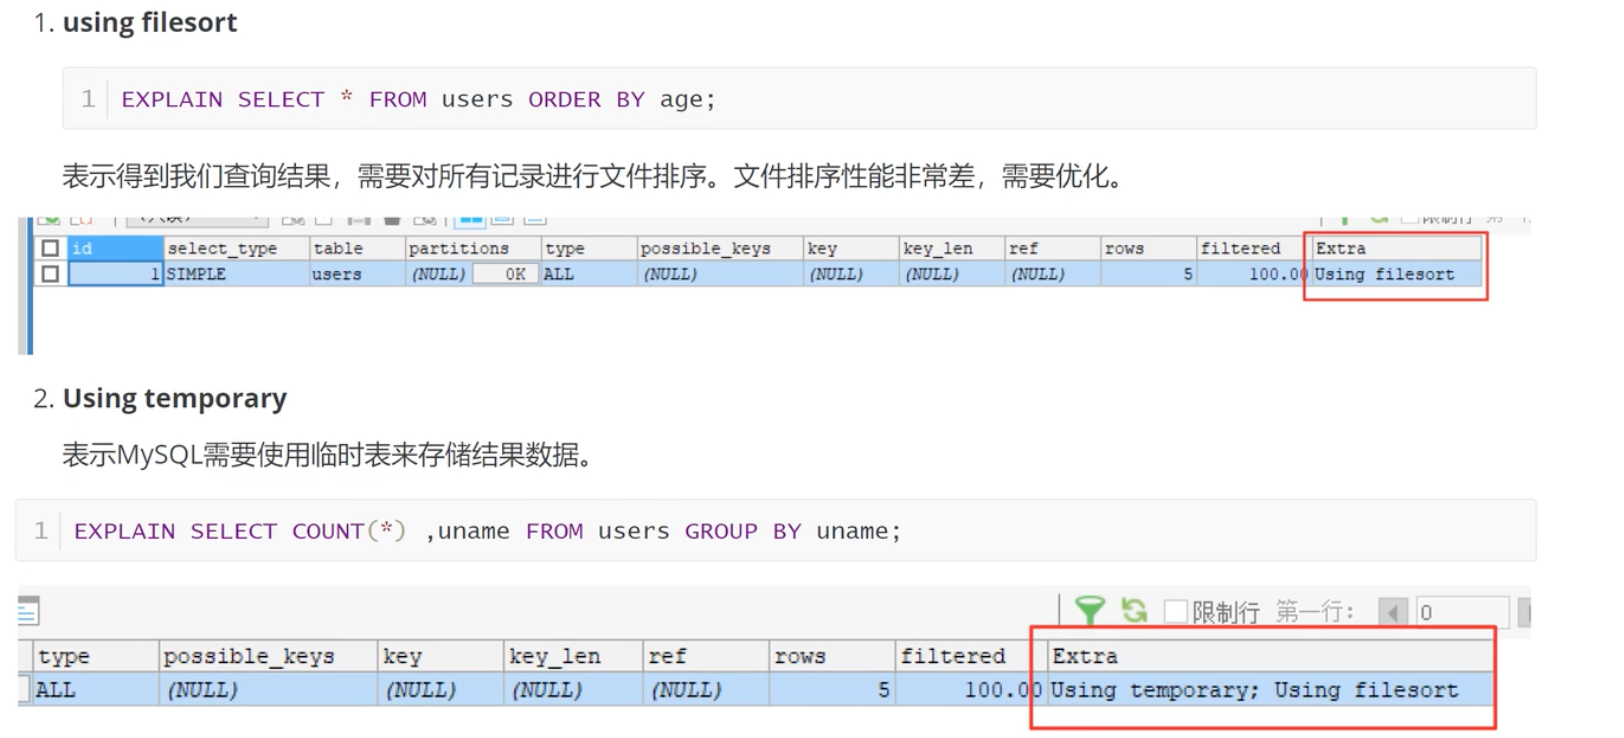
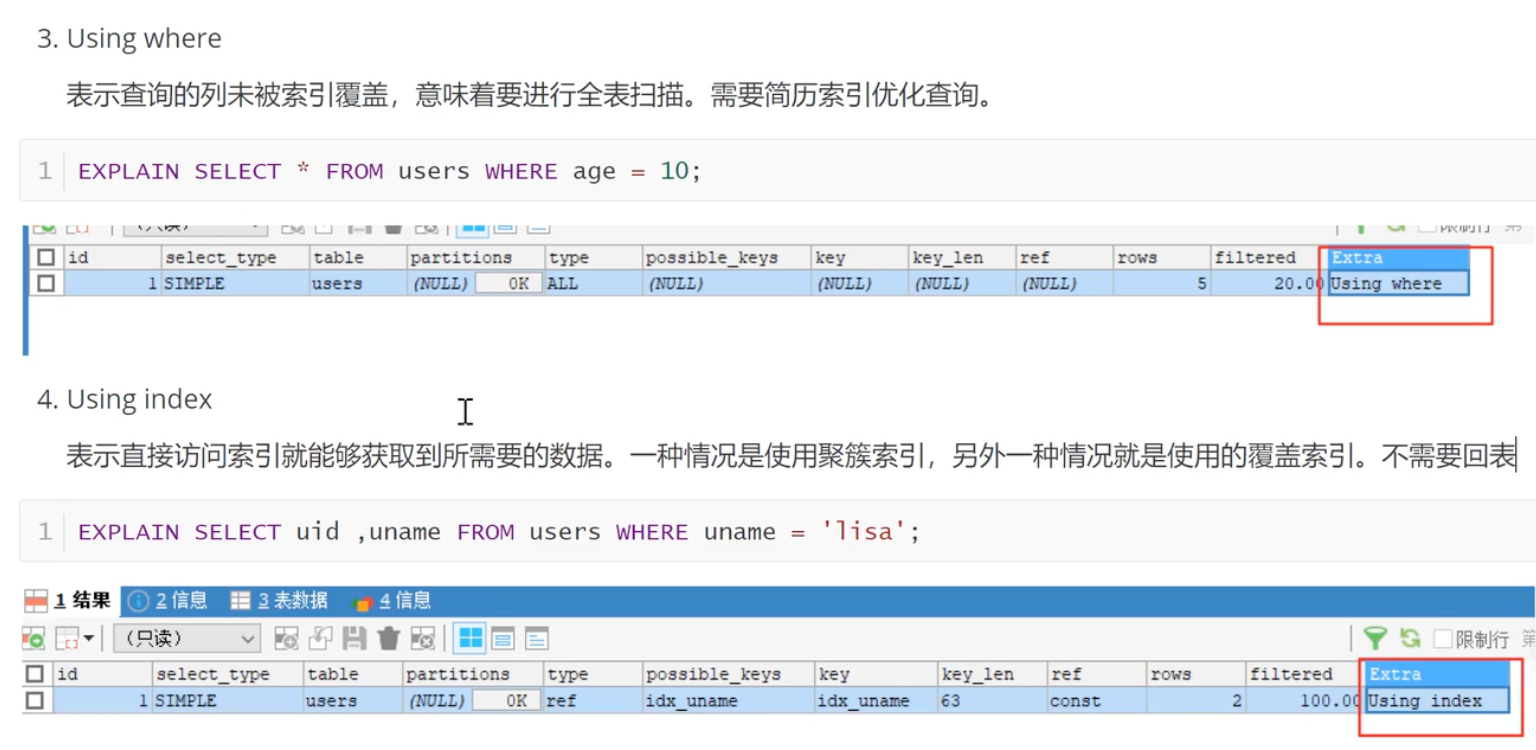
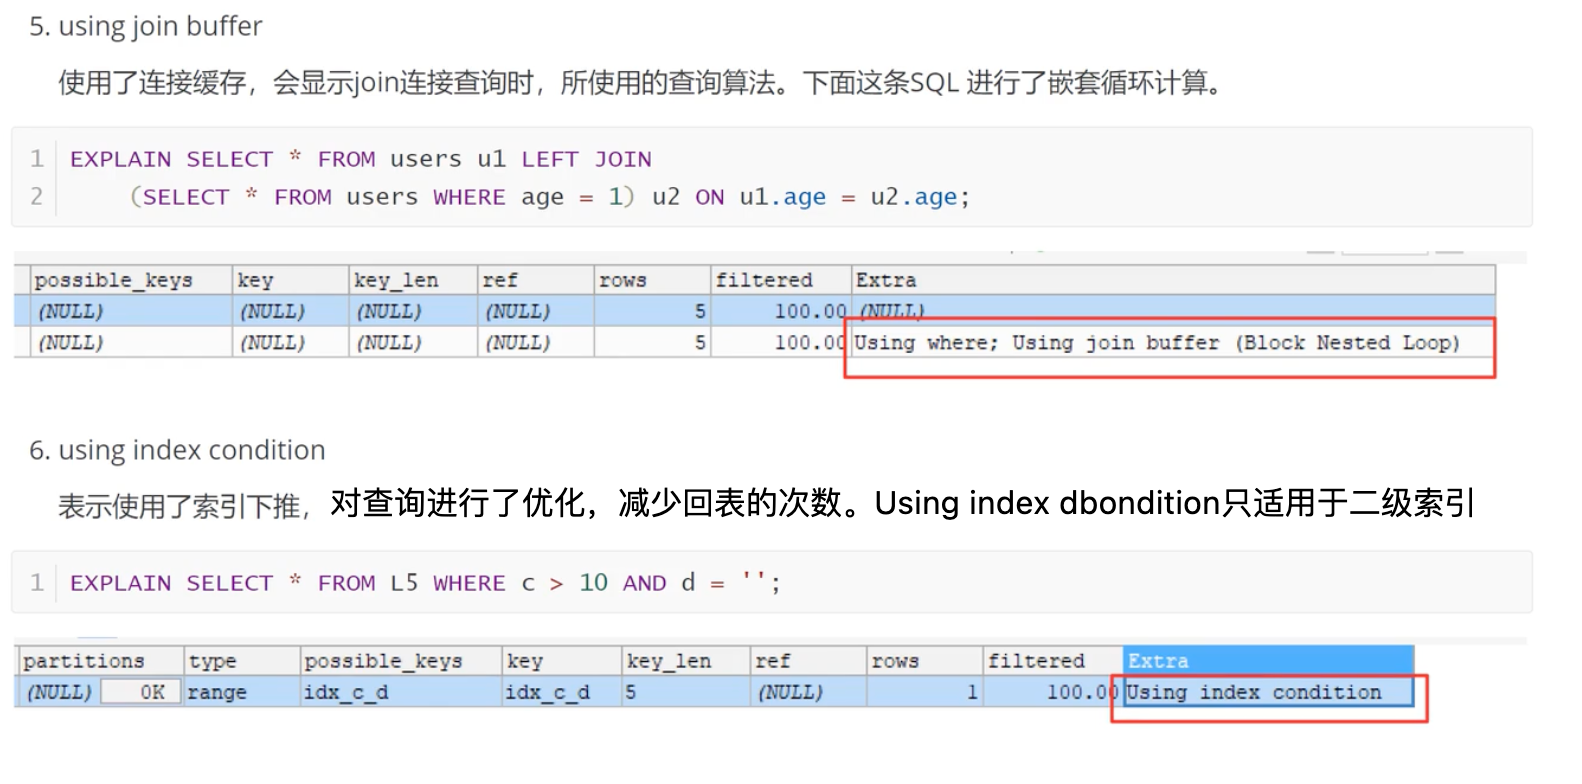
对查询进行了优化,减少回表的次数。Using index dbondition只适用于二级索引