数据库事务
什么是数据库事务
事务是一个不可分割的数据库操作序列,也是数据库并发控制的基本单位,其执行的结果将使数据库从一种一致性状态变迁到另一种一致性状态。事务是逻辑上的一组操作,要么全部执行,要么全部不执行。
事务的四大特性(ACID)
- 原子性(Atomicity):事务是最小的执行单位,不允许分割。事务的原子性确保动作要么全部完成,要么完全不起作用。
- 一致性(Consistency):执行事务前后,数据保持一致,多个事务对同一个数据读取的结果是相同的。
- 隔离性(Isolation):并发访问数据库时,一个用户的事务不被其他事务所干扰,各并发事务之间数据库是独立的。
- 持久性(Durability):一个事务被提交之后,它对数据库中数据的改变是持久的,即使数据库发生故障也不应该对其有任何影响。
SQL 标准定义的四个隔离级别
- Read Uncommitted(读取未提交):最低的隔离级别,允许读取尚未提交的数据变更,可能会导致脏读、幻读或不可重复读。
- Read Committed(读取已提交):允许读取并发事务已经提交的数据,可以阻止脏读,但是幻读或不可重复读仍有可能发生。
- Repeatable Read(可重复读):对同一字段的多次读取结果都是一致的,除非数据是被本身事务自己所修改,可以阻止脏读和不可重复读,但幻读仍有可能发生。
- Serializable(可串行化):最高的隔离级别,完全服从 ACID 的隔离级别。所有的事务依次逐个执行,这样事务之间就完全不可能产生干扰,也就是说,该级别可以防止脏读、不可重复读以及幻读。
什么是脏读?幻读?不可重复读?
- 脏读(Dirty Read):某个事务已更新一份数据,另一个事务在此时读取了同一份数据,由于某些原因,前一个事务 RollBack 了操作,则后一个事务所读取的数据就会是不正确的。
- 不可重复读(Non-repeatable read):在一个事务的两次查询之中数据不一致,这可能是两次查询过程中间插入了一个事务更新原有的数据。
- 幻读(Phantom Read):在一个事务的两次查询中数据笔数不一致,例如有一个事务查询了几行(Row)数据,而另一个事务却在此时插入了新的几行数据,先前的事务在接下来的查询中,就会发现有几行数据是它先前所没有的。
各个事务隔离级别对脏读、不可重复读、幻读的支持情况
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| READ-UNCOMMITTED | √ | √ | √ |
| READ-COMMITTED | × | √ | √ |
| REPEATABLE-READ | × | × | √ |
| SERIALIZABLE | × | × | × |
事务冲突与解决
数据竞争冲突场景与解决
ACID DB
一种写入数据库的方式
ACID DB Transactions:
Atomicity:
All writes succeed or none of them do
Jondan - $10, Loriaa Keef +$10
数据一致性,有¥10 支付,肯定要有¥10 收入Consistency:
All fails occur gracefully, no invariants are broke
eg.
Need at least one officer on shift
Delek“Lomy’and write “Osscur”
Failuer in the mildle? Now no security guard
数据发生故障时,能够优雅方式处理故障Isolation:
Appears if all transations are executed independently of each other,
No race conditions
所有交易操作都独立进行,不存在并发竞争关系
并发竞争关系
eg. 两个线程同时对数据库同一数据原值0 进行+1操作,由于两次读取时,都是读到的是数据0,+1 操作完落库的结果是1,虽然应该加两次Durability:
comitted writes, don’t get lost data on disk
Atomicity, Consistency, Durability 都能通过预写日志(write ahead log)实现,
Isolation is hard and slow
read committed Isolation
当multi读写任务几乎同时发送到数据库,时间上差不多处于同一时期,no way to know exact order, 无法保证操作结果合法性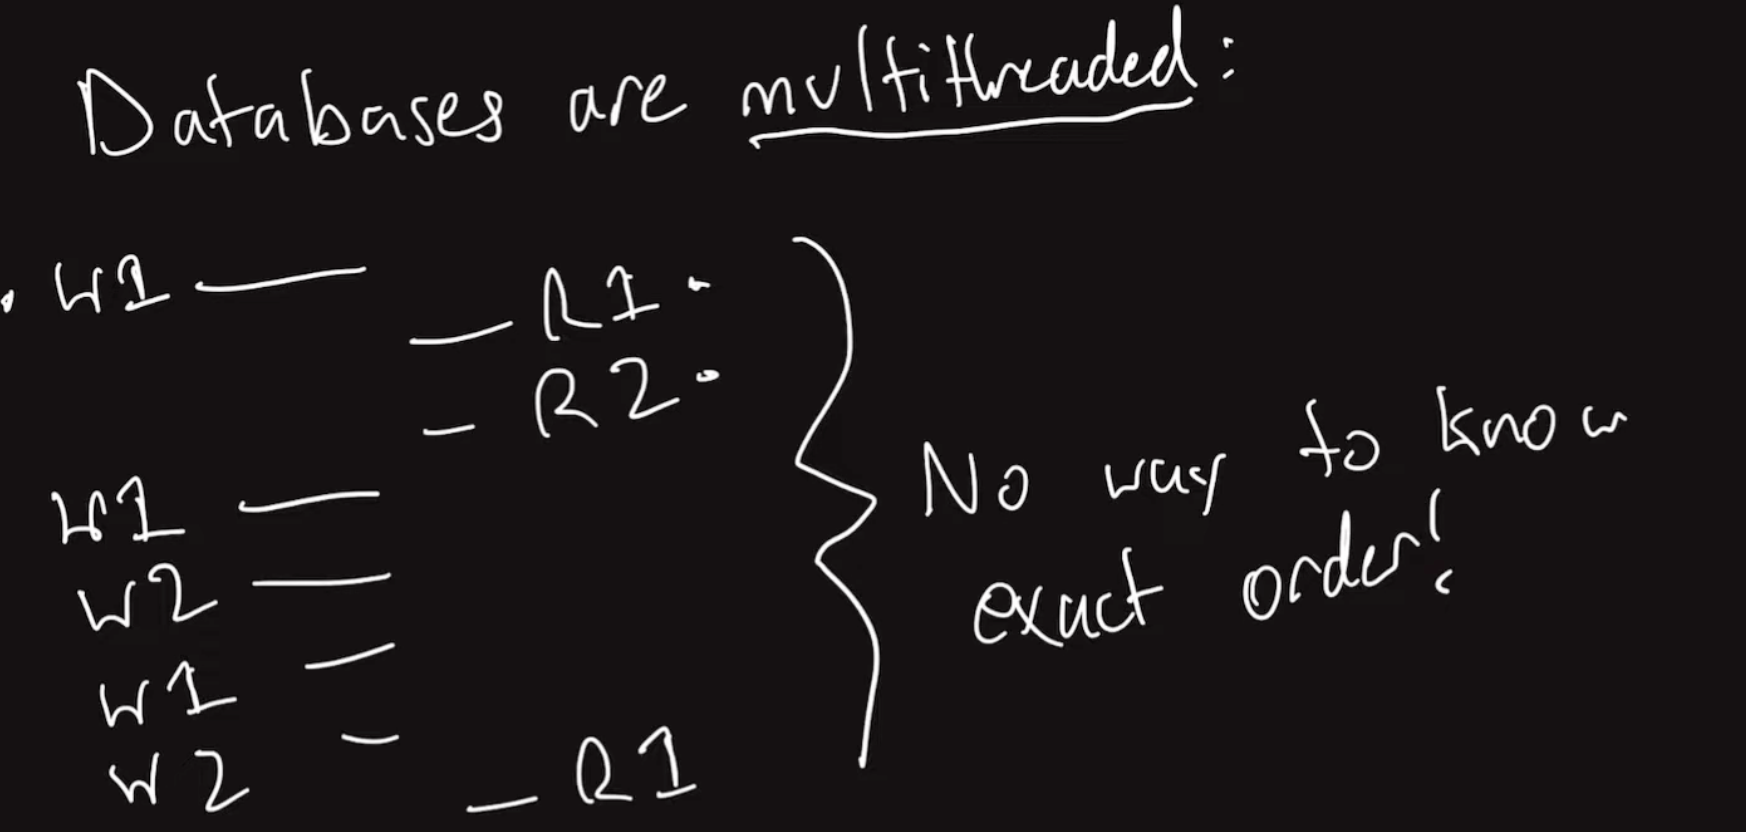
commit : a write state, only happens when all are finished
在数据库中所有操作都是完成态
dirty writes
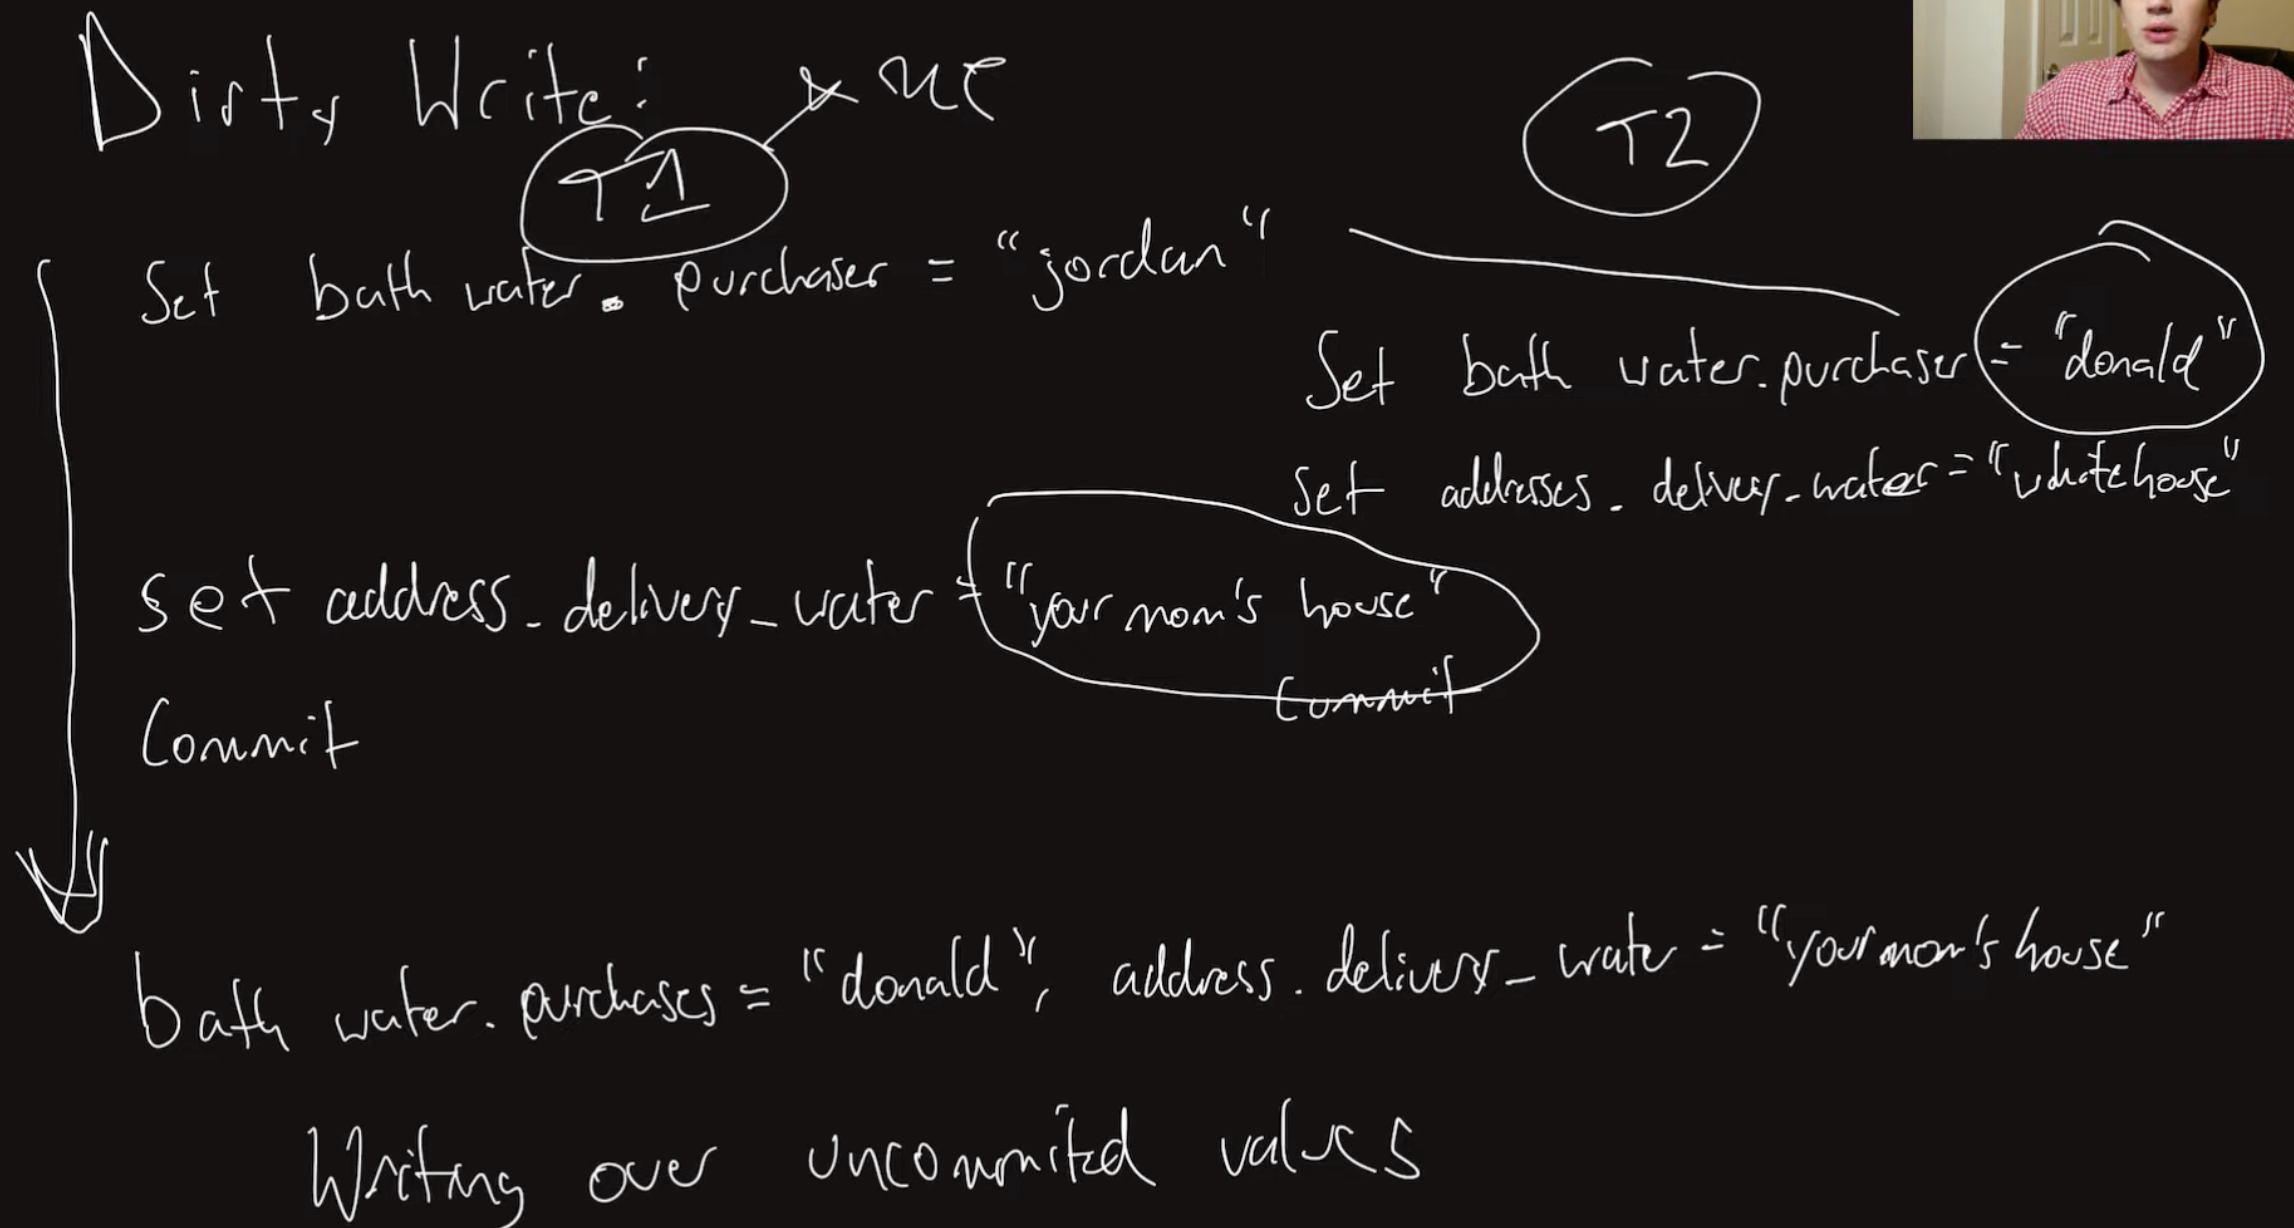
对于相同数据的写操作同时由不同的用户发起,二者写的内容不同,任务顺序不可控,可能会导致最后结果不符合双方预期
解决办法: row level locks(grab rows in same order)
通过加锁机制,处于写入执行过程中的数据被保护起来,不再穿插执行其他用户任务,执行完一整套操作,再执行下一套操作,保证数据准确性
dirty reads
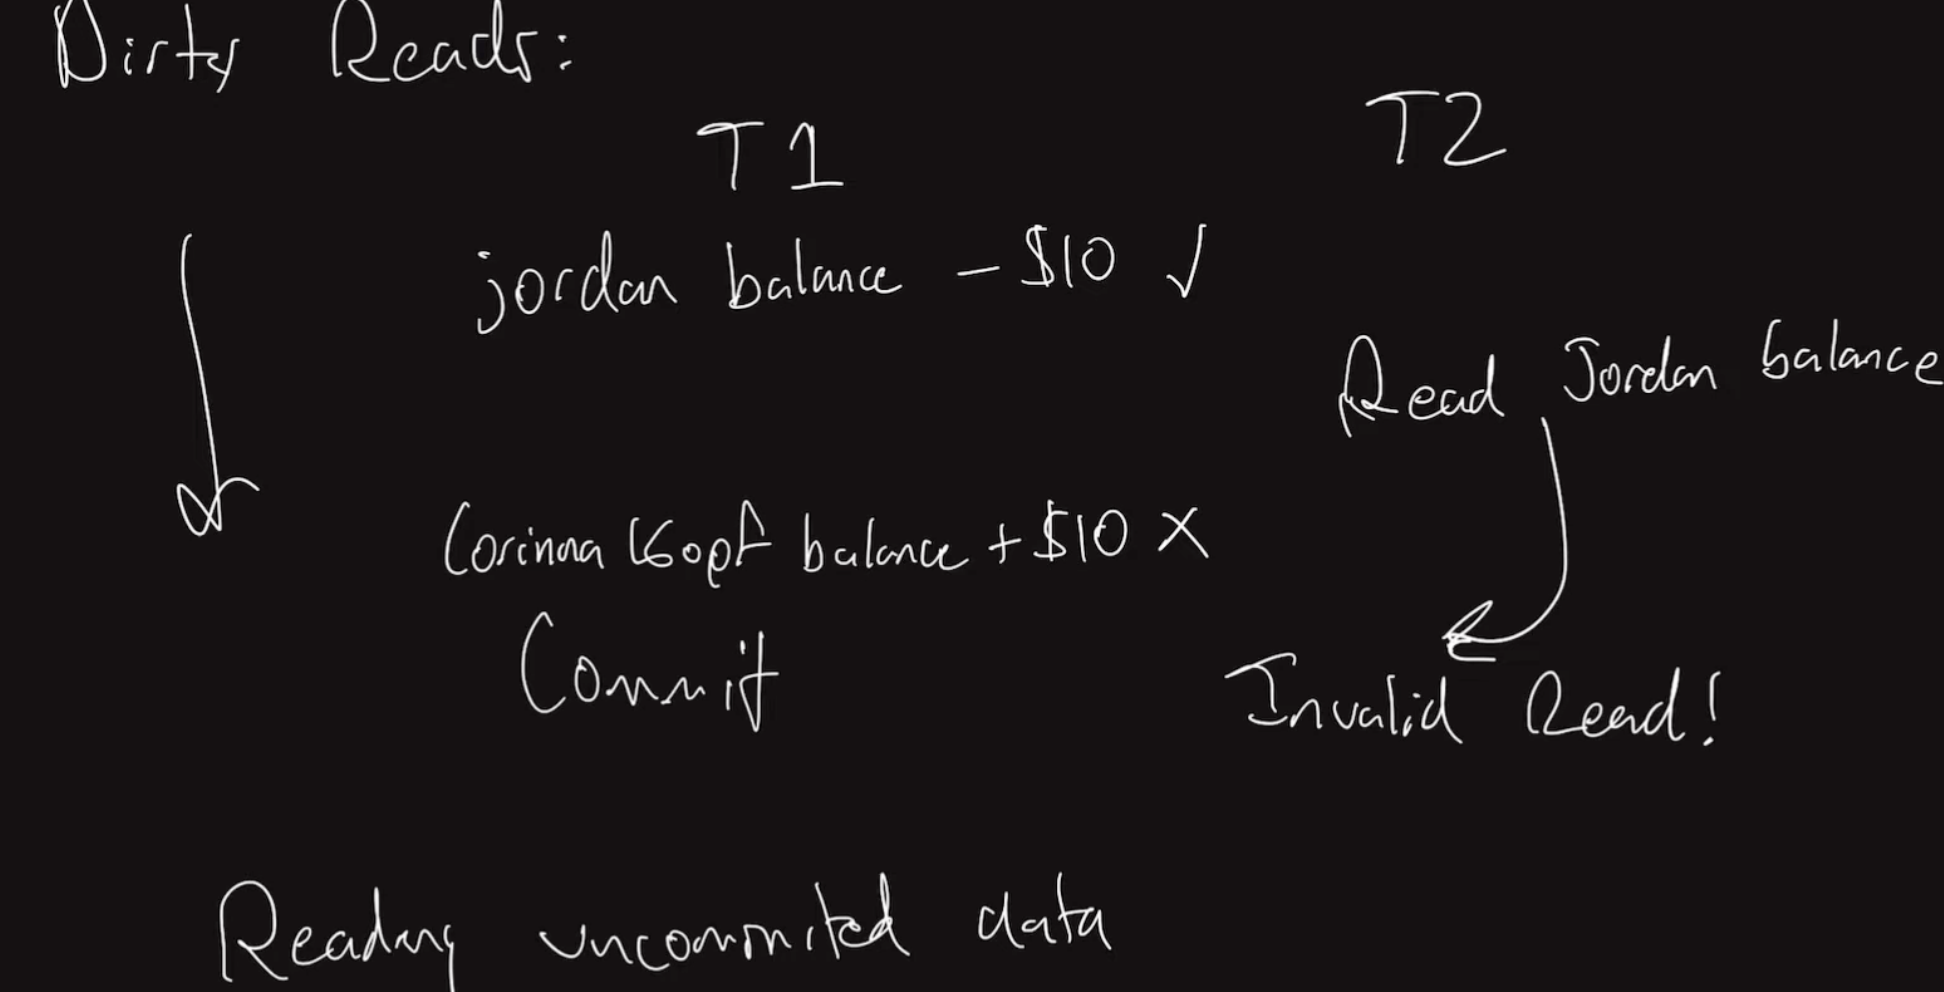
对于上图中操作,当t1 corina 收入+10 的操作没有commit 的时候,T2 打算读取corina 收入+10 之后的余额时,可能由于账户消除等原因导致读取异常
解决办法:也可以用锁,但是锁的成本太高
这里可以采用存储老数据直到commit 的时候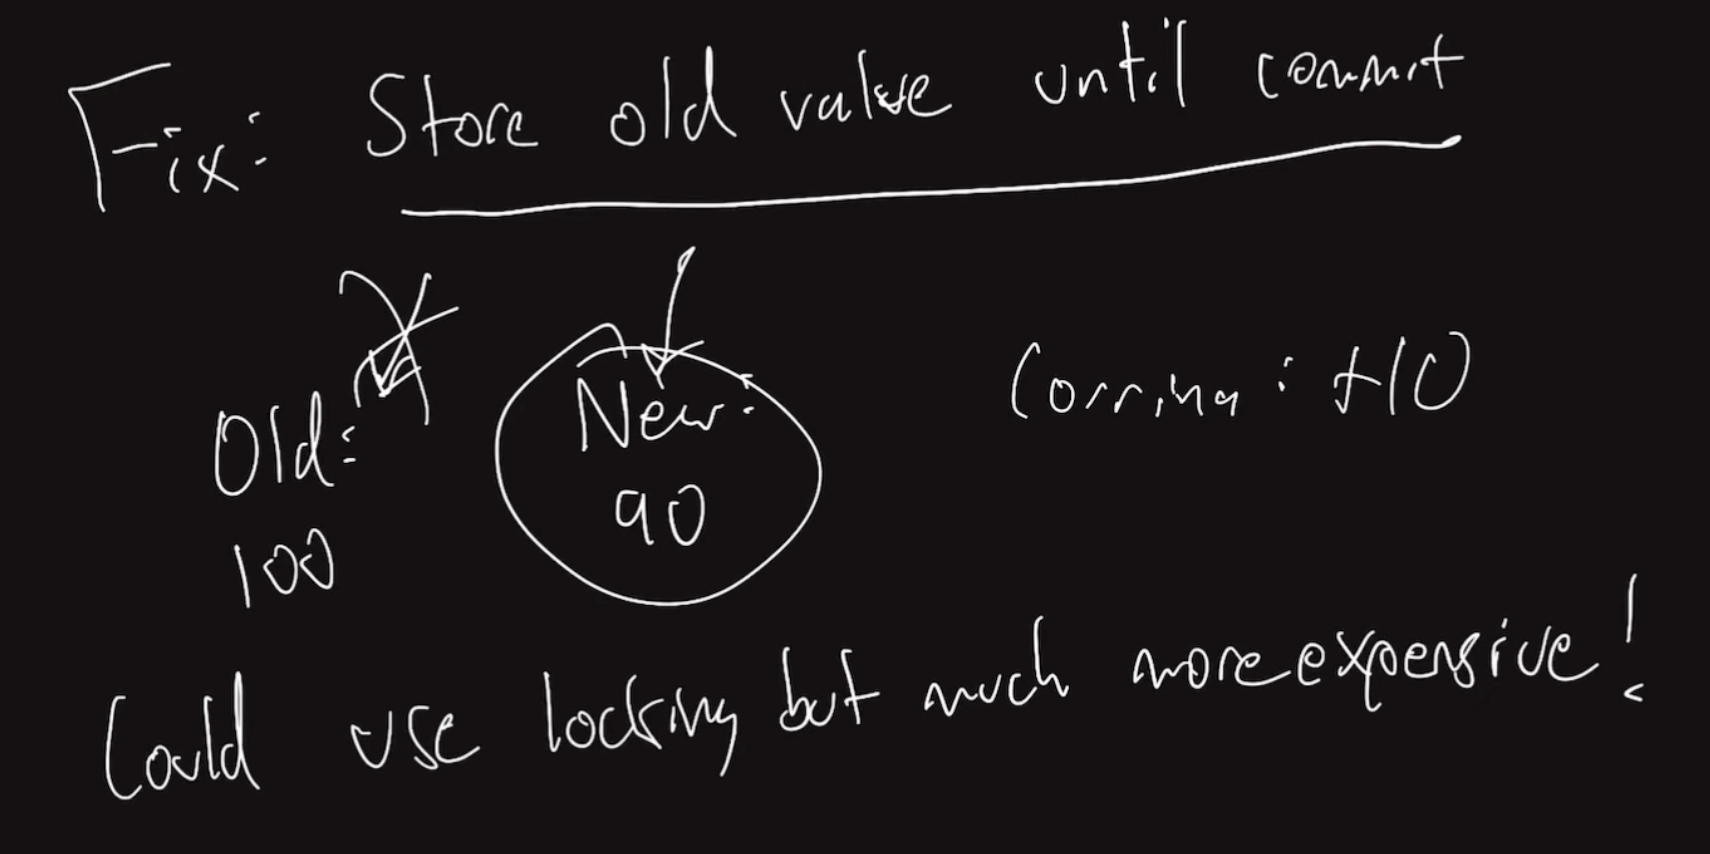
现在余额是100,old 指针指向100, 花10元后新值是90,new 指针指向90
现在收入+10
将old指针从100 改到90 ,再计算, 这样即使commit 没有完成,也能将old data 给出去
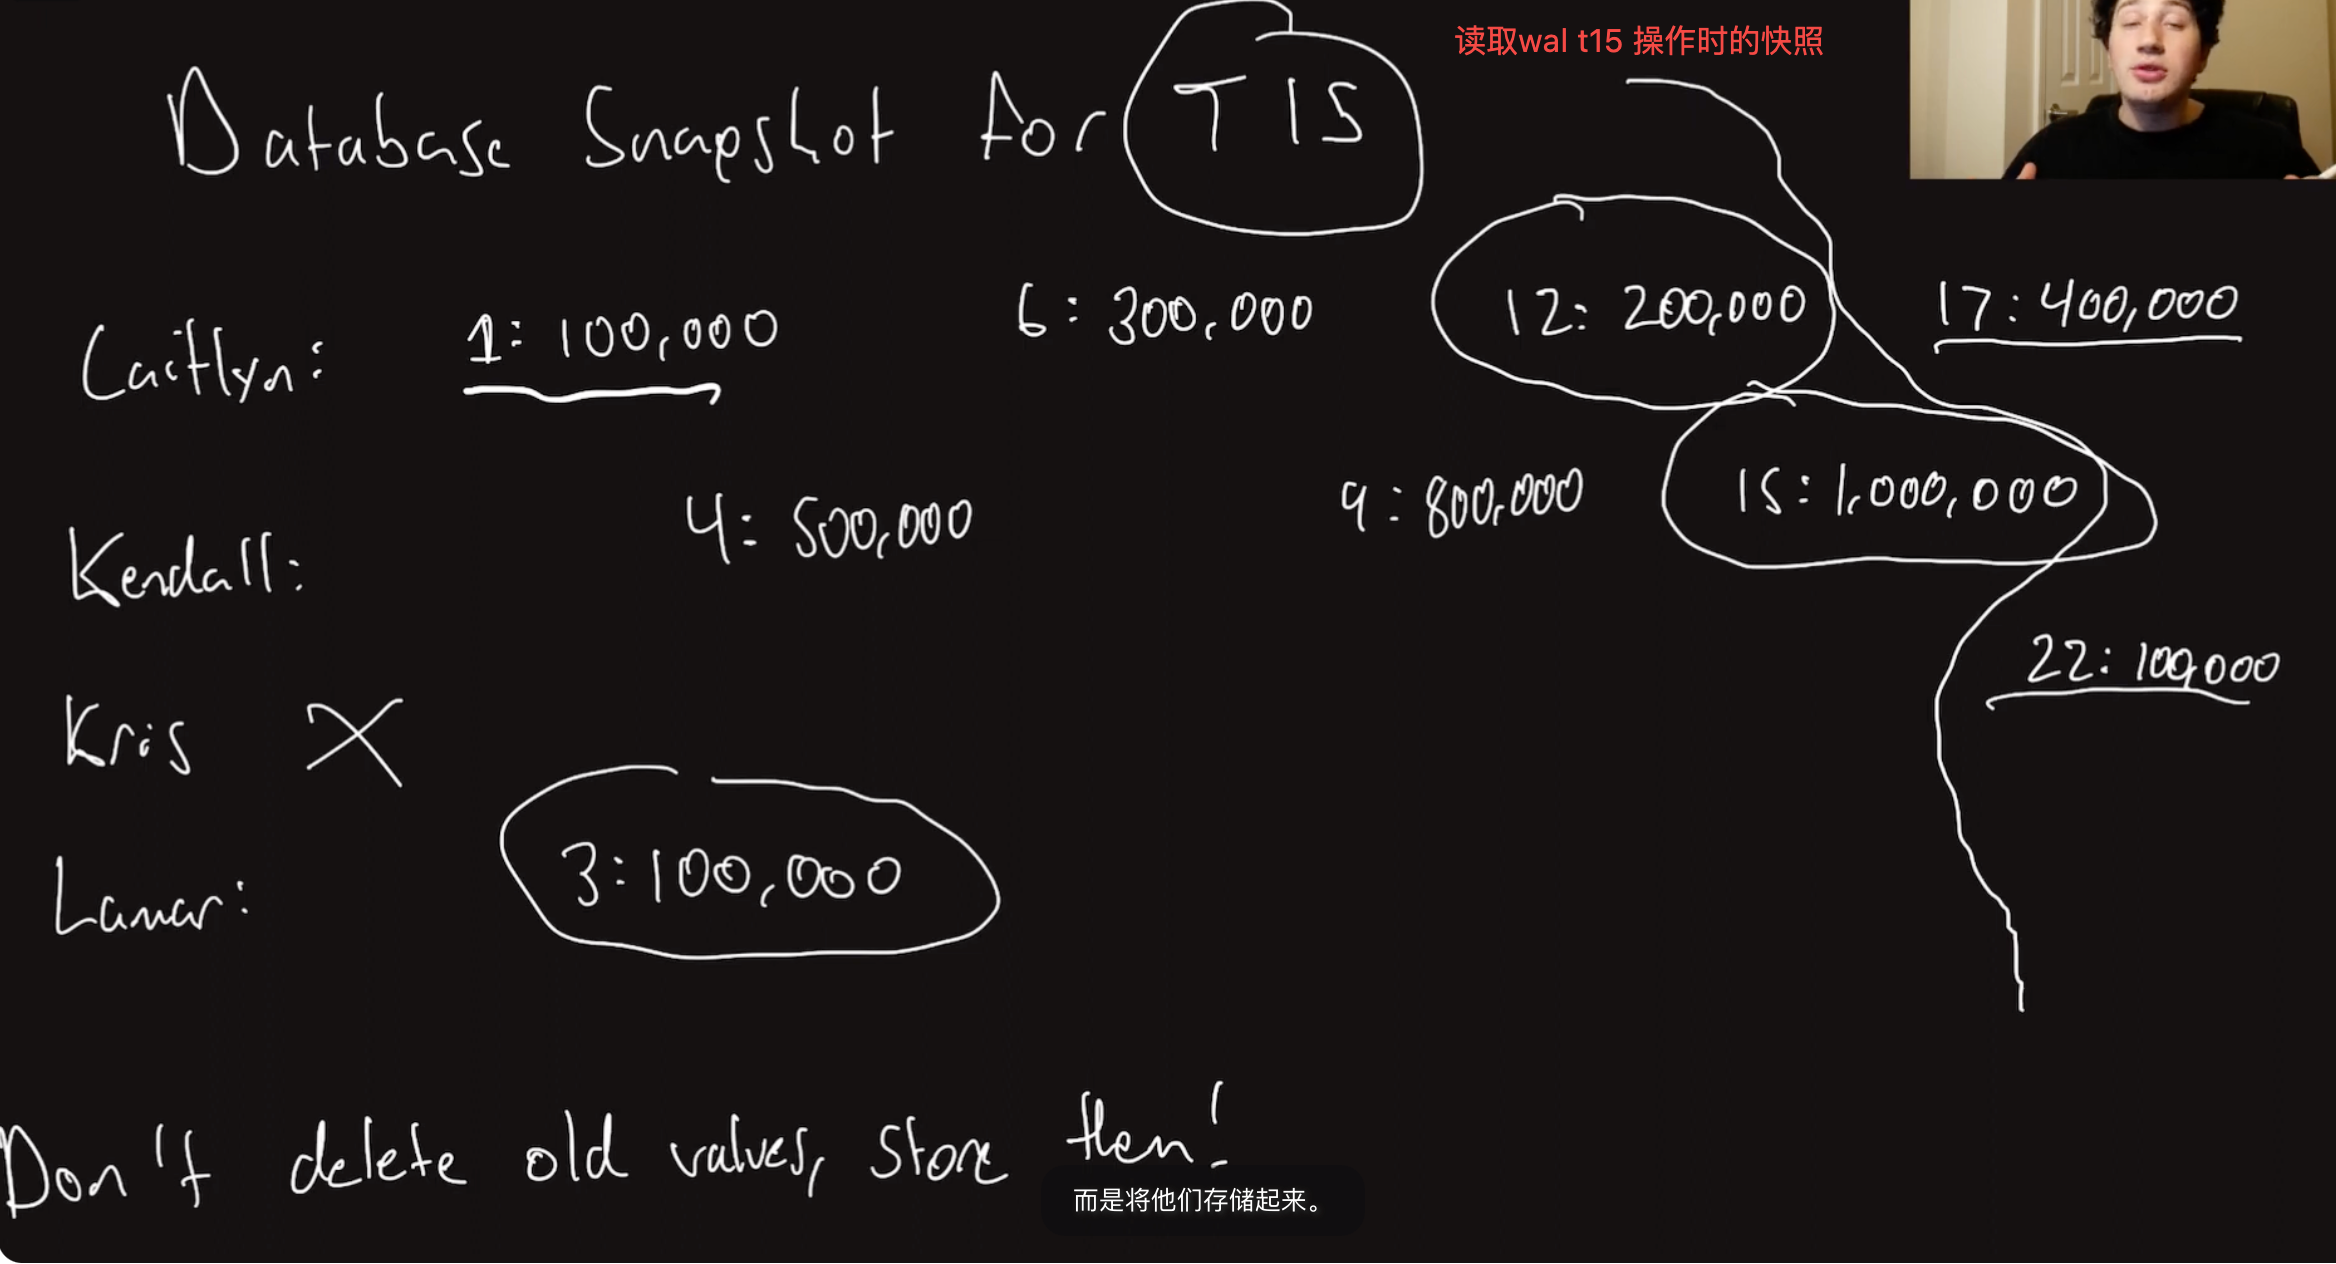
snapshot isolation
用来解决并发事务之间的读写冲突(一个事务正在读某条数据,同时另一个并发事务正在修改这条数据。)
读事务不要去读“当前正在被修改的数据”,而是读事务开始时的一个快照。
实现写不会阻塞读,读也不会读到未提交的写。
如果用锁,写过程在commit 之后读才能去读,造成阻塞
repeatable read
- Non-repeatable Read 不可重复读/ Read Committed : 同一个事务里,前后两次读取同一条数据,结果不一样。
eg.
- t1 读a = 30; t1 还没commit 时,t2 修改 a = 40 ;t1 再读 a= 40
- 数据库中所有数据原始相加为100,000, 现在依次读取单个数据所有值,但在读取过程中,还没有commit,中间某个数据K发生变化,由10,000变成0,少的10,000 添加到已读的某个数据C上,这样就会导致最终K 读到0 ,最终所有数据相加比100,000 少10,000,但实际上总和咩有变
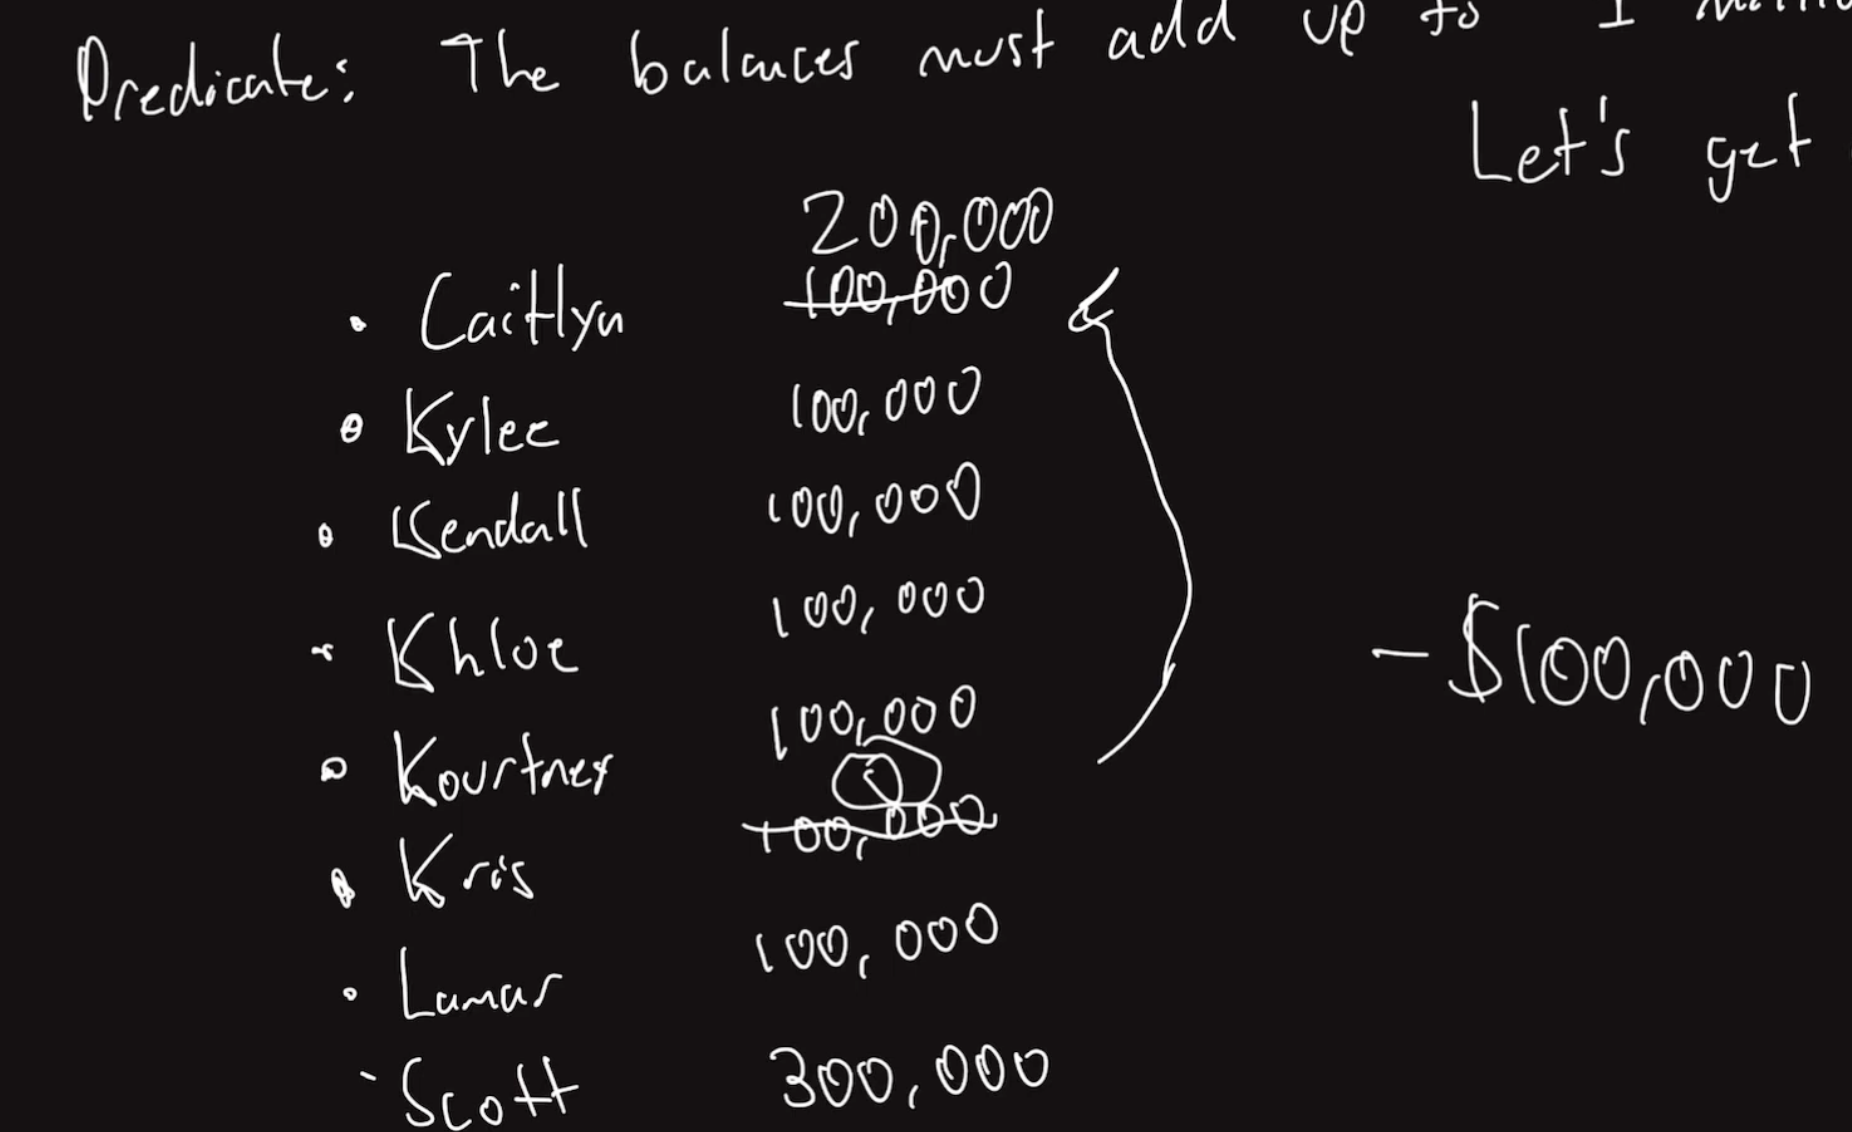
- Repeatable Read 可重复读: 同一个事务里,你第一次读到某条数据之后,即使其他事务把它修改并提交,你再次读取这条数据,仍然得到第一次读到的结果。
eg. t1 读a = 30; t1 还没commit 时,t2 修改 a = 40 ;t1 再读 a= 30
加锁实现有阻塞
T1 第一次读 → 20
T2 修改 → 等待
T1 第二次读 → 20
T1 COMMIT
T2 才能修改
使用snapshot
T1 第一次读, 创建快照 → 读快照 ->20
T2 修改
T1 第二次读 → 读之前快照 20
write skew
两个事务各自读取到一个一致的快照,然后分别修改不同的数据,最后两个事务都成功提交,但合起来违反了业务规则。
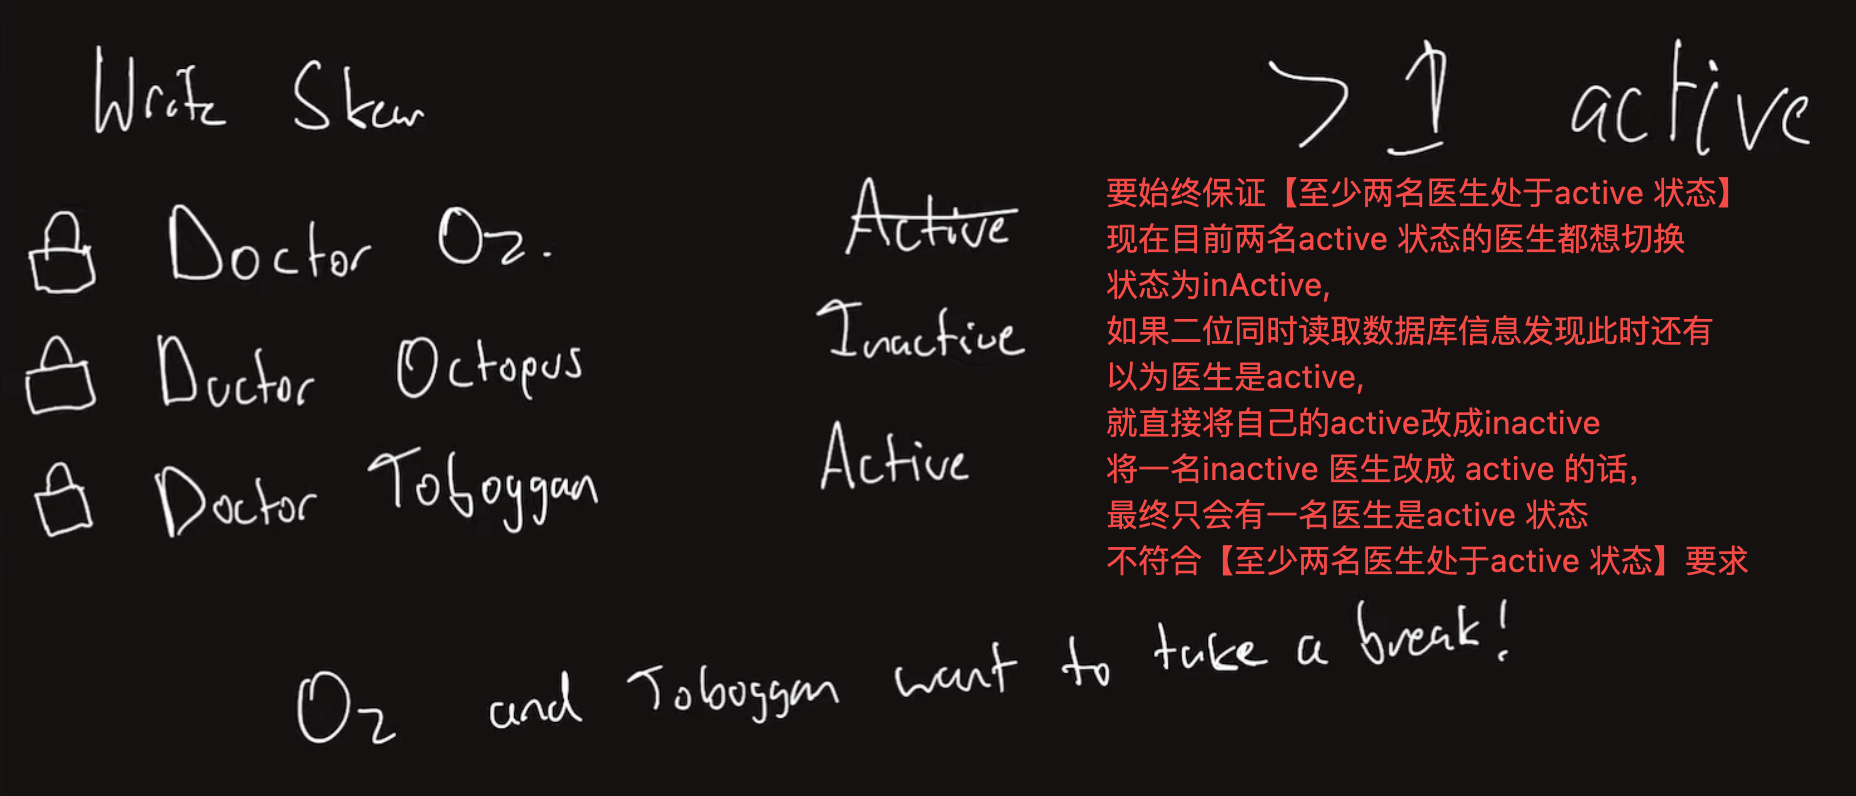
Note: Before setting themselves to inactive, each doctor must first scan the database to check if there is at least one other active doctor
When they both do these reads it looks like there is another doctor active and they both set their statuses to inactive
Because we’re not grabbing the locks of both doctors, each can perform the read
and then write successfully at the same time, thus breaking the invariant
解决方案:写入时将其他active 状态的rows 进行行锁,即更改一个active 后才能更改下一个
对于同时修改的情况,谁先grab 更多的行锁,谁就能先进项写入
If I’m holding the locks of all of the rows that I read, I know that my predicate statement (”there is another active doctor”) will remain true when I write
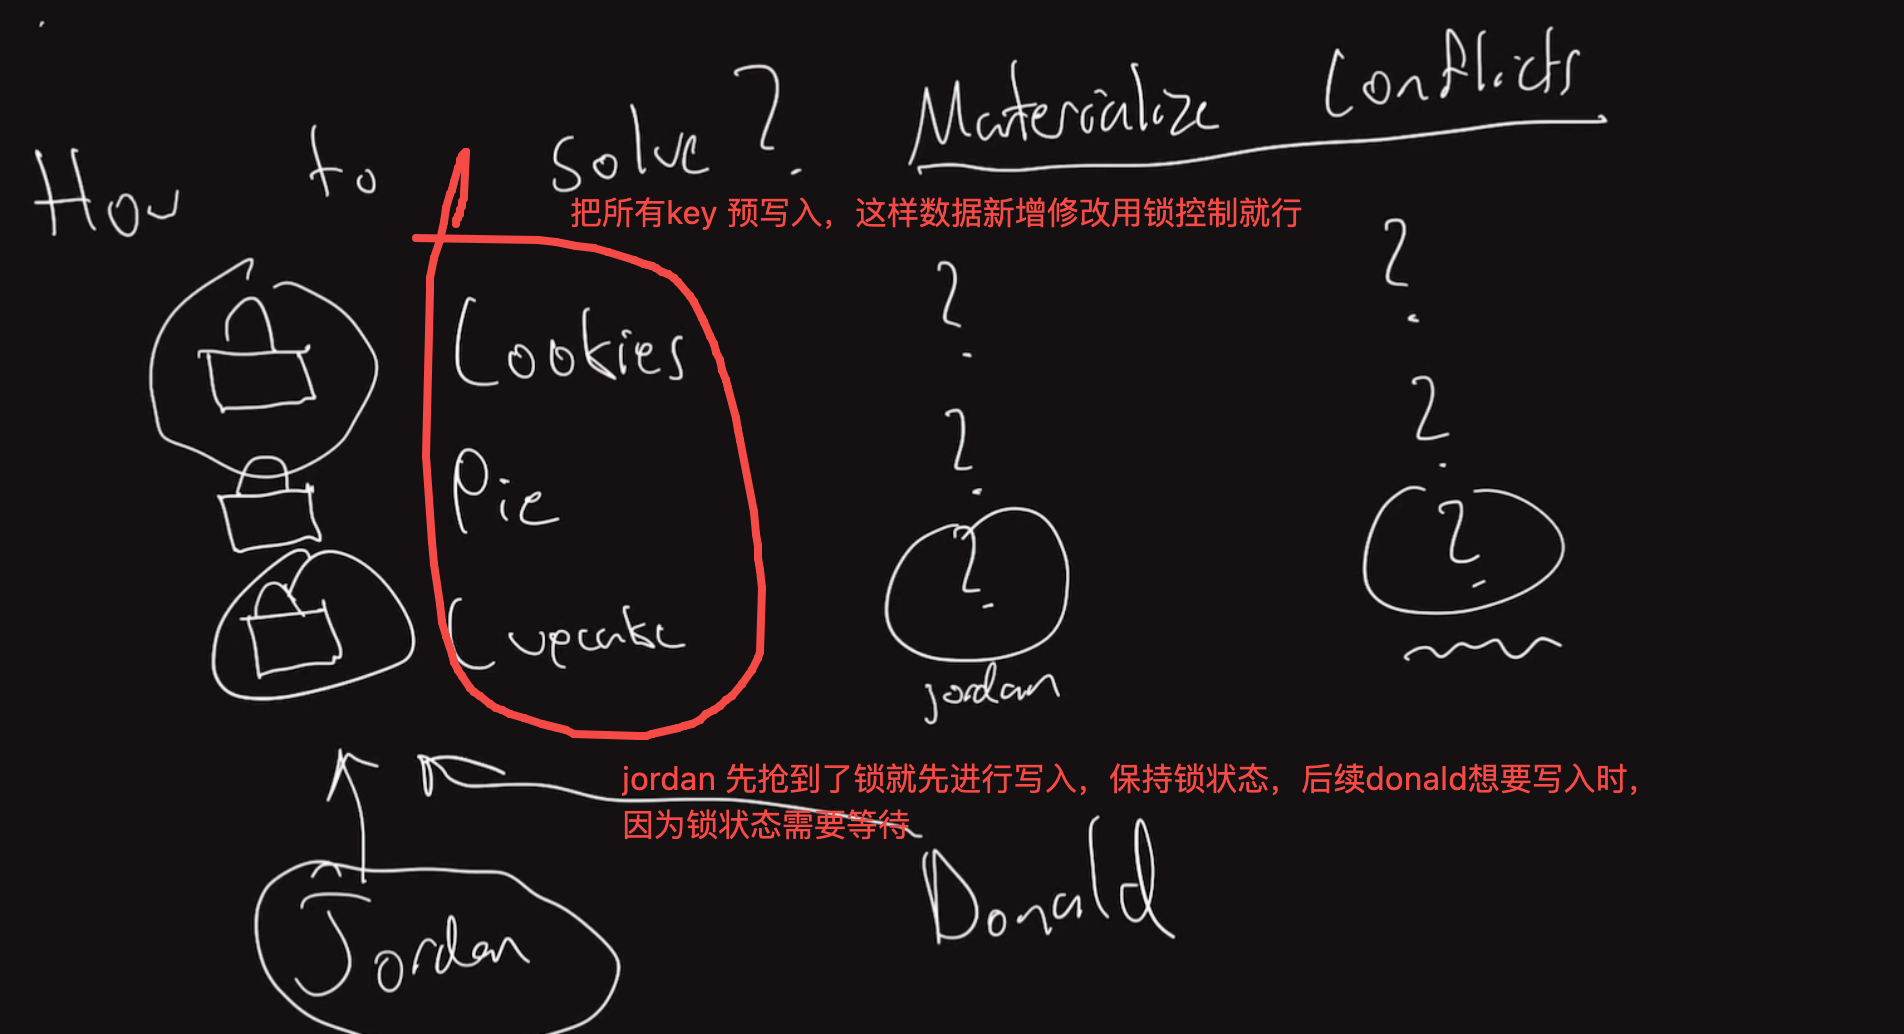
phantom 幻影
occur when two people write new rows that conflict, no locks to grab the new row
两个新数据都需要处理,会造成数据库不一致问题
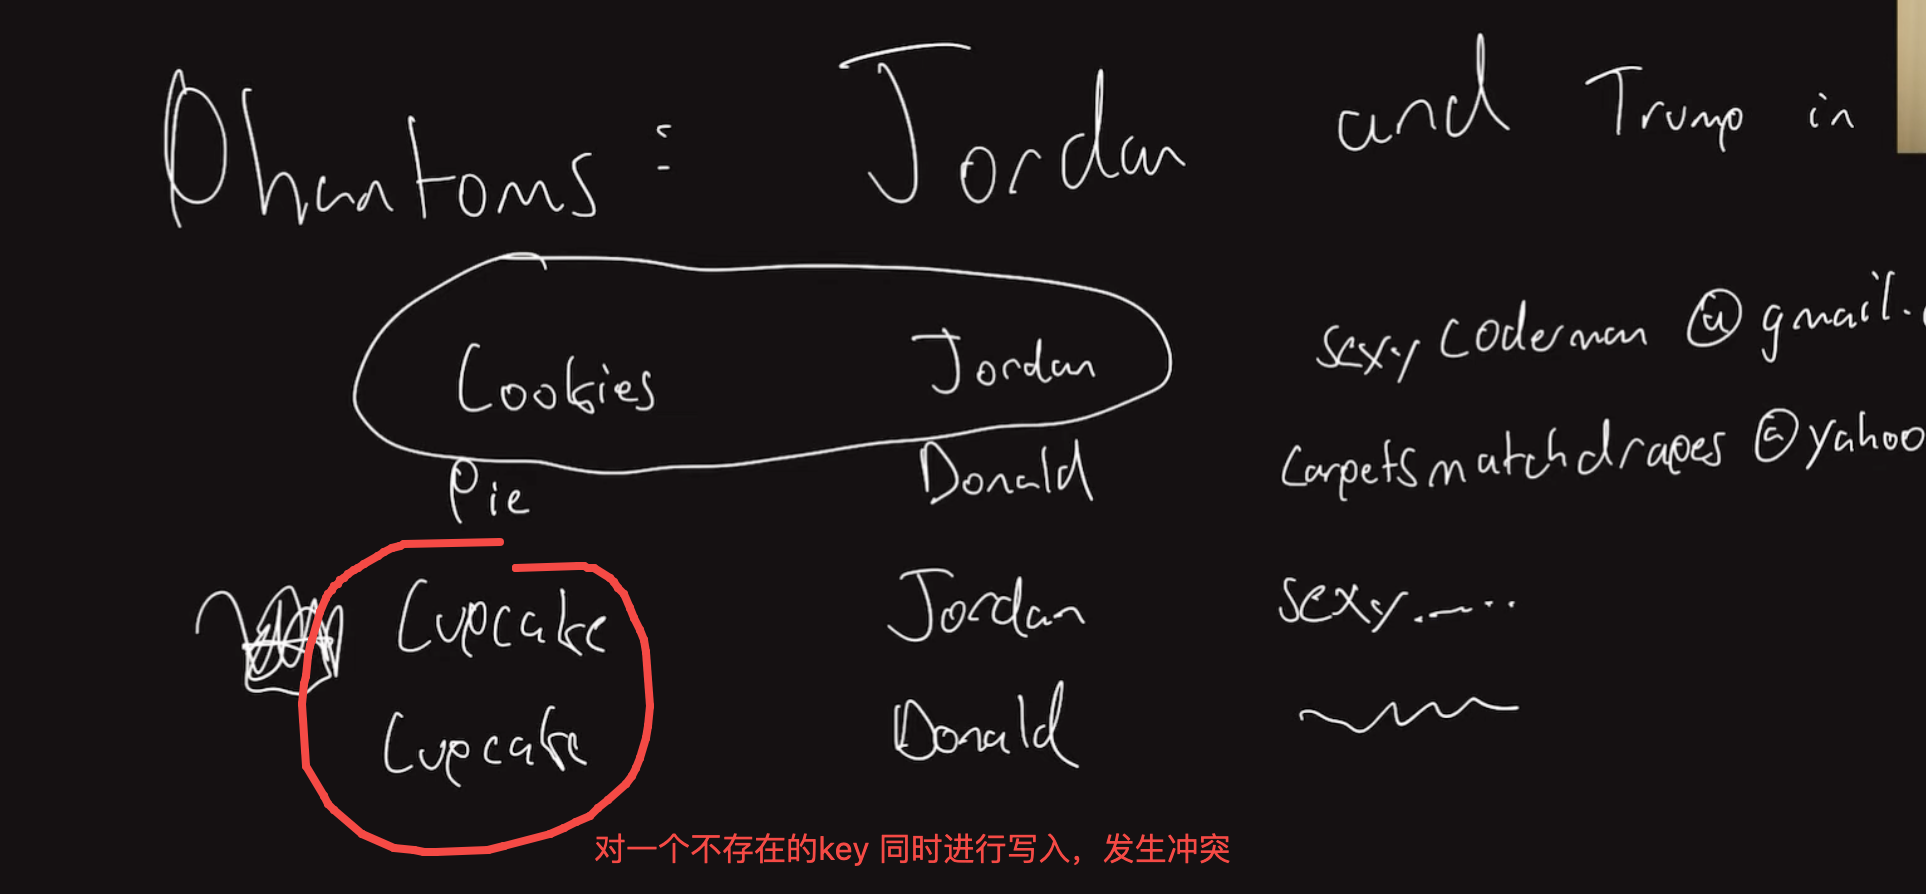
解决: 预填入
这样为填入的数据就可以拥有相对应锁对象,就能够通过locks对数据写入进行控制
First we check to see if anyone has claimed the cupcakes and then since the email is empty we try to grab the lock to make the write
| 问题 | 核心 |
|---|---|
| Non-repeatable Read | 同一行变了 |
| Phantom Read | 符合条件的行集合变了 |
| Write Skew | 两个事务修改不同的数据,导致整体业务规则被破坏 |
actual serial execution
随着cpu 运算速度的提高,之前依赖多线程多核同时执行的任务现在可以在一个core 按照顺序执行
但这种方式有一定缺陷,
比如在disk 上运行导致速度变慢 —> 把数据放在内存上运行
—> 好处速度快,可以使用hash, 二叉树等手法进行查询 但内存size 有限,不能持久化
—> 网络传输数据量大,导致网络通信时间长,
—>解决,将操作脚本sql function 前提在数据库启动时通过store procedure 过程直接传输到数据库中,之后数据传输仅传数据本身和操作标识,减少数据传输量;但缺点就是要对版本和代码进行管理和维护,对开发不友好,
双相锁定机制(Two-Phase Locking / 2PL)
关系型数据库管理并发事务、保证数据一致性的核心理论基础
这个协议的核心,就是把一个事务的生命周期严格划分为两个阶段,对锁的操作有明确的”单向”要求:
- 增长阶段(加锁阶段):事务在这个阶段可以按需申请新的锁(如读锁S或写锁X),但绝对不能释放任何已经持有的锁。你可以把它理解为事务在”收集资源”。
- 收缩阶段(解锁阶段):事务一旦开始释放第一个锁,就立即进入这个阶段。此后,它只能释放已有的锁,不能再申请任何新锁。这标志着事务在”释放资源”。
这个”先增长,后收缩”的规定,保证由2PL管理的事务调度结果是冲突可串行化的,即并发执行的结果与某种串行执行的结果等价,从而保证数据一致性
严格两阶段锁(Strict 2PL)
在2PL上增加
事务持有的所有排他锁(写锁),必须等到事务最终提交(COMMIT)或回滚(ROLLBACK)时才能一次性全部释放
优点:
· 防止级联回滚:避免了其他事务读到未提交的脏数据后,又因源事务回滚而被连带撤销。
· 简化故障恢复:系统恢复时只需关注已提交事务的锁状态,逻辑更清晰
谓词锁
是一种逻辑锁,它锁定的不是一个具体的物理数据行,而是一个满足特定搜索条件(谓词)的“逻辑数据集合”
锁住“一类数据”,而不是“一行数据”
它能从根本上解决“幻读(Phantom Read)”问题,是实现最高隔离级别“可串行化(SERIALIZABLE)”的一种重要理论方案。
它的思想是:即使目标数据行现在不存在,也先把满足 age = 25 这个“条件”锁住。这样,当其他事务想插入满足该条件的新行时,就会发现这个条件被锁住了,必须等待,从而避免了幻读
巨大的实现代价:
实现极其复杂:判断两个复杂查询条件(如 (age > 20 AND city = ‘Beijing’) 与 (age < 30 AND city = ‘Shanghai’))是否存在交集,本质上是一个NP-Complete(NP完全)问题,计算开销极大。
并发度风险:过于严格的逻辑锁可能会锁住一些事实上并不存在冲突的数据范围,反而降低系统的并发处理能力。
索引范围锁定
索引范围锁(Index Range Lock) 是数据库中一种基于索引结构的锁机制,它的核心作用是锁定一个索引范围内的所有记录及其之间的间隙(Gap),以防止其他事务在该范围内插入、修改或删除数据。
在 MySQL/InnoDB 中,它被具体实现为 Next-Key Lock(临键锁),即 Record Lock(记录锁) + Gap Lock(间隙锁) 的组合。它是在 可重复读(REPEATABLE READ) 隔离级别下,解决幻读问题的核心技术手段。
1. 索引范围锁的构成
| 组成部分 | 作用 | 锁定对象 |
|---|---|---|
| Record Lock(记录锁) | 锁定索引树上的具体索引项(即某一行记录) | 该索引项本身 |
| Gap Lock(间隙锁) | 锁定索引记录之间的间隙(包括记录前、记录后、记录之间) | 索引间隙(空位),用于阻止插入 |
| Next-Key Lock | Record Lock + Gap Lock 的组合,锁定一个左开右闭区间 (上一个值, 当前值] |
索引项 + 其前面的间隙 |
2. 一个具体的例子
假设有一张表 users,主键 id 目前有数据:1, 3, 5, 7, 9。
1 | 索引(主键)分布:1, 3, 5, 7, 9 |
现在执行查询:
1 | SELECT * FROM users WHERE id = 5 FOR UPDATE; |
在 REPEATABLE READ 隔离级别下:
- 如果
id=5存在,InnoDB 会加一个 Record Lock,锁定id=5这一行,阻止其他事务修改或删除它。 - 但不会锁间隙,因为这是一个精确等值查询且目标存在。
如果执行范围查询:
1 | SELECT * FROM users WHERE id BETWEEN 3 AND 7 FOR UPDATE; |
InnoDB 会锁定:
| 锁定范围 | 锁类型 | 说明 |
|---|---|---|
id=3 |
Record Lock | 锁定该行 |
(3,5) |
Gap Lock | 阻止插入 4 |
id=5 |
Record Lock | 锁定该行 |
(5,7) |
Gap Lock | 阻止插入 6 |
id=7 |
Record Lock | 锁定该行 |
(7, +∞) 或继续到边界 |
可能继续锁定 | 取决于查询是否命中了索引边界 |
这样,整个索引区间 [3, 7] 被彻底锁住,其他事务无法插入任何值在 3~7 之间的新行,也无法修改或删除 3、5、7 这三行,从而保证了当前事务两次查询的结果完全一致——幻读被阻止了。
3. 索引范围锁的触发条件
| 条件 | 是否触发 Next-Key Lock |
|---|---|
| 唯一索引 + 等值查询且记录存在 | ❌ 只加 Record Lock(无需锁间隙) |
| 唯一索引 + 等值查询但记录不存在 | ✅ 在索引间隙上加 Gap Lock(如查询 id=4,锁 (3,5) 间隙) |
唯一索引 + 范围查询(>, <, BETWEEN, LIKE 等) |
✅ 对命中范围内的所有记录加 Record Lock + 间隙加 Gap Lock |
| 非唯一辅助索引 + 任何查询 | ✅ 通常都加 Next-Key Lock,因为辅助索引不是唯一的,需要额外防止幻影行 |
| 没有索引(全表扫描) | ✅ 锁定整个表(所有行 + 所有间隙),相当于表锁,极影响并发 |
4. 为什么需要索引范围锁?
| 解决的问题 | 说明 |
|---|---|
| 幻读(Phantom Read) | 防止其他事务在当前事务的查询范围内插入新行,保证可重复读的语义。 |
| 数据一致性 | 在 SELECT ... FOR UPDATE 或 UPDATE/DELETE 时,确保范围操作不会遗漏或错误影响其他并发事务。 |
| 唯一性约束 | 在插入或更新唯一索引时,通过 Gap Lock 防止并发插入相同键值,维护索引唯一性。 |
5. 索引范围锁的代价与风险
| 问题 | 说明 |
|---|---|
| 并发度下降 | 锁定的范围越大,阻塞的其他事务越多,系统吞吐量降低。 |
| 死锁风险增加 | 多个事务对相同间隙加锁,容易产生循环等待(如事务A锁 (1,3),事务B锁 (3,5),A想插4,B想插2,形成死锁)。 |
| 性能开销 | 大量 Gap Lock 会消耗内存和锁管理器资源,特别是在大范围查询时。 |
| 间隙锁在只读事务中也会加? | 在 REPEATABLE READ 下,普通的 SELECT(非 FOR UPDATE/LOCK IN SHARE MODE)通过 MVCC(多版本并发控制) 实现一致性读,不会加任何锁,因此无此开销。只有写操作(SELECT ... FOR UPDATE、UPDATE、DELETE)才会触发索引范围锁。 |
6. 如何减少索引范围锁的影响?
| 策略 | 说明 |
|---|---|
| 尽量使用唯一索引进行等值查询 | 只加 Record Lock,避免 Gap Lock。 |
| 缩小查询范围 | 避免 SELECT ... FOR UPDATE 扫描大范围,尽量精确命中。 |
使用 READ COMMITTED 隔离级别 |
该级别下 InnoDB 只加 Record Lock,不加 Gap Lock,但会丢失可重复读语义,允许幻读。 |
| 优化索引设计 | 确保 WHERE 条件能命中高效索引,减少扫描范围。 |
| 合理设计事务 | 缩短事务执行时间,尽早提交释放锁。 |
7. 范围锁 vs. 谓词锁
| 维度 | 索引范围锁(Next-Key Lock) | 谓词锁(Predicate Lock) |
|---|---|---|
| 实现方式 | 基于 B+Tree 索引物理结构,锁定具体键值和间隙 | 基于逻辑谓词条件(如 age = 25),锁定满足条件的所有可能数据 |
| 是否真正实现 | ✅ MySQL/InnoDB 默认实现 | ❌ 理论方案,实际实现极少(性能代价过高) |
| 适用场景 | 事务的索引范围查询 | 理想的高隔离级别理论框架 |
| 幻读防护能力 | ✅ 在可重复读级别下有效阻止幻读 | ✅ 理论上完全阻止幻读 |
总结
索引范围锁(Next-Key Lock)是 InnoDB 在 REPEATABLE READ 隔离级别下,利用 B+Tree 索引结构,通过“记录锁 + 间隙锁”组合实现的、用于防止幻读的实用锁机制。
- 优点:在索引有序的前提下,能高效锁定范围,保证可重复读语义。
- 代价:牺牲部分并发性能,增加死锁风险。
- 最佳实践:尽量使用主键或唯一索引进行精确查询,减少范围锁定;在能接受幻读的场景下,可考虑降级隔离级别到
READ COMMITTED以换取更高并发。
可串行化快照隔离 Serializable Snapshot Isolation
是一种既提供最高级别“可串行化”事务隔离保证,又能保持“快照隔离”高性能的并发控制算法
结合了两种隔离级别的优点:像可串行化一样严格保证数据一致性,避免各种并发异常;同时在性能上又非常接近快照隔离,避免了传统悲观锁机制带来的大量阻塞和性能损耗
解决了以下两种方案的问题:
快照隔离 (SI):性能好,读操作不阻塞写操作。但存在“写倾斜”等并发异常,无法保证完全可串行化,可能产生不可串行的执行结果。
两阶段锁 (2PL):能保证可串行化,但采用悲观策略。事务在操作前就必须获取锁,容易导致阻塞、死锁,在高并发场景下性能和扩展性较差。
SSI 基于快照隔离,采用了一种更“乐观”的策略:
- 乐观执行:事务可以基于其快照自由读写,不会因为潜在的冲突而被阻塞,因此读写性能很高。
- 提交前检测:当事务准备提交时,数据库会检查其执行过程中是否与其他并发事务产生了可能导致非可串行化结果的读写依赖关系(如读-写冲突)。
- 裁决与重试:如果检测到这类有问题的依赖(例如,形成了一个依赖环),为了保持数据一致性,数据库会中止(Abort)当前事务或相关事务,并通知应用层进行重试。如果未检测到问题,则事务成功提交。
尽管 SSI 很强大,但使用它时仍需注意:
- 必须处理重试:由于可能存在事务被中止的情况,应用程序必须正确捕获序列化失败错误,并重试整个事务。这是使用 SSI 的代价,也是应用需要承担的职责。
- 高冲突下的性能:如果系统并发事务间的数据访问冲突非常严重,会导致大量事务被中止和重试,反而可能因为重试的额外开销而降低系统整体性能。