数据库索引(database index)
索引是一种数据结构,针对特定key, 可以使读取数据加快,但写入速度降低
处理常见数据量过大情况下进行查找问题,避免挨个遍历数据(无论是从前往后还是从后往前找),提高查找效率O(n)
比如
具体查找,找到key = xxx的 那条数据
范围查找,找到key在[xxx, xxx]之间的数据
MySQL官方对索引定义:索引是MySQL存储引擎用于快速查找记录的一种数据结构。
简单理解为:索引是排好序的数据结构,帮助我们快速的查询数据库表中的数据。
• 索引是一种特殊的数据文件
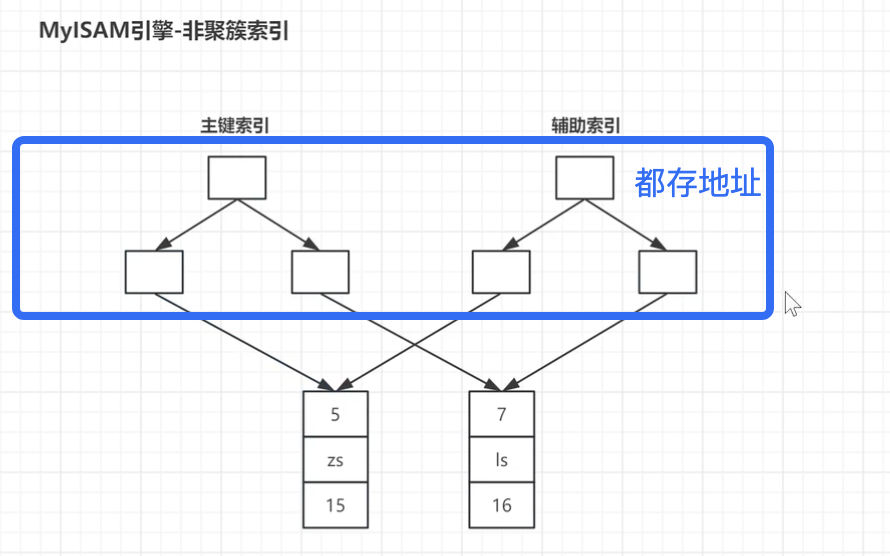
。 MyISAM存储引擎:数据文件和索引文件是分开的。索引文件中保存的是数据记录的地址。
。InnoDB存储引擎:表数据本身就是按照B+Tree组织的索引结构。ibd文件 就是数据+索引存储文件。
• 索引是一种数据结构
。索引是一个独立的、物理的数据结构,它是由一个表中的一个字段或者多个字段的值组合成的集合。
• MySQL中,默认使用的是B+Tree结构管理索引。
没有索引
查找数据需要从磁盘中一条一条进行对比
二叉查找树索引
使用二叉查找树,构建索引
• 任何一个节点的左子树上的键值,都必须小于当前节点。
• 任何一个节点的右子树上的键值,都必须大于当前节点。
• 每个节点分别保存,字段数据和指向数据记录的物理地址的指针。|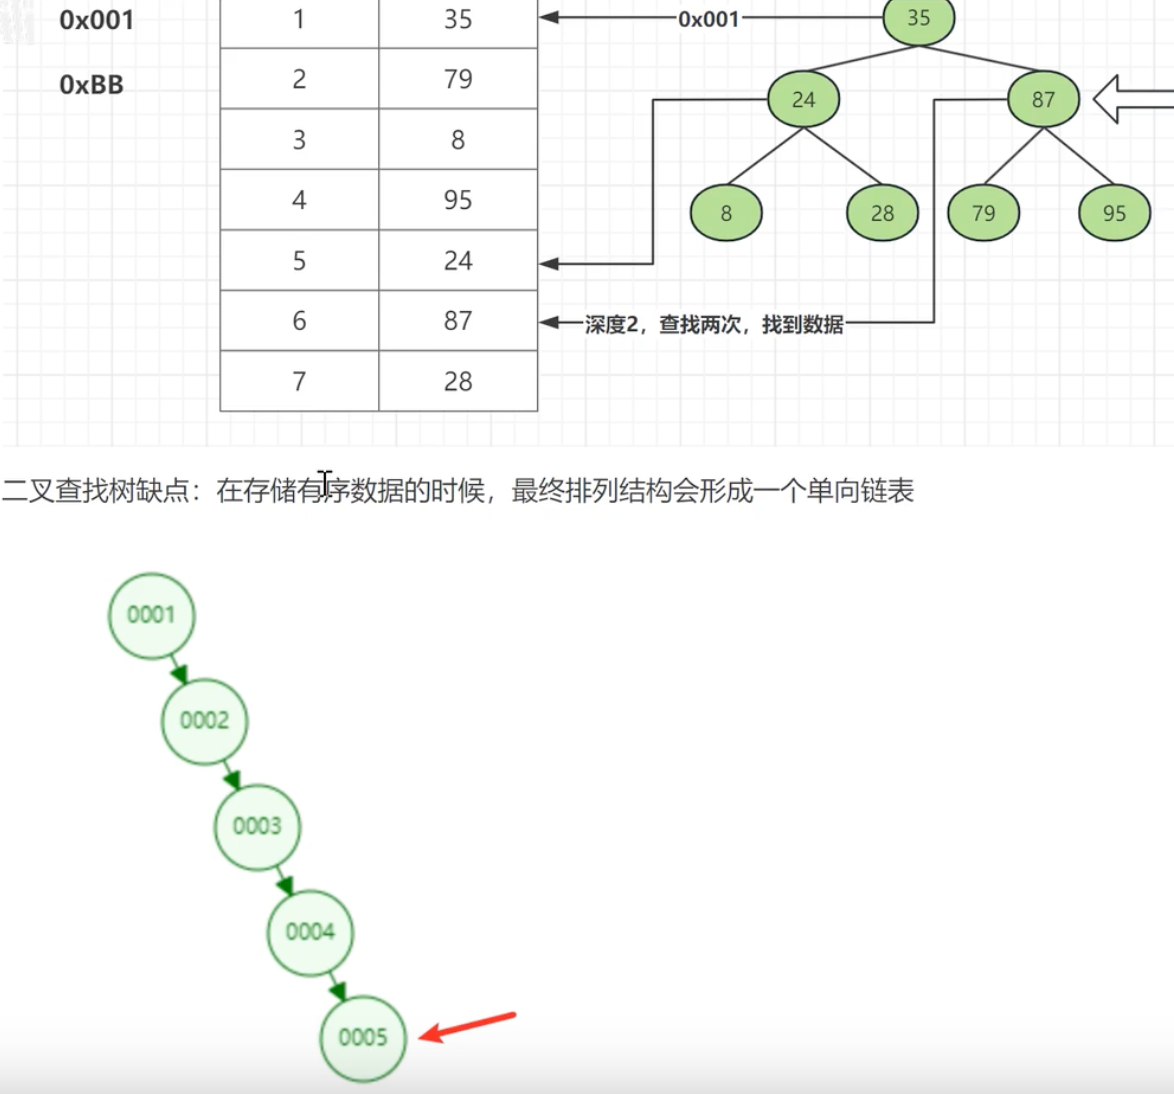
平衡二叉树索引
平衡二叉树通过让树的叶子节点自动旋转和调整,让整课树保持平衡状态。
平衡二叉树的特点:
• 在符合二叉查找树的条件下,还满足任何节点的两个子树的高度差最大为1.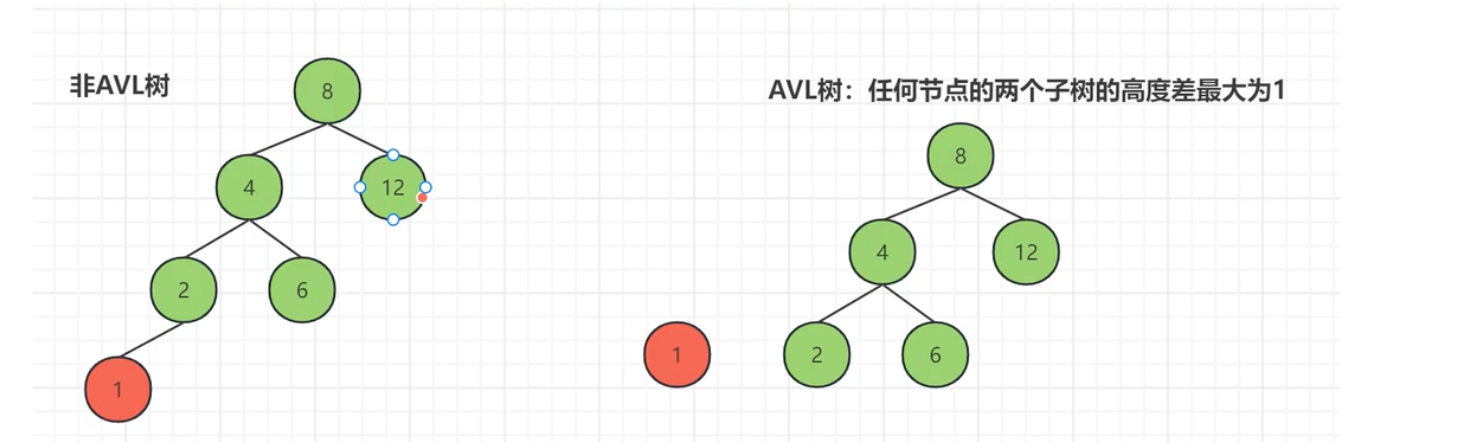
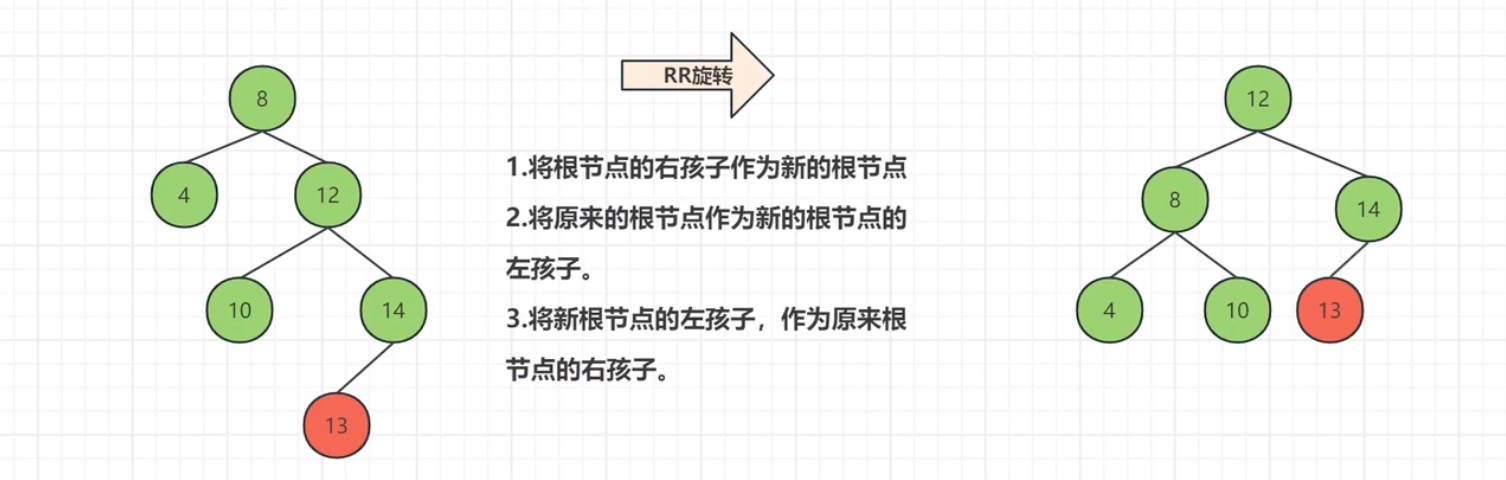
AVL树 在失去平衡之后(两个子树的高度差>1),可以通过旋转使其恢复平衡。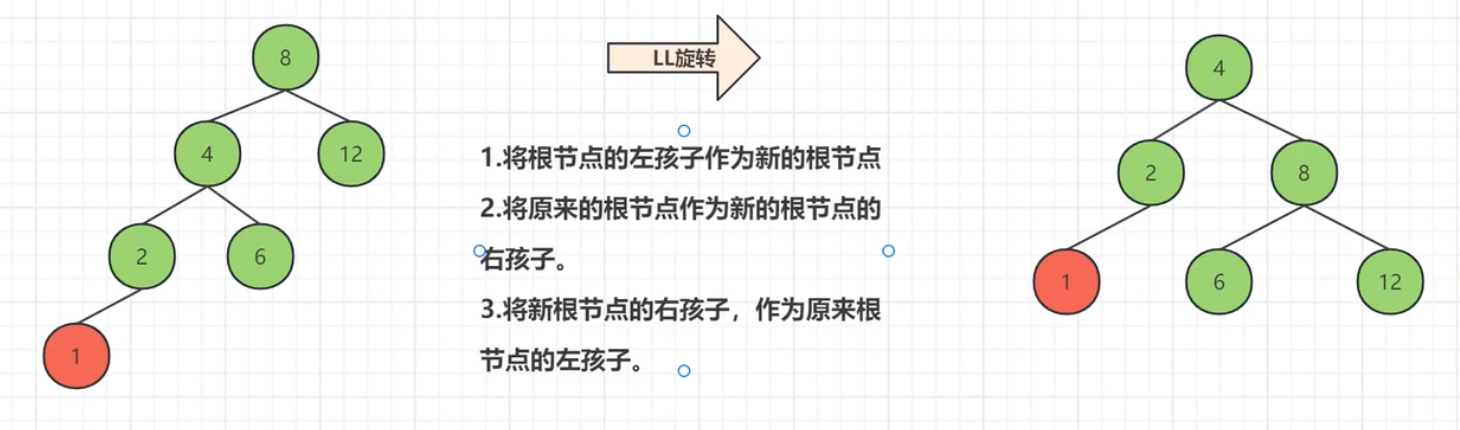
AVL树的优点
•叶子节点的层级相对减少了。
• 形态上能够保持平衡
• 查找效率提升,大量的顺序插入操作也不会导致查询性能下降
AVL树的缺点:
• 一个节点最多分裂出两个子节点,树的高度太高,导致IO次数过多
• 节点里面只保存一个关键字,每次操作获取的目标数据太少
哈希索引(hash index)
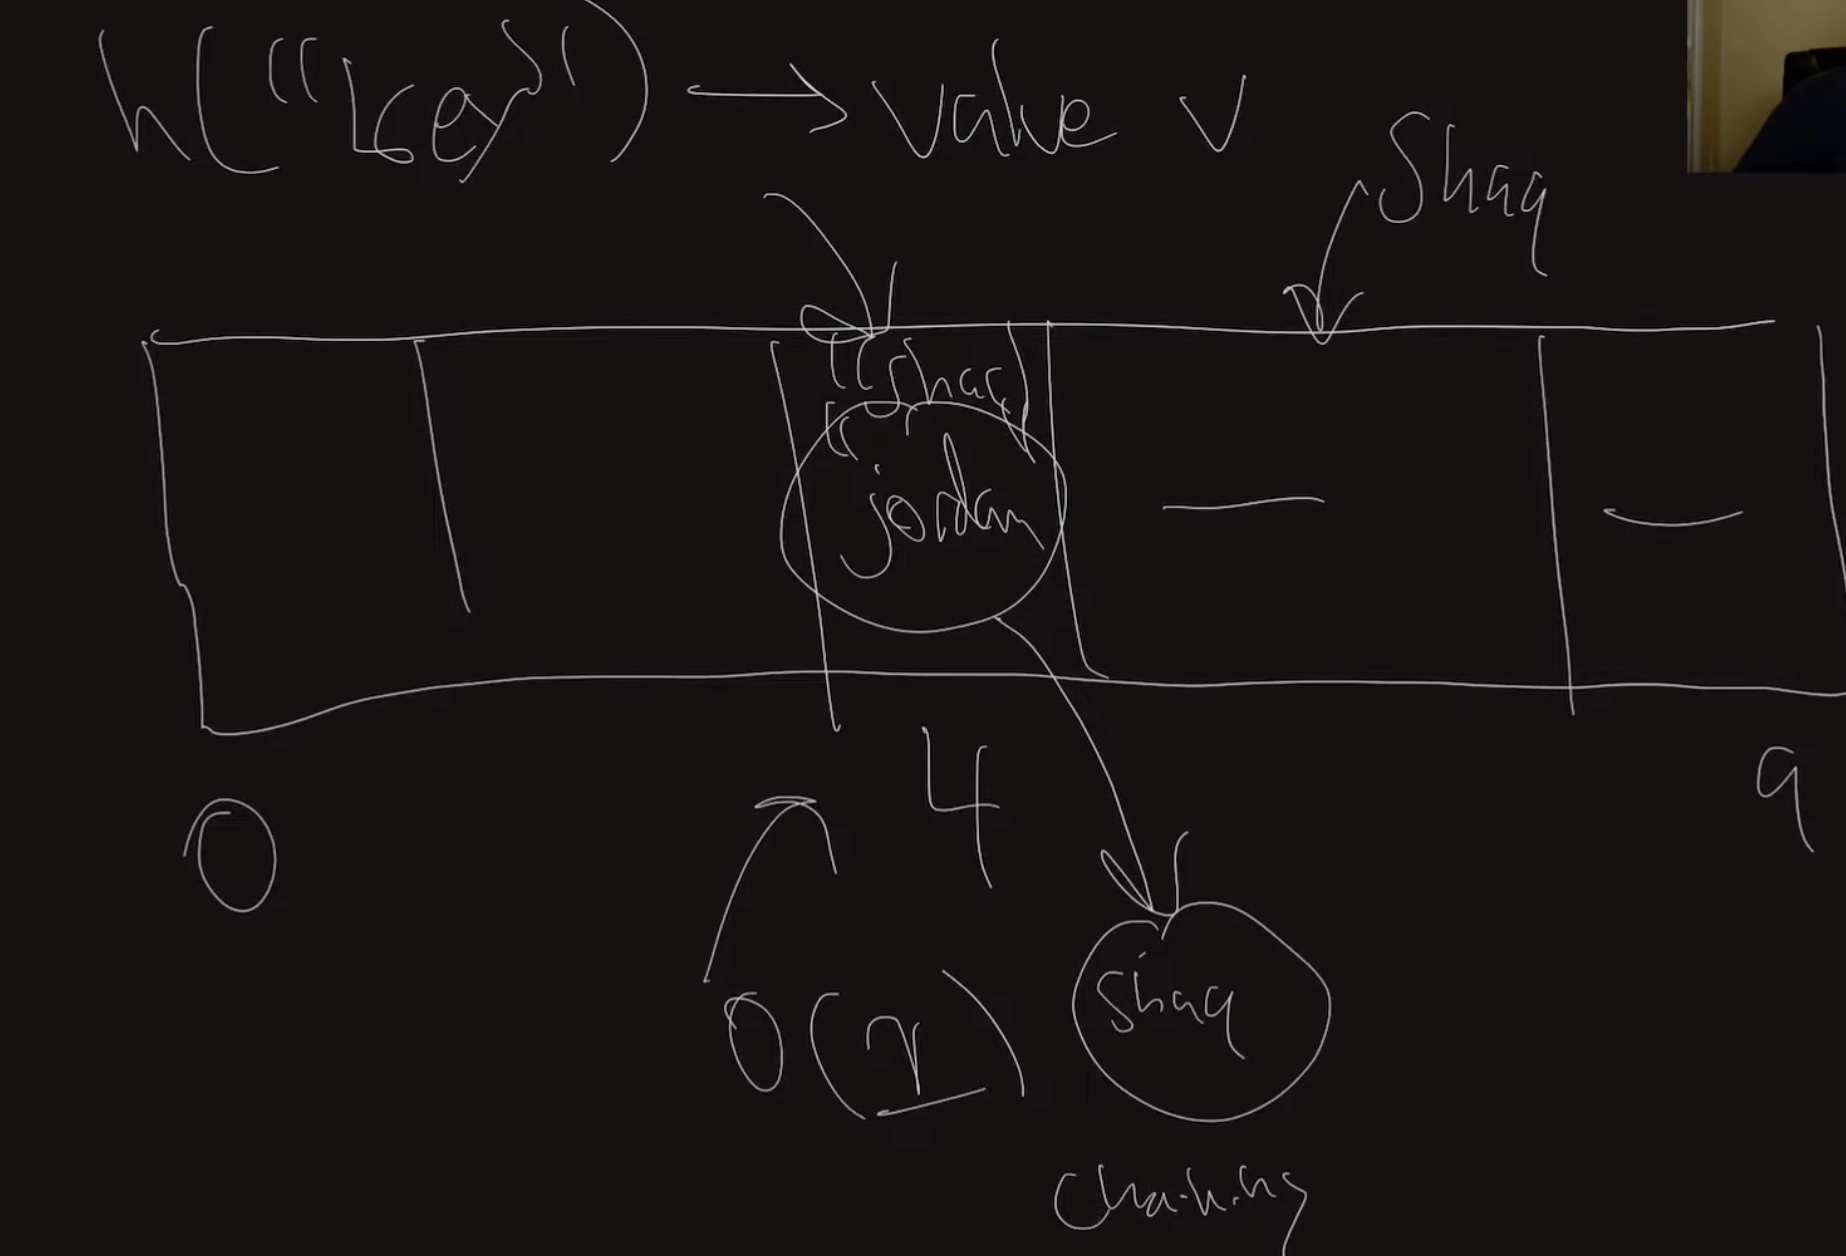
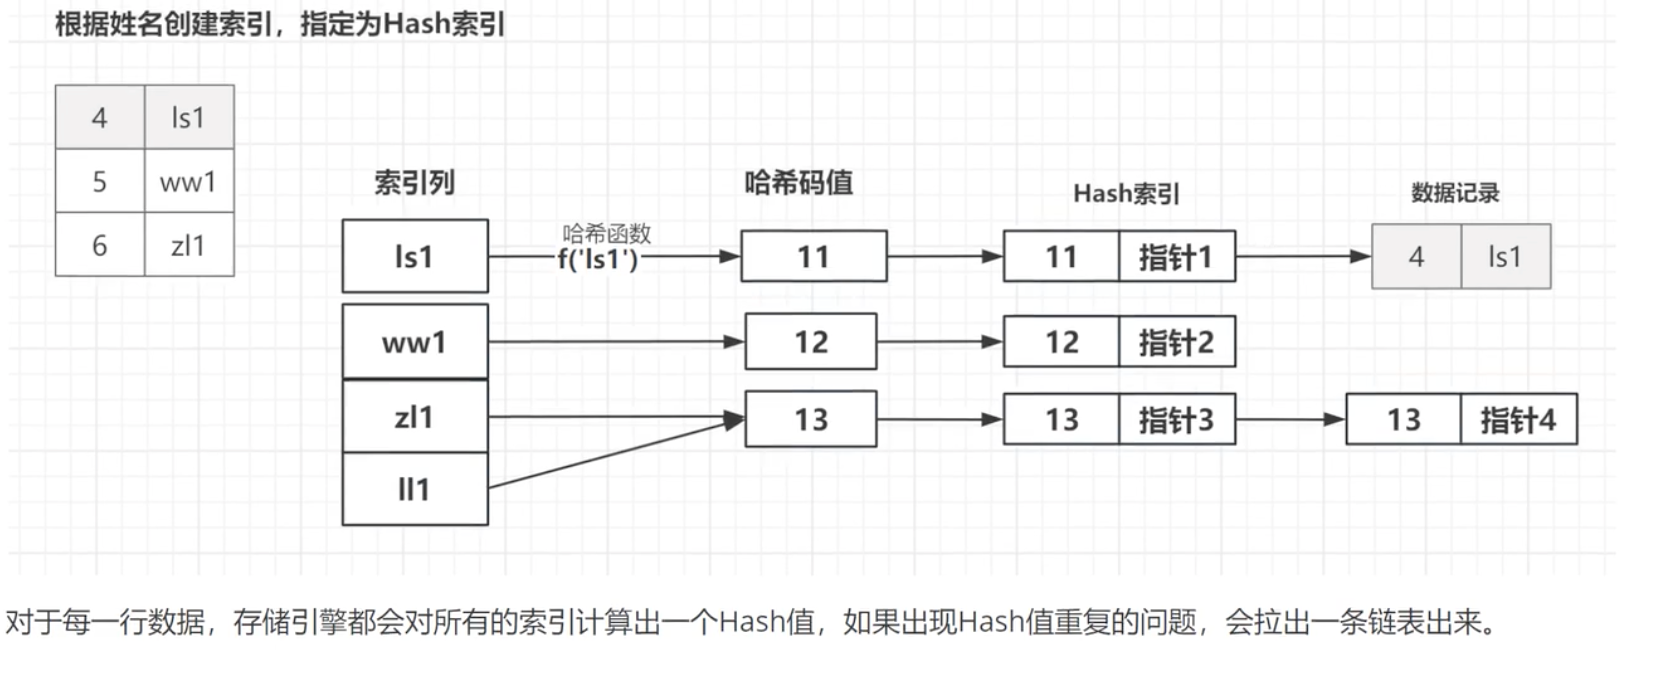
通过哈希函数对某一特定key值进行计算生成hash map key值,将数据存储或者内存地址存在对应的hash map key值对应的bucket中
这样可以实现O(1)时间复杂度的查找效率,对于读写都是
hash map key值唯一且有限,比如从1-100000000
对于哈希函数计算结果相同的情况,可以在bucket中通过链表进行存储或者在hash map 中继续查找有无空位填入
• Hash索引底层是由Hash表实现的,是根据键值<key,value>存储数据。
• Hash索引非常适合 根据Key查找value值,也就是单个key的查询或者说等值查询。
个人理解: 类似将数据根据关键key通过哈希函数强制进行归类,这样在查找的时候,进行同样的哈希计算,直接过滤掉哈希值不同的情况,从而降低挨个查找的工作量
小结
Hash索引的优点:
•O(1) reads and writes
•索引结构是比较紧凑的,因为只存储对应的hash值,如果只是做等值查询,不包含排序或者范围查询的需求,可以选择Hash索引。
•在没有哈希冲突的情况下,等值查询访问hash索引的速度是比较快的,理论上比B+Tree快
Hash索引的缺点:
•索引结构是比较紧凑的,因为只存储对应的hash值,如果只是做等值查询,不包含排序或者范围查询的需求,可以选择Hash
•在没有哈希冲突的情况下,等值查询访问hash索引的速度是比较快的,理论上比B+Tree快。
•哈希索引只包含哈希值和行指针,不存储字段值,不能使用索引中的值来避免读取行。
•哈希索引只支持等值比较查询。不支持任何范围查询。
•哈希索引的数据并不是按照索引值顺序存储的,所以就无法用于排序。
•在遇到大量的Hash值相等的情况时,性能下降明显。
缺点简记:
由于hash function 会将数据均匀分布到不同的bucket中,这使得在存储磁盘中存储地址不连续,导致连续查找性能较差,只能存储在内存中
存内存的话RAM 访问性能高,但是expensive, size less, key 也要适配ram 的存储方式
不能范围查找,O(n), 需要遍历所有数据才能找到符合条件的数据
不能排序,同上
应用场景
• 在MYSQL中 哈希索引主要应用于内存表,也就是Memory引擎。
• InnoDB引擎不支持 对表中字段创建Hash索引
预写日志
主要用于解决数据丢失问题,在对数据进行操作的每一步都将操作日志记录下来存在磁盘中,当数据丢失时,可以通过根据之前的日志进行操作
从而来重建索引和数据
这个方案也适用于其他类型索引情况
对于哈希索引,需要先写入日志,再更改哈希索引
B-tree索引
B-tree结构和存储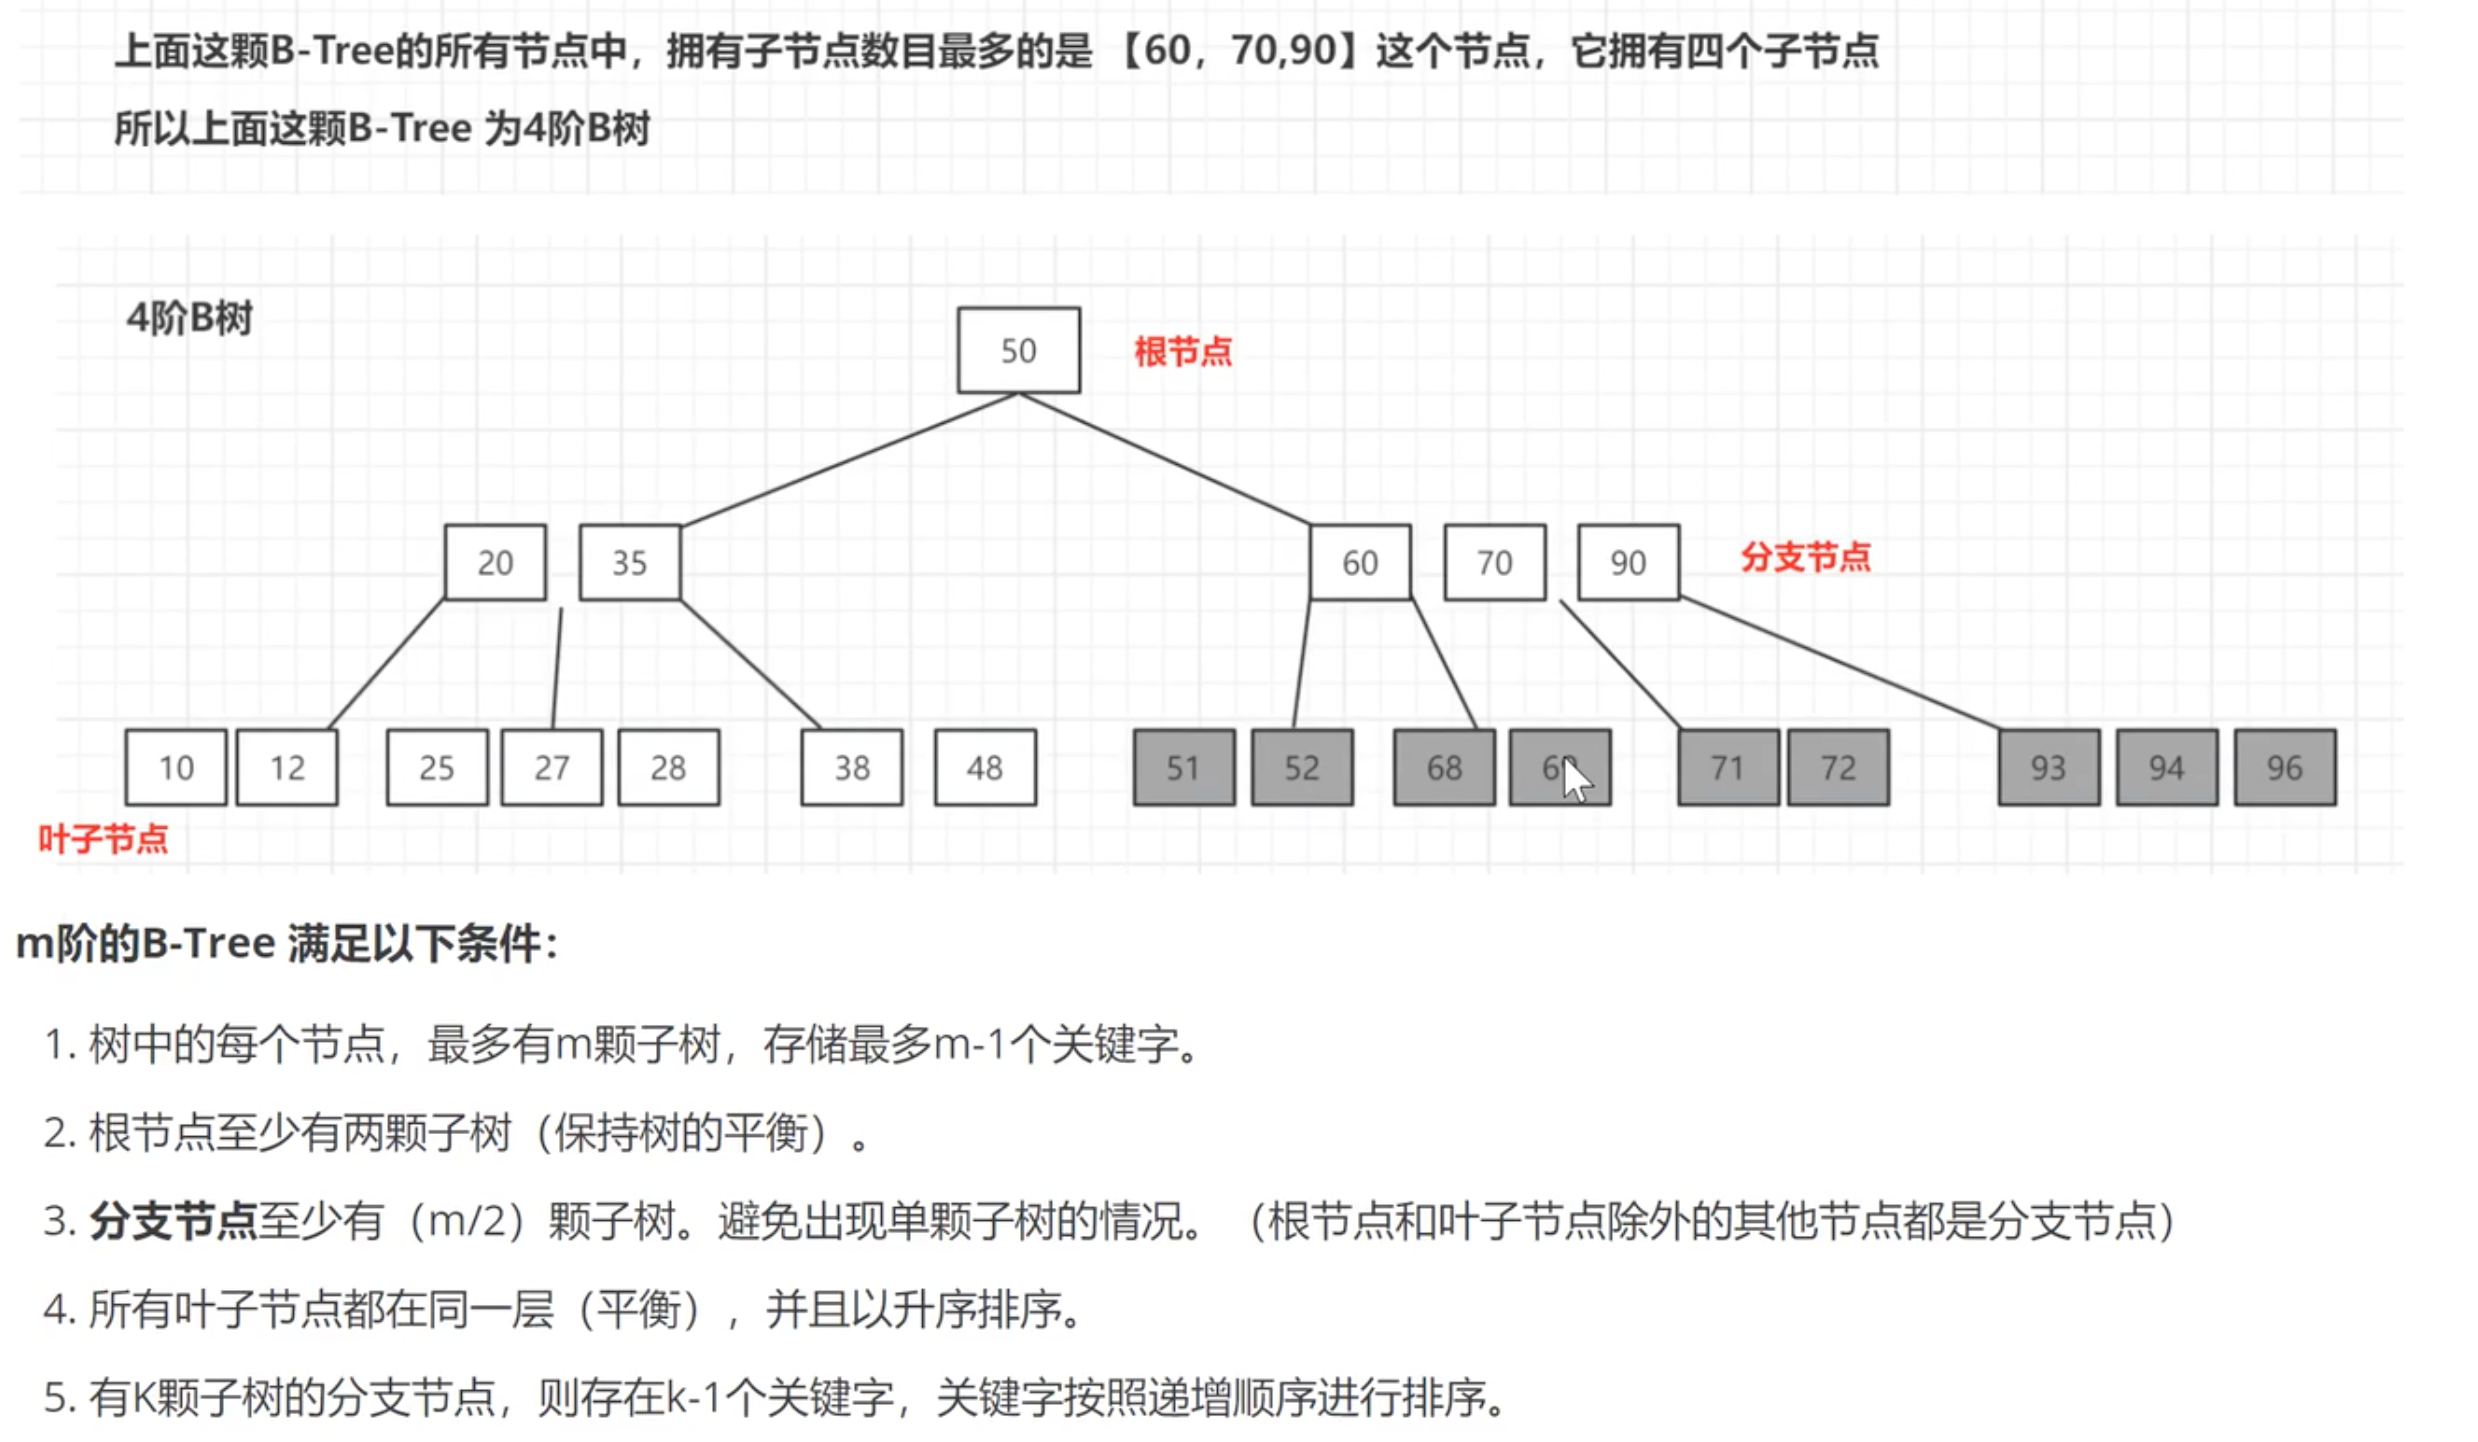
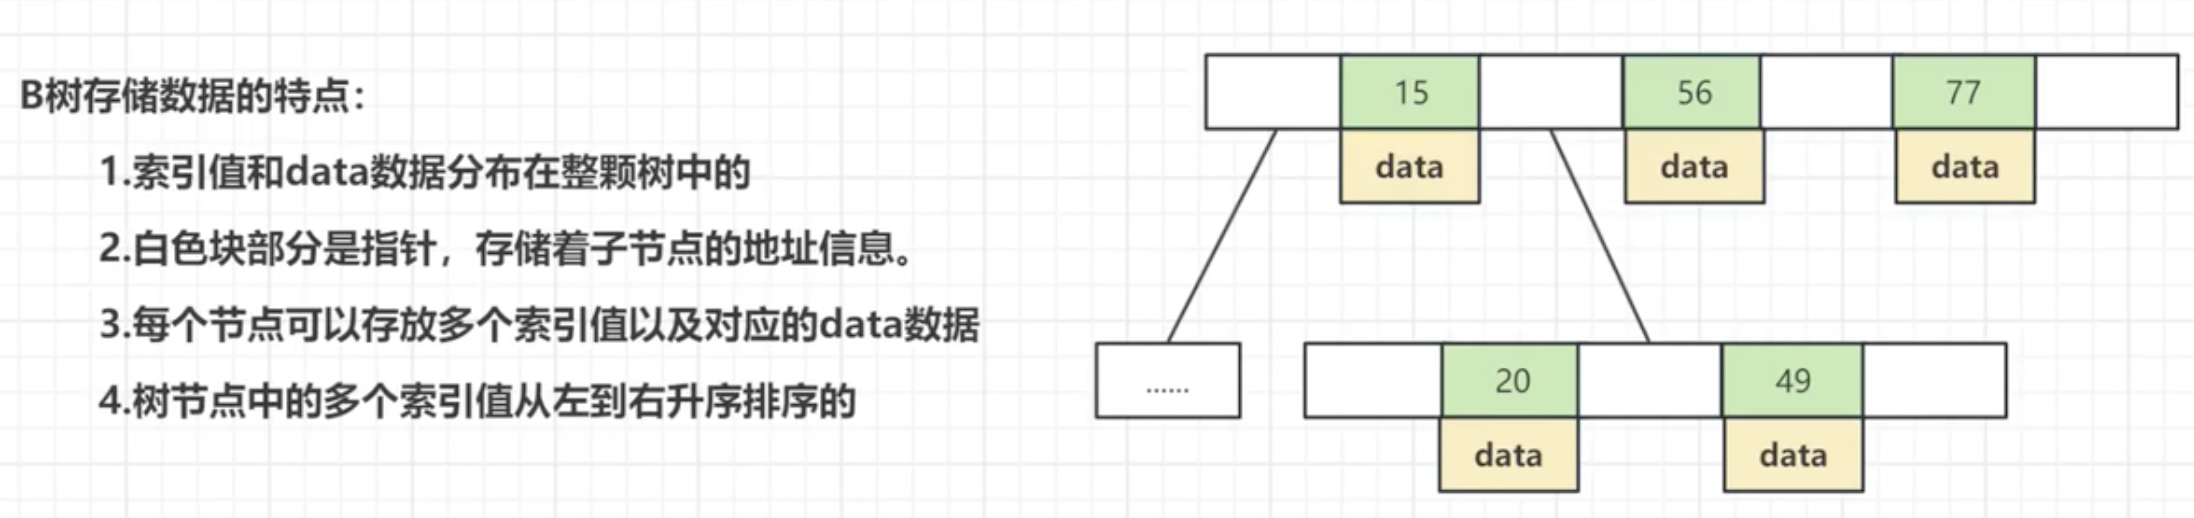
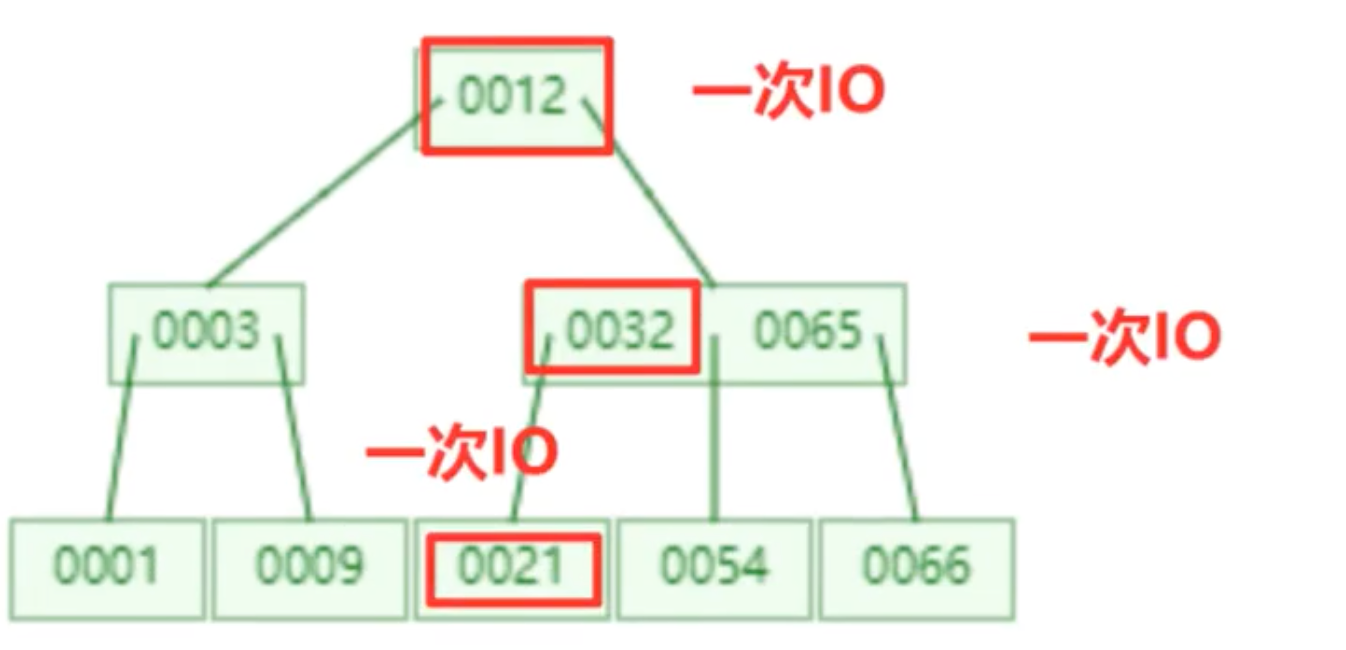
B-Tree的查找操作
- B-Tree的每个节点的元素,可以视为一次I/O的读取,树的高度就表示了最多的IO次数。
- 在相同数量的总元素的个数下,每个节点的元素个数越多,高度越低,查询需要的IO次数就越少。
• B-Tree的优点
。 B树可以在内部节点存储键值和相关的记录数据,因此把频繁访问的数据放在靠近根节点的位置,可以提高热点数据的查询效率。
• B-Tree的缺点
。 B-Tree中每个节点不仅包含数据的key值,还有data数据。当data数据较大的时候,会导致每个节点存储的key值減少了,就会导致B树的层数变高。增加查询的1/O次数。
• 使用场景:B树的使用场景主要应用于文件系统以及部分数据库索引,比如MongoDB,大部分的关系型数据库索引是使用的 B+树实现
B+tree索引
B-Tree存在的问题
•在B树中,每个节点都会存储数据,如果每个节点存储的都是行数据,那么占用的内存就会大大的增加,树的高度也会变高,就会增加I/O操作的次数。
•B树适用于随机访问,但是范围查询是不适合的,因为范围查询通常需要顺序访问一系列的键值,不是随机访问。由于B树的结构的特点,无法有效的执行范围查询
B+Tree 在B-Tree基础之上做了一些优化。B+Tree更加适合实现存储索引结构。InnoDB引擎就是通过B+Tree实现其索引结构的。
【解决读多写少的问题】
一颗m阶的B+树要满足下列要求:
- 每个分支节点至多有m颗子树。
- 根节点或者没有子树,或者至少有两棵子树。
- 除了根节点以外,其他每个分支节点至少要有【m/2】 棵子树。
- 有n棵子树的节点,恰好有n个关键字。子树的个数与该节点的关键字的个数相同。(b-tree 有n-1 个关键字)
- 所有的叶子节点包含全部的关键字,以及指向相应记录的指针,而且叶子节点的关键字,自小到大顺序链接。并且所有的叶子节点链接到了一起。
- 所有的分支节点中,仅包含它的各个子节点中最大的关键字以及指向子节点的指针。
- B+树中,只有叶子节点保存数据,其他节点仅仅是索引,没有任何的数据关联
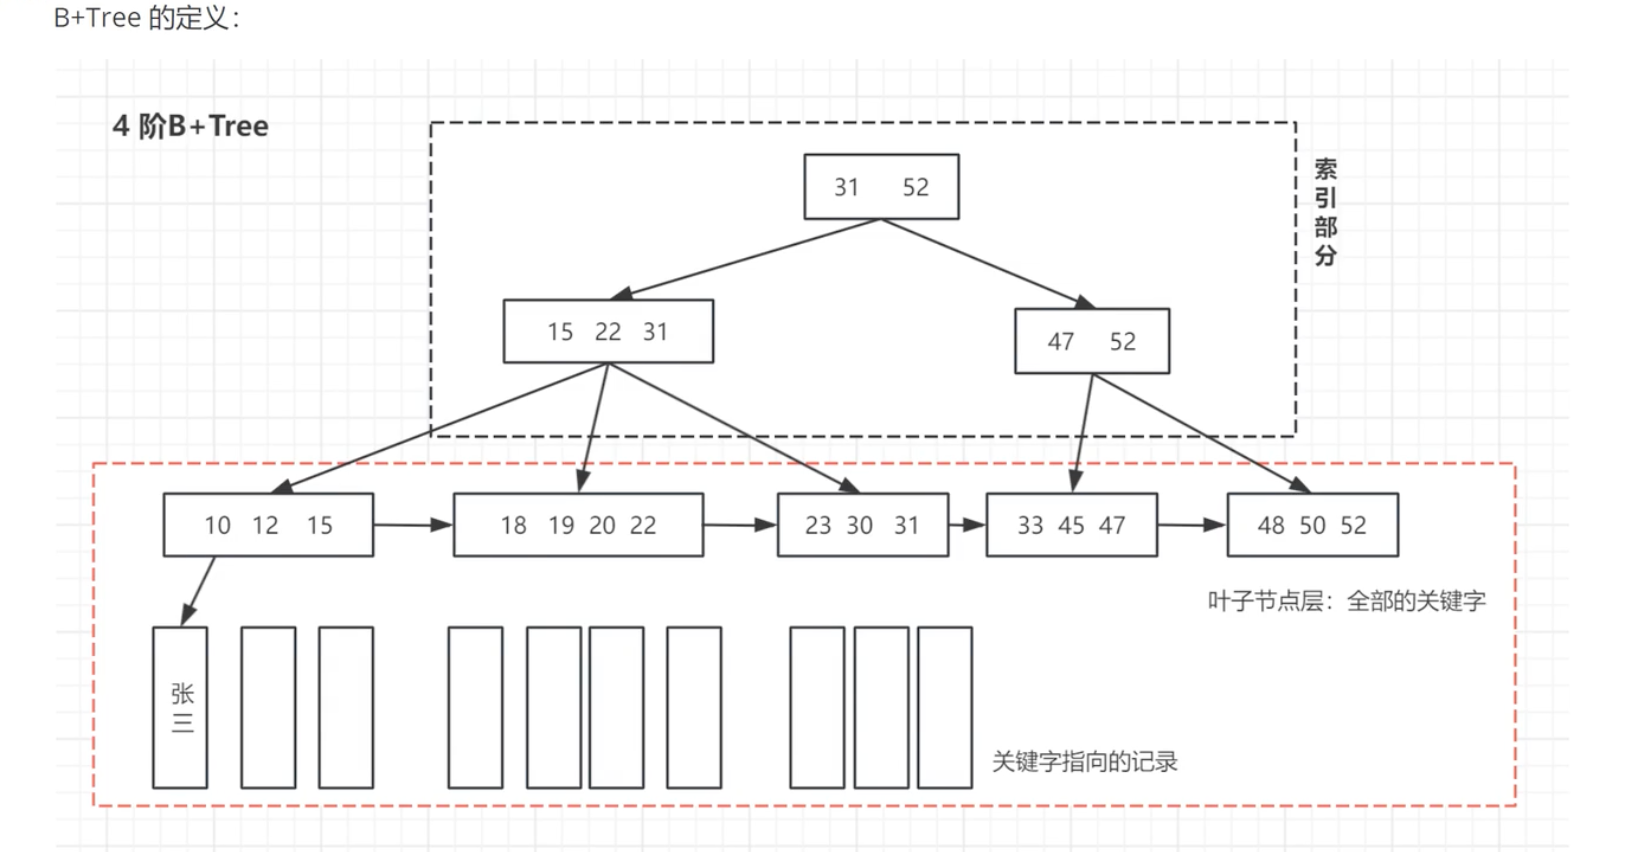
B+Tree结构存储索引的特点
从MySQL数据页的角度看B+Tree:
• MySQL的InnoDB存储引擎中,最小存储单元就是页(每页默认大小是16KB)
•MySQL的设计者将一颗B+Tree的节点的大小 就设置为了等于一个页(16KB),这样做的目的是为了每个节点只需要一次IO就能够完整的载入一页数据。
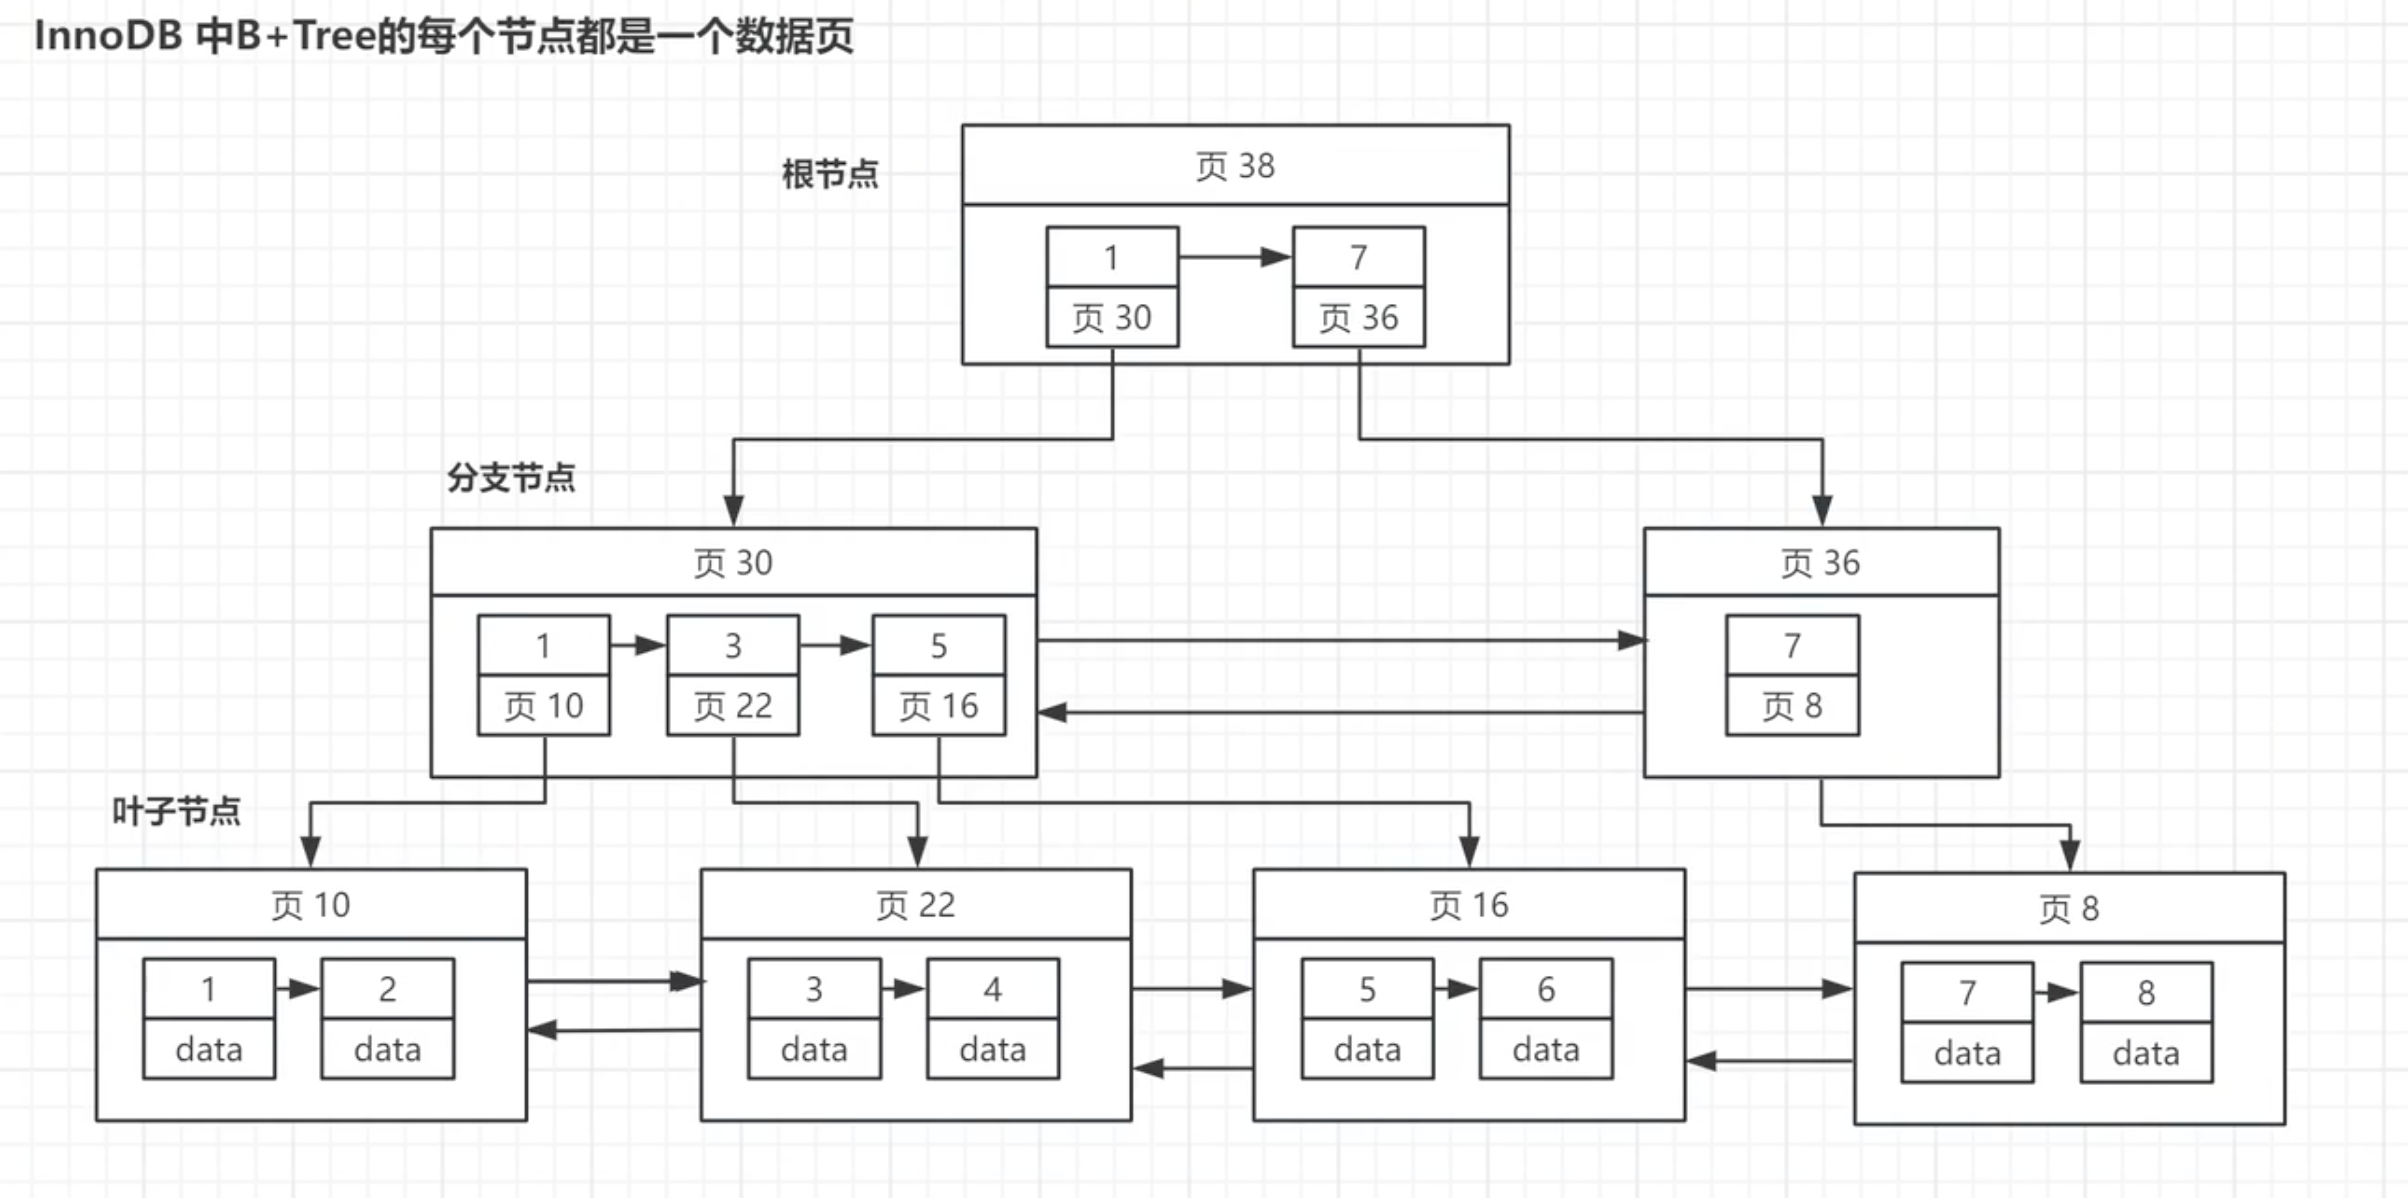
MySQL B+Tree存储索引的特点
- MySQL的B+Tree 分支节点的数据页,存放的是”关键字+指针”。
- 叶子节点的数据页,存放的”关键字+全部数据”,这里单指聚簇索引来说。
- B+Tree的根节点是保存在内存中的,子节点存储在磁盘上的。
- 所有的节点按照索引键大小排序,构成一个双向链表,便于范围查询。
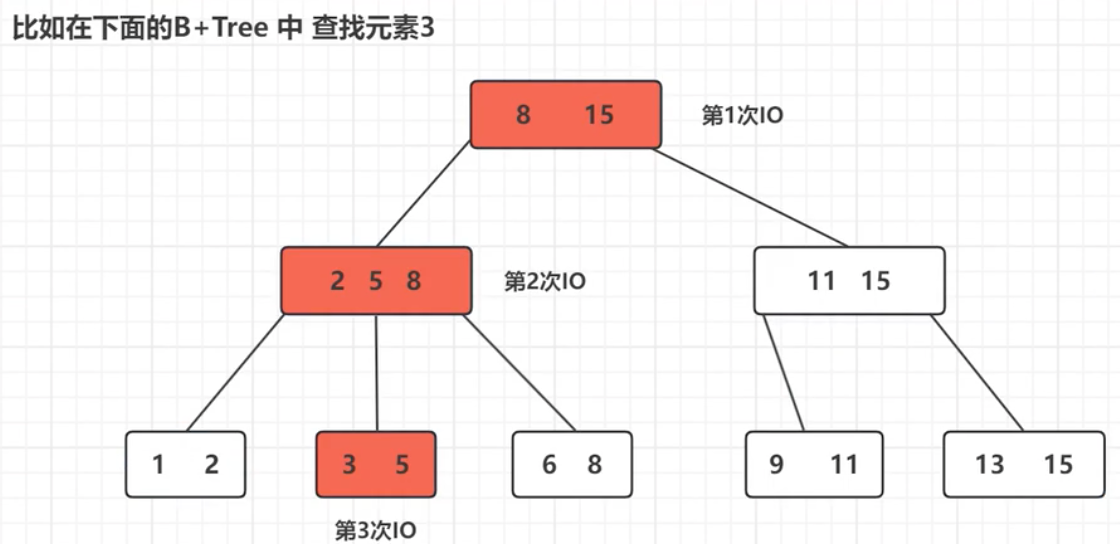
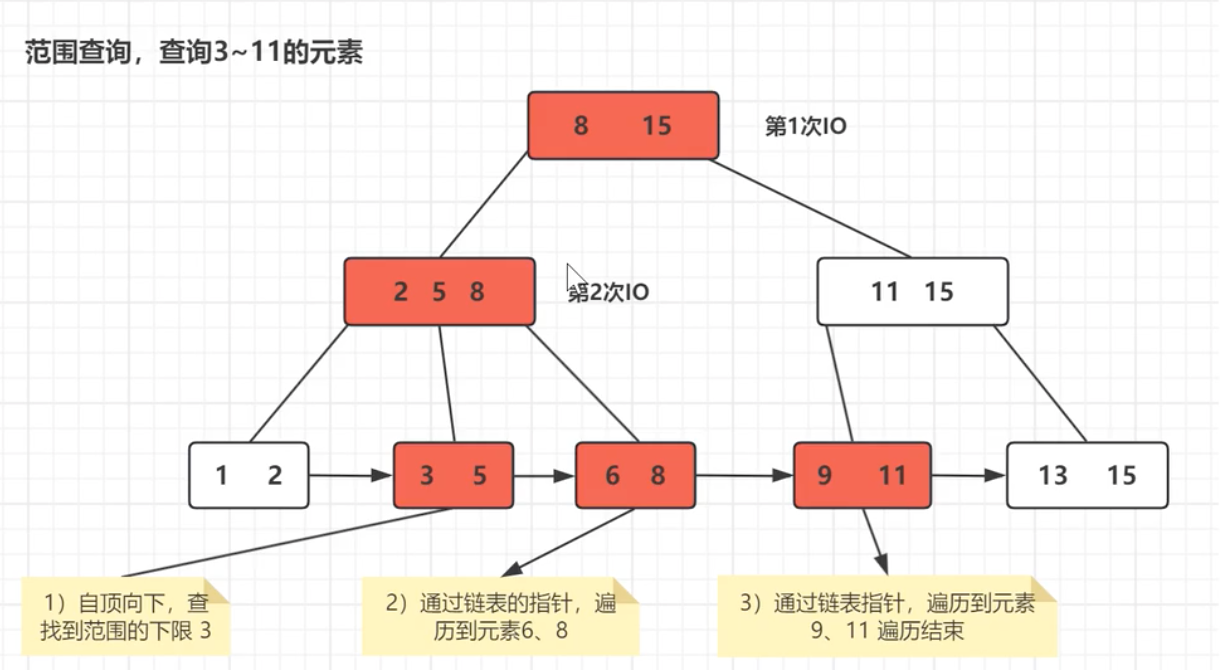
B+Tree的查找操作
两种查找方式:
1.跟B-Tree一样,通过指针实现随机查找,从根节点开始。
2.根据叶子节点进行顺序查找,在一个节点的内部可以实现折半查找,在多个节点之间,因为是通过指针连接的,所以要使用顺序查找。
单个元素的查询:
范围查询:IO次数更少,查询简便。
B+Tree的优势
对于B-Tree,B+Tree具有以下优势:
- B+Tree的中间节点是没有数据,所以同样大小的磁盘页,B+Tree可以容纳更多的节点元素(保存更多的索引),在数据量相同的情况下,B+Tree比B-Tree会更加的矮胖,因此查询时lO次数也就更少。
- B+Tree的查询效率是更加稳定的,B+Tree在查询时必须要找到叶子节点,而B-Tree只需要找到匹配的元素就可以了。因此B-Tree的查找性能是不稳定的,最好的情况是只查根节点,最坏的情况是找到叶子节点,而B+Tree的查找每次都是稳定的。
- B+Tree扫库和扫表的能力更强,如果我们需要根据索引进行数据表的扫描,对B-Tree 需要将整棵树遍历一遍,而B+Tree只需要遍历所有的叶子结点即可 +子节点之间有指针连接)。
- B+Tree排序能力更强,在上面范围查询的例子中,B+Tree天然具有排序的功能
一棵B+Tree可以存放多少数据?
MySQL中将B+Tree的节点的大小,设置为等于一个页(16KB)•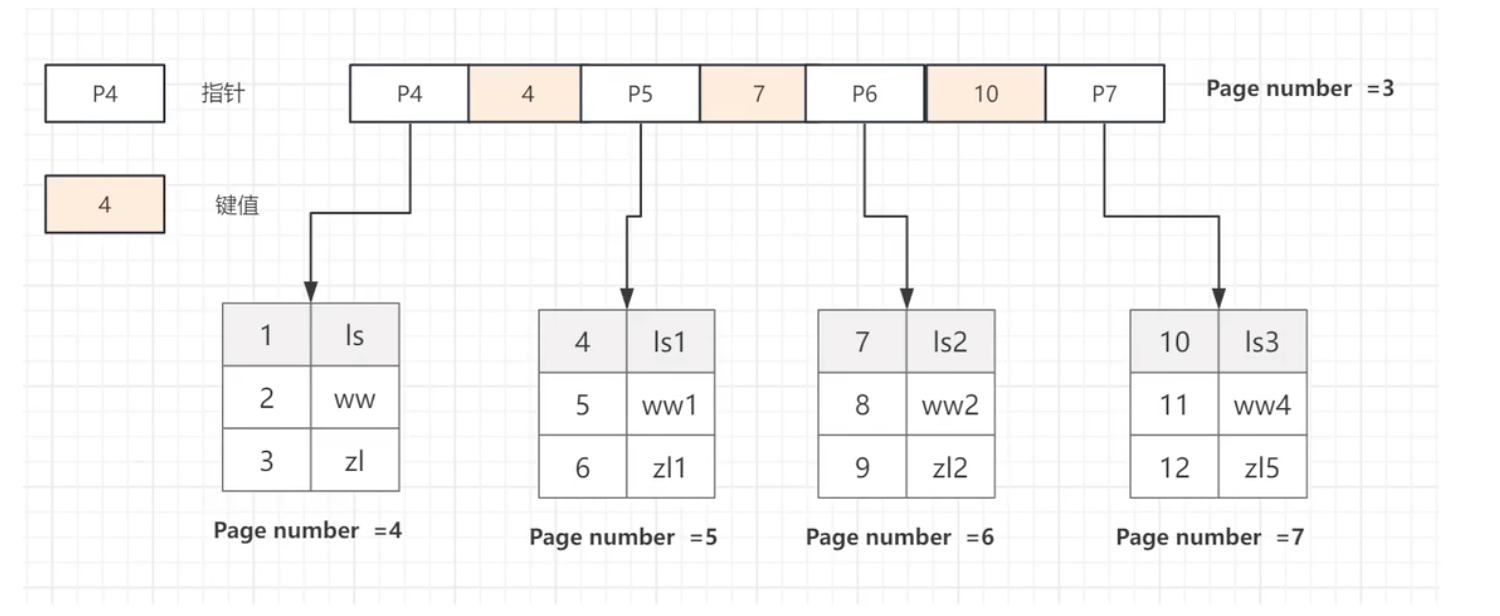
上面是一棵高度为2的B+Tree,存在一个根节点和 若干的叶子节点,那么这棵B+Tree的能够存放的总记录数为:
根节点指针数*单个叶子节点的记录数
计算步骤:
- 计算根节点的指针数:假设表的主键是int类型,占用4个字节,指针大小为6个字节。一个页大概可以存储:
16384/(4b+ 6b)=1638,一个节点最多存储1638个索引指针。 - 计算每个叶子节点存储的记录数:假设一行记录的大小为1KB,那么一页就可以存储16行数据,16KB/ 1KB=16。
- 高度为2的B+Tree可以存放的记录数为:16384 x 16=26208条 数据记录,以此可以推算出高度为3的B+Tree可以存放的记
录数为:1638 x 1638 x 16=4千万条数据。
InnoDB中的B+Tree高度一般为1~3层,就可以满足干万级别的数据存储
LSM-TREE索引 + SSTable
lsm-tree: log structure merge tree ,日志结构合并树
解决写多读少 (利用顺序I/O)的问题,磁盘利用率比B+Tree(一般为50%左右)高(利用compaction)
sstable: Sorted String Table ,排序字符串表
一些前置相关知识
后端开发常见层式结构:时间轮、跳表、LSM-Tree
- 海量并发的定时任务组织:时间轮
- 高并发读写的有序结构组织:跳表
- 空间利用率以及写性能高的磁盘数据组织:LSM-Tree
时间轮:linux内核、skynet、kafka、netty
跳表:redis.lucene(倒排索引)、rocksdb
Ism-tree: leveldb rocksdb分布式关系型数据库 tidb (mysql) cockroachdlb (pg)
时间轮
适用于在多线程环境执行海量并发定时任务
通过指定
- 最小时间精度(最低层级执行时间误差),min_time_precision,
- 最大时间范围(整个时间轮的时间范围,周期时长,超出会出错)max_time_range,
- 层级(决定任务映射次数和每次映射执行时间)level,
定制时间轮框架
当时间轮运行时,最低层级时间指针minlevelPointer每移动一次(经过min_time_precision时间)
就会执行当前时刻上存储的多个任务,当minlevelPointer移动到的当前层级最后一个时间格子的时候
执行完当前定时任务,就会从更高一层级的当前level(+1)Pointer指定的时间格子获取定时任务
给到当前最低层级的每个时间格子(根据具体任务过期时间与当前时间间隔计算该放在哪个时间格子里)
然后等待时间执行
当更高一层级的level(+1)Pointer移动到的当前层级最后一个时间格子的时候
就会从更高两层级的当前level(+2)Pointer指定的时间格子获取定时任务
给到当前level+1层级的每个时间格子,等待时间执行
以此类推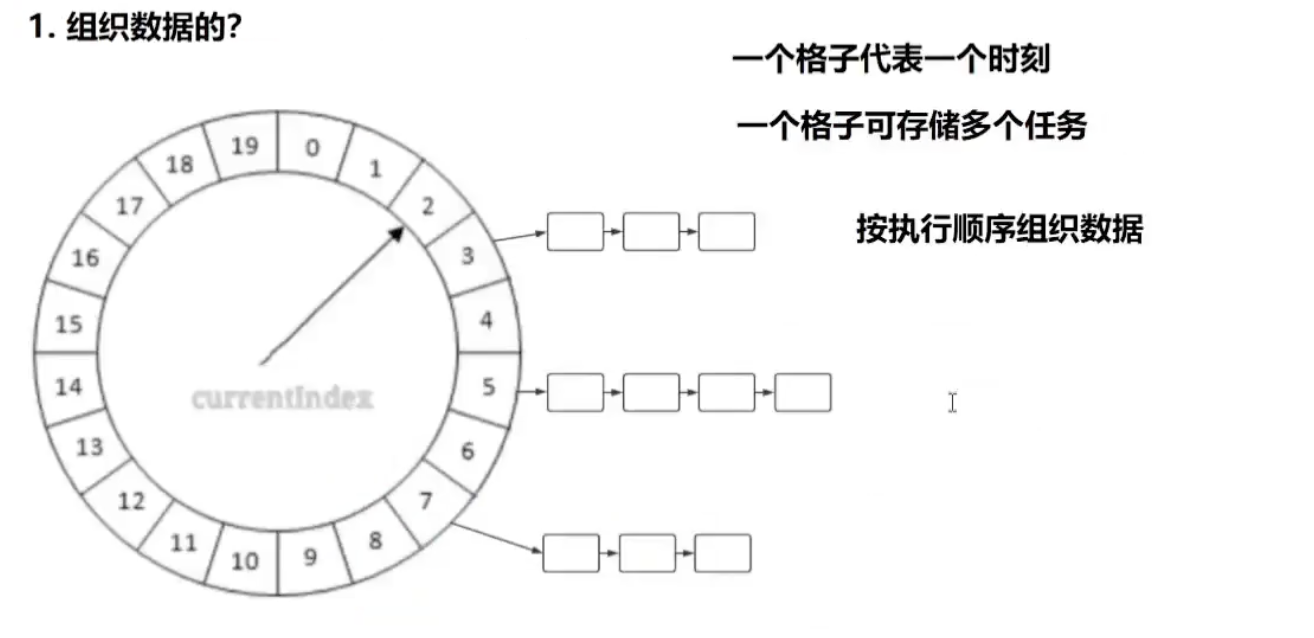
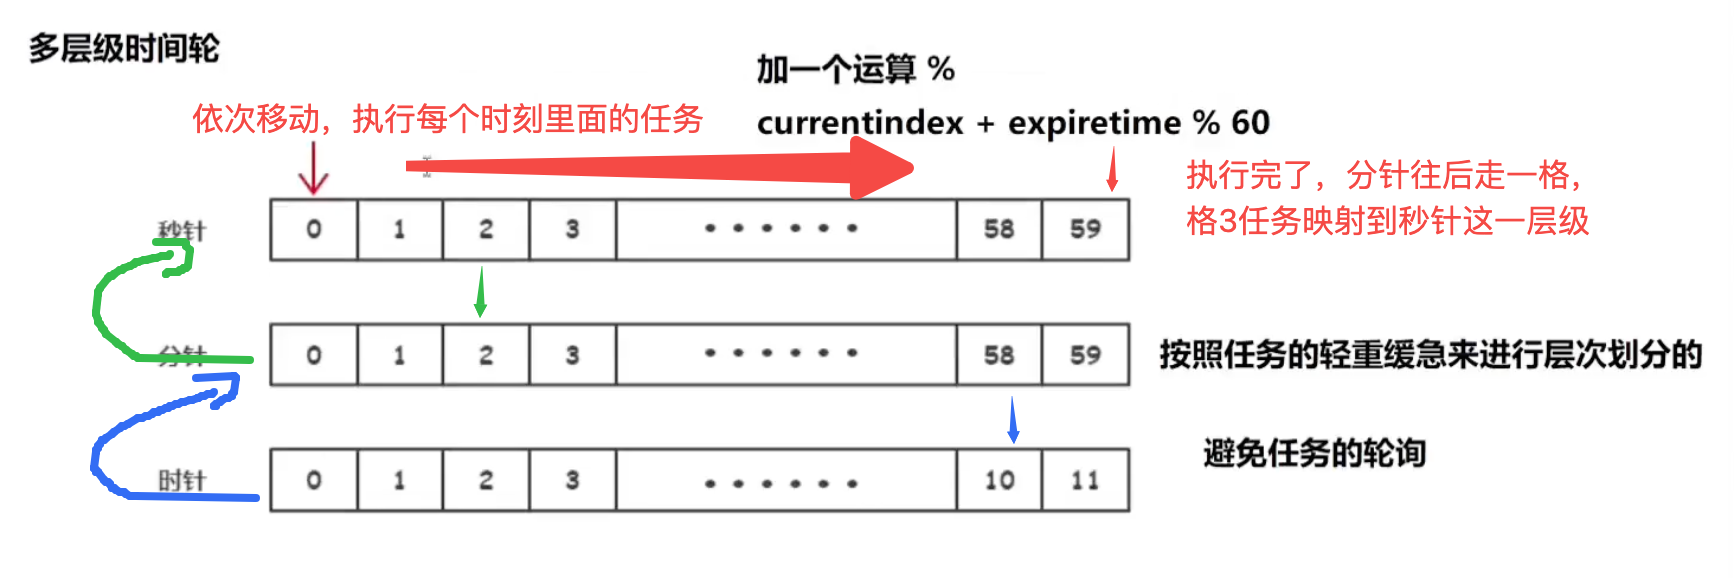
好处:
只用关心最低层级时间周期minlevelPeriod内的任务,即最近minlevelPeriod 时间范围内的任务
不用过早遍历轮询高层层级时间范围里的任务是否要执行
用空间换时间,把大量不同到期时间的任务映射到有限的时间槽(bucket)中,避免对海量任务进行全局排序或反复扫描。
区分任务队列
优先队列:
“我必须知道谁最早到期。”
↓
排序
↓
找最早任务
时间轮:
“我不关心谁最早。”
↓
按照时间分桶
↓
当前时间到了哪个 bucket
↓
处理 bucket
优先队列解决的是“有序性”,时间轮解决的是“时间范围内的快速定位”。
跳表
多层级有序链表
数据的增删改查都要先进行节点的查询,所有数据存在最后一层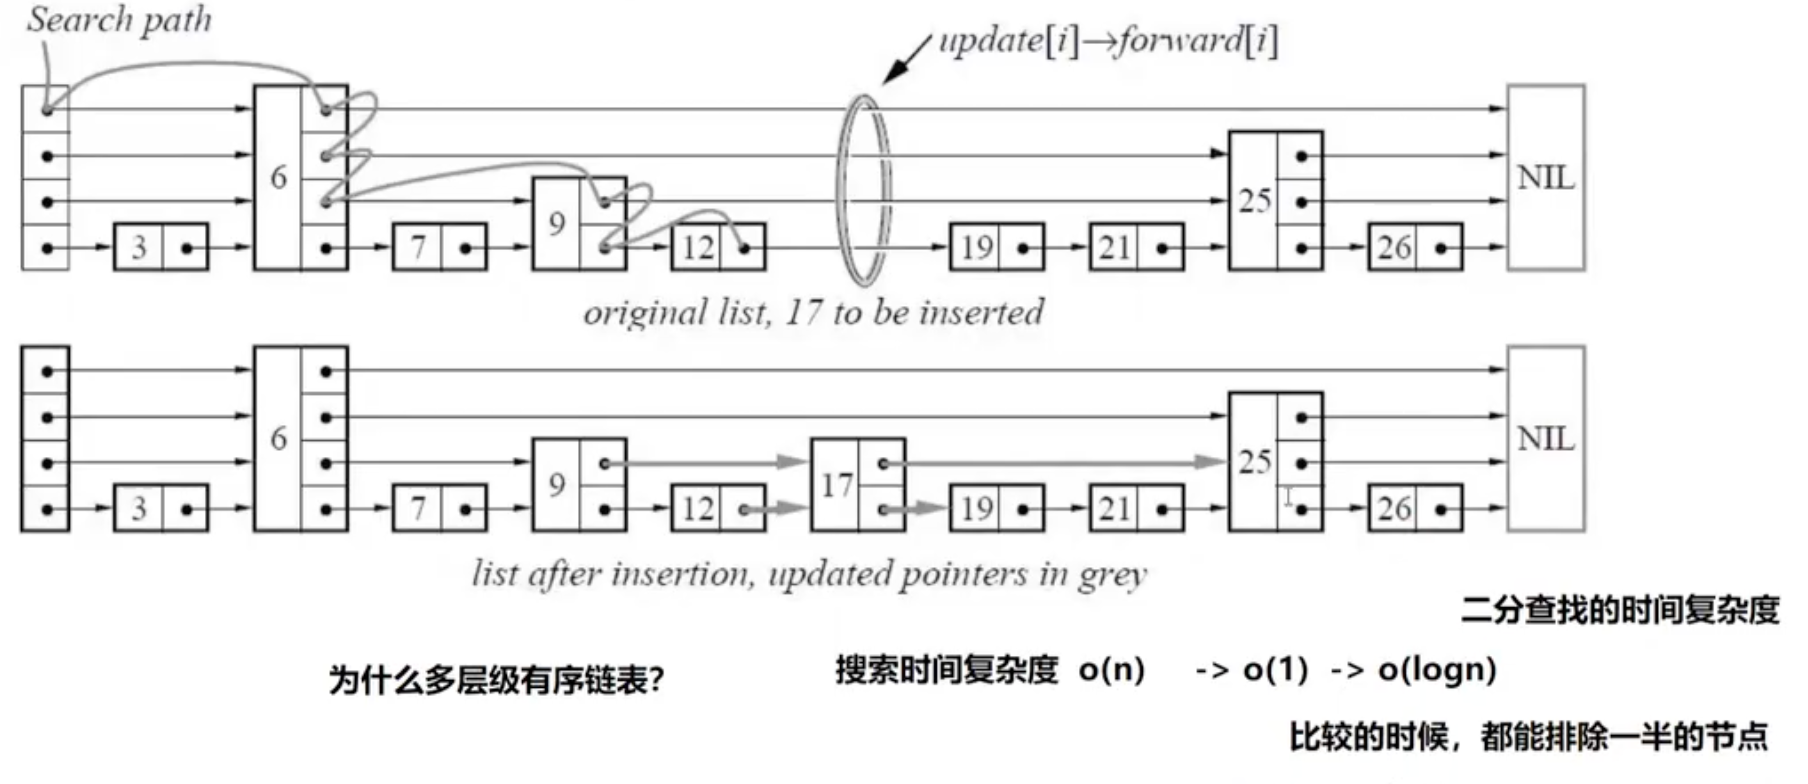
数据查找时层级从上到下依次查找,直到找到匹配的节点或者到达最底层
比如现在要插入17,
第一层找到6再往后找是null, 就往下移动一层接着从6开始找
6-25 17小于25,下移
6-9 17大于9,从9开始找
9-25 17小于25,下移
9-12 17大于12,从12开始找
12-19 17小于19,但已经是最后一层
17应该插入在12和19之间,指针层级随机生成,因为如果始终保持理想多层有序链表,那么每次插入删除都要重新生成层级结构,计算开销大
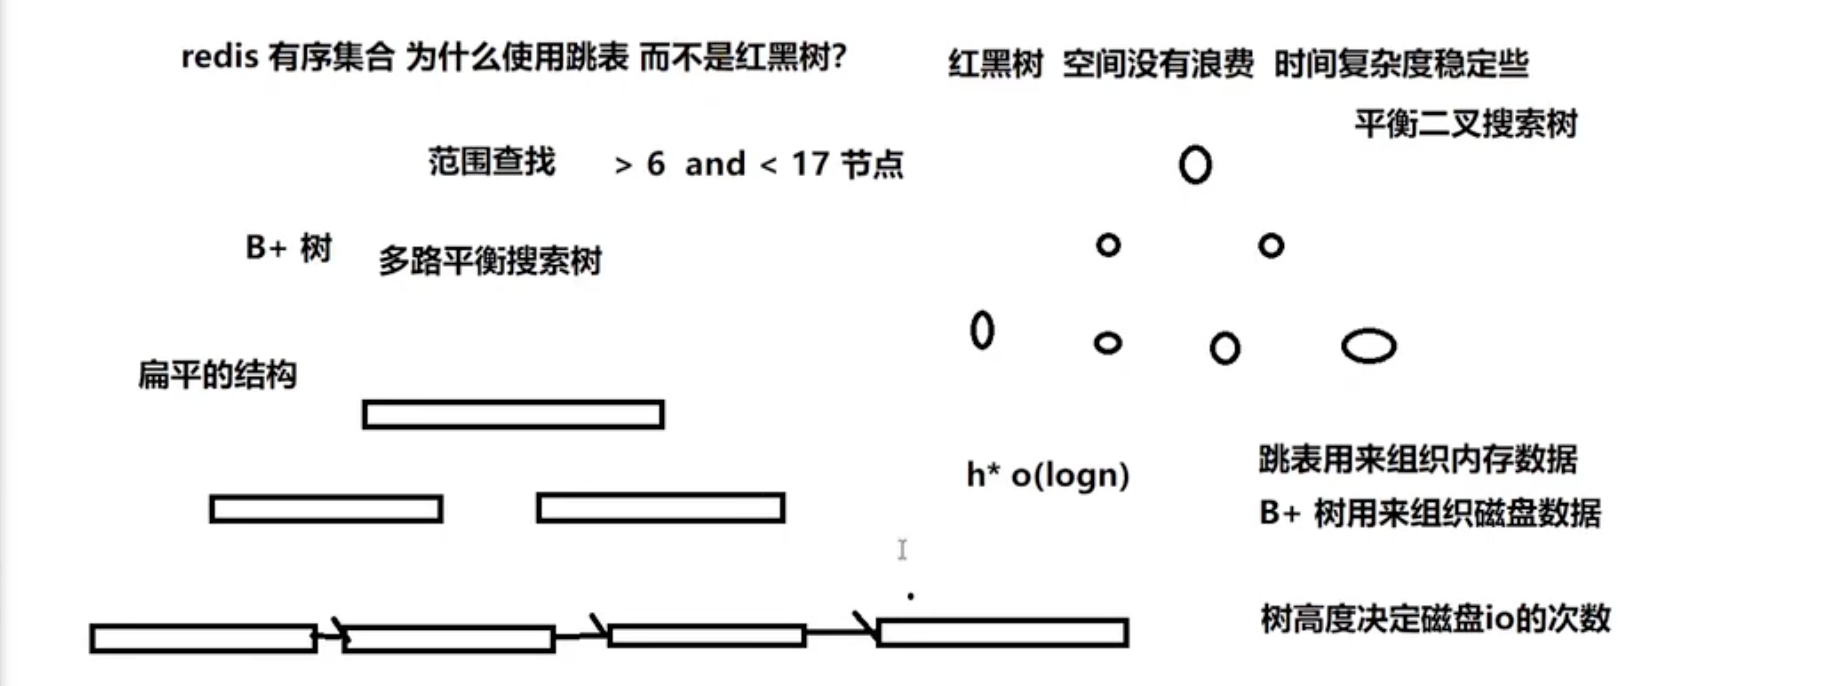
redis 有序集合 为什么使用跳表 而不是红黑树?
红黑树相比跳表本身没有空间浪费,且时间复杂度更稳定,但它本质是平衡二叉树,由于回溯过程复杂,并不能直接用来进行范围查找
B+树相比跳表都是最后一层包含所有数据,但是查找时间复杂度跟树高度有关,比调表更高,二者适用场景不同,
跳表适用于组织内存数据
B+树适用于组织磁盘数据
布隆过滤器
顺序I/O
顺序IO
• 磁盘访问时间:寻道时间 + 旋转时间 + 传输时间; 大概10ms
。寻道时间:8ms~12ms;
。旋转时间:7200转/min(半周 4ms);
。传输时间:50M/s(约0.3ms);
• 磁盘随机 IO < 磁盘顺序IO~内存随机 IO <内存顺序IO(大概10ns);
内存访问速度几乎是磁盘的100w倍
Lsm-tree
【解决写多读少的问题】
B+TREE 添加数据分裂时,空间利用率要占50%,随机IO,写入慢
lsm-tree 为基础的存储引擎空间利用率可以实现30%,顺序IO,写入快,每次追加日志写入
lsm-tree 不是数据结构,而是数据存储组织的一种方式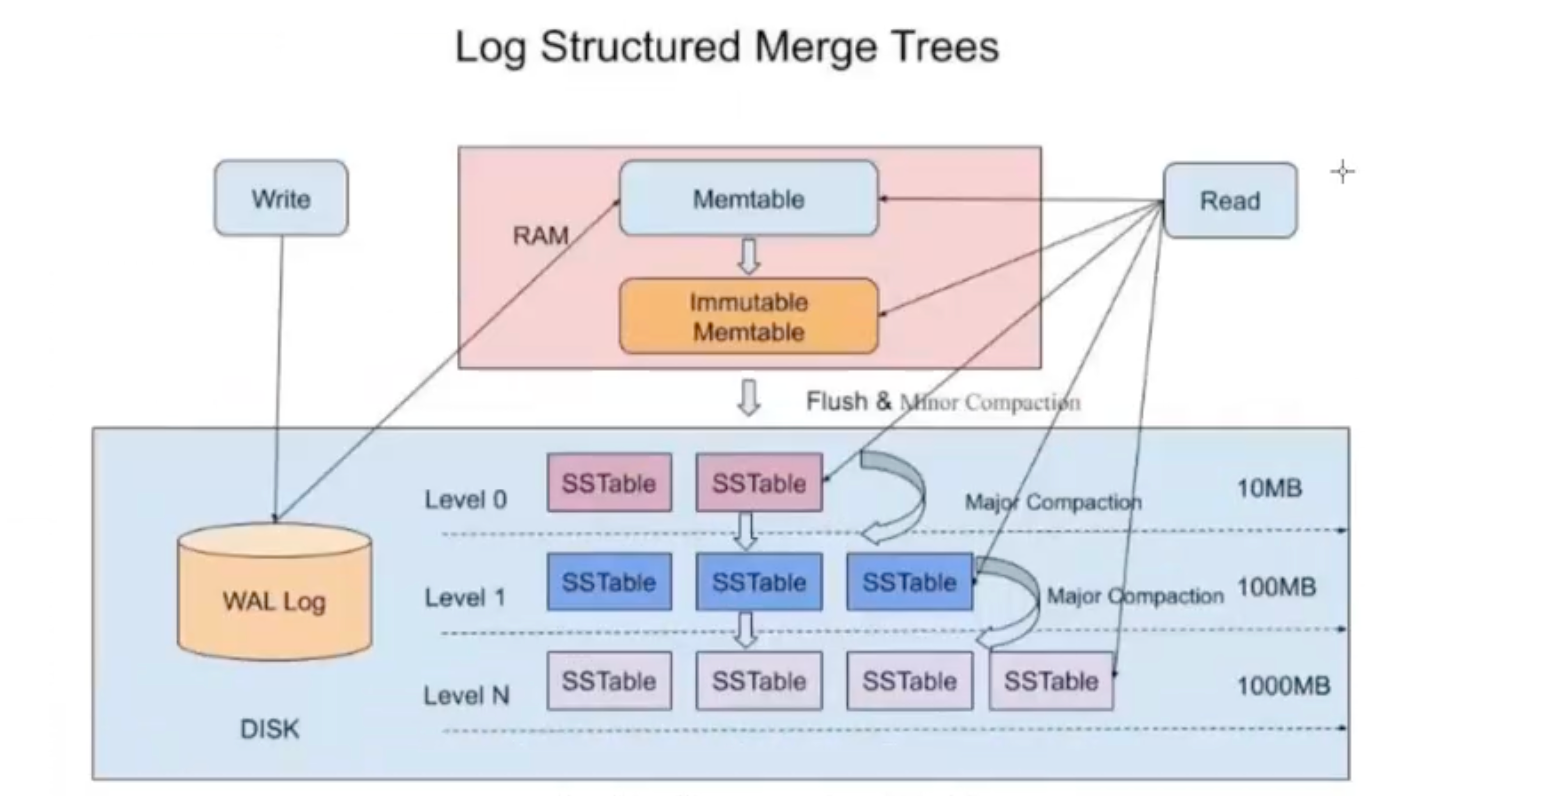
整体运行流程就是当用户写入时,先对磁盘日志进行预写入,然后将数据暂存在内存里面的Memtable(跳表)中
当Memtable 快要写满时,将数据固定下来变成静态数据,存到内存 Immutable Memtable (跳表) 中,不再支持写入,只读,等待刷进磁盘中
数据进入磁盘中以level0 ssTable 形式存在,有序结构,多个ssTable 中 多个操作可能针对同一个key 即同一条数据多次操作,造成数据处理重复
这时可以进行level 0层ssTable数据 compaction,减少数据冗余,形成 level 1 层数据,
level 1 层数据合并压缩排序再生成level 2 以此类推直到level n , n 一般为7
这样到level n 基本可以保证该层没有重复的数据,几乎占整体数据的 90%
同时对于经常操作的数据使用在整个架构的上方,现在内存中,然后在level 0 中
这样对于读取来说,热key 甚至可以直接在内存中读到
另外对于不同层的数据读取,可以引入布隆过滤器判断数据是否存在,误差可控
稀疏索引
稀疏索引不是给“列”分类,而是给“索引项”分类:索引不为每一条数据都建立索引项,只为部分数据建立索引项。
稀疏索引(Sparse Index) 是一种索引结构,它不为表中的每一行数据都建立索引项,而是为部分数据块(如数据页)或特定间隔的数据建立索引条目。
你可以把它理解为书的目录页——目录只列出每个章节的起始页码,而不是每个字、每句话出现的页码。
1. 稀疏索引 vs. 稠密索引
| 维度 | 稀疏索引 | 稠密索引(Dense Index) |
|---|---|---|
| 索引条目数量 | 只为部分数据建立索引(如每个数据页一条) | 为表中的每一行数据都建立一个索引项 |
| 存储空间 | 小,占用空间少 | 大,可能和表数据相当甚至更大 |
| 查找过程 | 先通过索引定位到近似位置,再在数据块内顺序扫描找到目标 | 通过索引直接定位到具体行 |
| 适用场景 | 数据量大、索引列值有序且变化不频繁 | 需要精确定位、对查询响应时间要求极高 |
| 典型例子 | 文件系统的目录索引、数据库的聚簇索引(主键) | 辅助索引(二级索引)的叶子节点 |
2. 稀疏索引在数据库中的典型应用
(1)InnoDB 的聚簇索引(主键索引)
InnoDB 的聚簇索引本质上是一个稀疏索引 + 稠密索引的混合体:
- B+Tree 的内部节点:只存储每个子页的最小键值作为索引条目 → 这是稀疏索引。
- B+Tree 的叶子节点:存储了完整的行数据,且所有数据都在这层 → 叶子节点内部是稠密的(所有行都存在)。
当你通过主键查找时,过程是:
- 从根节点开始,利用稀疏的索引条目(每个节点的最小键值)快速定位到目标数据页。
- 到达叶子节点(数据页)后,在页内进行顺序扫描或二分查找找到具体行。
(2)文件系统中的目录索引
操作系统中的文件目录也是一种稀疏索引:
- 每个目录项只记录文件名和对应的数据块起始地址。
- 查找文件时,先在目录中定位到文件元数据,再根据元数据去数据区读取具体内容。
3. 为什么需要稀疏索引?
✅ 优点
| 优点 | 说明 |
|---|---|
| 节省存储空间 | 索引条目数量远少于数据行数,特别适合大表场景。 |
| 降低维护成本 | INSERT/UPDATE/DELETE 时,不需要频繁更新索引条目(只在数据页分裂或合并时才调整)。 |
| 内存友好 | 索引体积小,更多索引数据可以缓存在内存中,提升查询速度。 |
❌ 缺点
| 缺点 | 说明 |
|---|---|
| 查询效率略低 | 定位到数据页后,还需要在页内进行扫描,无法像稠密索引那样一步到位。 |
| 不适合等值查询为主的场景 | 如果大量查询是 WHERE id = 12345 这种精确查询,稠密索引更快。 |
4. 稀疏索引 vs. 覆盖索引
| 维度 | 稀疏索引 | 覆盖索引 |
|---|---|---|
| 关注点 | 如何减少索引条目数量(降低存储) | 如何避免回表(提升查询速度) |
| 索引内容 | 只记录关键位置信息(如页最小键值) | 索引中包含查询所需的所有列数据 |
| 目标 | 节省空间,支持范围查找 | 提升查询效率,减少 I/O |
| 能否同时存在 | ✅ 可以。一个联合索引如果是稀疏的(如页级索引),同时又包含了查询所需的所有列,那它既是稀疏索引又是覆盖索引。 |
5. 实际例子
场景:用户表 users,主键 id 自增列
1 | 数据页1:id 1~100 |
稀疏索引(聚簇索引内部):
| 索引条目 | 指向 |
|---|---|
1 |
数据页1 |
101 |
数据页2 |
201 |
数据页3 |
查询
SELECT * FROM users WHERE id = 150:- 在稀疏索引中找到
101(最大的 ≤ 150),定位到数据页2。 - 在数据页2内顺序扫描,找到 id=150 的行。
- 在稀疏索引中找到
查询
SELECT * FROM users WHERE id BETWEEN 50 AND 250:- 稀疏索引定位到起始页(数据页1)。
- 顺序扫描所有数据页(1、2、3),直到超出范围。
6. 什么时候该考虑稀疏索引?
| 推荐使用 | 不建议使用 |
|---|---|
| 表数据量极大(亿级) | 数据量小(几千行),索引开销可忽略 |
| 存储空间有限 | 查询以精确等值查询为主(如 WHERE id = xxx) |
| 查询以范围查询或全表扫描变种为主 | 需要频繁更新索引列值(维护成本高) |
| 索引列值有序且变化不频繁 | 索引列值无序(如 UUID),无法利用稀疏索引的有序性 |
总结
- 稀疏索引是一种用空间换时间的反向策略——它牺牲了一点查询精度(需要额外扫描),换来了更小的索引体积和更低的维护成本。
- 在数据库中,聚簇索引(主键)天然就是稀疏索引,而辅助索引(二级索引)通常是稠密索引。
- 如果你在建表时选择了自增主键,实际上已经在享受稀疏索引带来的好处了——主键索引的 B+Tree 内部节点就是稀疏的,大大减少了内存占用和 I/O 次数。
聚簇索引
索引的分类:
1.按照字段的特性分类:主键索引、普通索引、前缀索引。
2.按照数据结构分类:B+Tree索引、Hash索引。
3.按照物理存储方式分类:聚簇索引、辅助索引(二级索引)。
聚簇索引的定义
聚簇索引并不是一种单独的索引类型,聚簇索引是一种数据存储的方式。
例如InnoDB的聚簇索引使用的数据结构就是B+Tree存储索引和数据。
• ‘聚簇”含义:表示数据行和相邻的键值是紧凑的存储在一起。
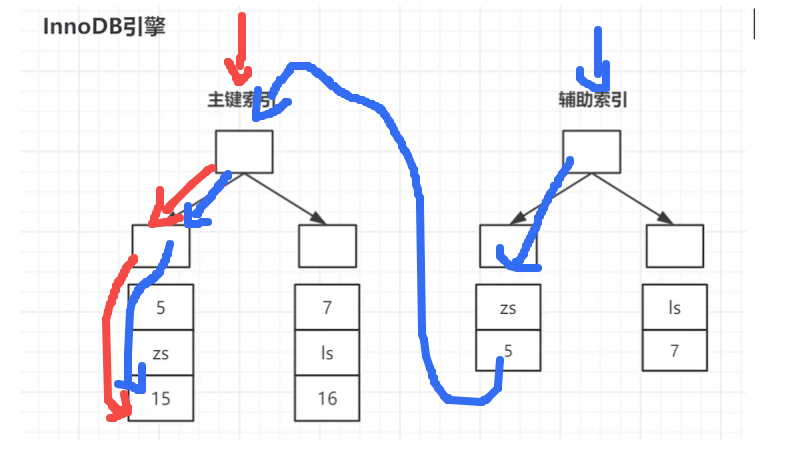
• 辅助索引(二级索引):叶子节点是不会保存引用行的物理地址的,而是保存行的主键值
聚簇索引 VS 非聚簇索引
• 聚簇索引(主键索引):将数据存储与索引放到了一起,索引结构的叶子节点保存了具体的行数据。
• 非聚簇索引:将数据与索引分开存储,索引结构的叶子节点存储的是指向数据行对应的地址。
从存储引擎的角度去看,聚簇索引和非聚簇索引的区别:
• InnoDB存储引擎【聚簇索引】
。在InnoDB存储引擎中,默认使用B+Tree存储索引和数据,InnoDB中利用主键创建的索引,就是聚簇索引。
。聚簇索引的二级索引:叶子节点是不会保存引用行的物理地址的,而是保存行的主键值
。对于聚簇索引,数据的物理存放顺序与索引顺序是一致的(主键必须是自增id)。
•MyISAM存储引擎【非聚簇索引】
。在MyISAM存储引擎中,默认也是B+Tree索引,但是主键索引和辅助索引都是非聚簇索引。
。非聚簇索引不管是主键索引还是二级索引,其索引结构的叶子节点保存的都是一个指向对应行记录的物理地址。
。非聚簇索引中辅助索引的检索无需访问主键索引。
。非聚簇索引的存储引擎,表数据存储与索引顺序是无关
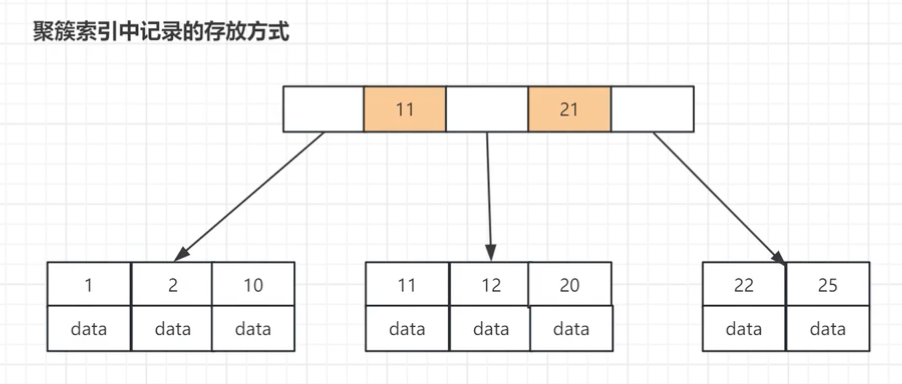
• InnoDB聚簇索引就是按照主键索引的顺序构建B+Tree。B+Tree的叶子节点就是行记录,行记录和主键值紧凑的存储在一起
的。
•InnoDB中主键索引就是数据表本身。主键索引中存放了整张表的数据。
InnoDB表中 要求必须要有聚簇索引:
。如果表定义了主键,主键索引就是聚簇索引。
。 如果表没有定义主键,则第一个非空unique列 作力聚簇索引。
• 否则以上都没有,InnoDB会重建一个隐藏的row-id 作为聚簇索引
回表
回表是数据库执行查询时的一种操作过程,简单来说就是:先通过辅助索引找到主键值,再根据主键值到主索引(聚簇索引)中取回整行数据。
这个动作之所以叫“回表”,是因为数据读取路径走了两步(索引 -> 主键 -> 数据行),相当于“返回”到主表(聚簇索引)中去查找。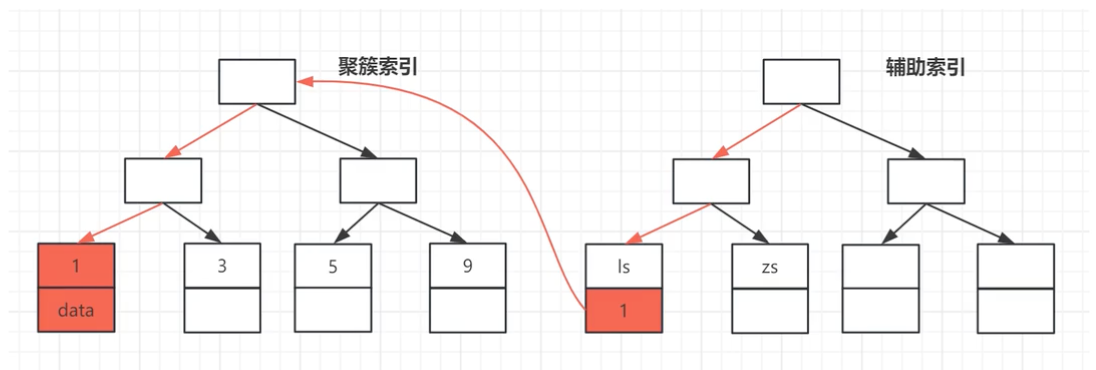
如何解决回表问题?答:使用覆盖索引。(覆盖索引: 所查询信息在当前索引值中能找到,“索引和查询之间的关系”,而不是一种索引结构。)
• 如果一个索引包含了所要查询的所有的字段值(不需要回表),这个索引就是覆盖索引。
如何实现覆盖索引?
•将被查询的字段建立联合索引,这样就可以直接返回索引中的数据了,避免了去聚簇索引中去定位行记录。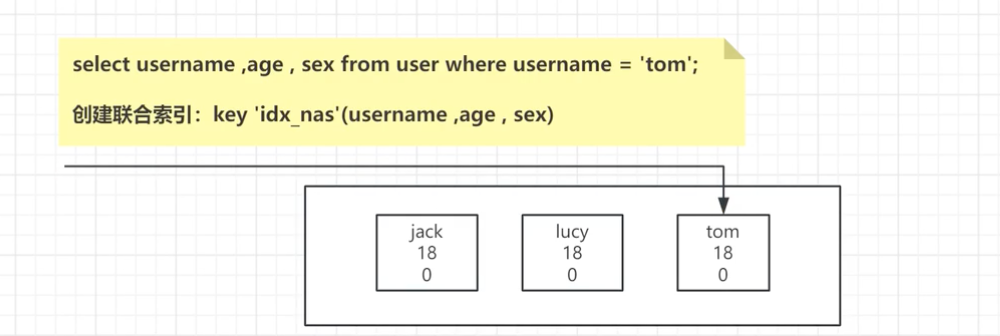
索引下推
用于查询优化。可以在索引遍历的过程中,对索引中包含的字段先做判断,不符合条件的记录过滤,作用就是减少回表的次数
将存储引擎层(Engine)的过滤条件下推到索引遍历的过程中,提前过滤掉不符合条件的记录,从而减少回表次数
比如下面在辅助索引中添加age 信息后,同时满足age 要求才会去主键索引中获取完整行数据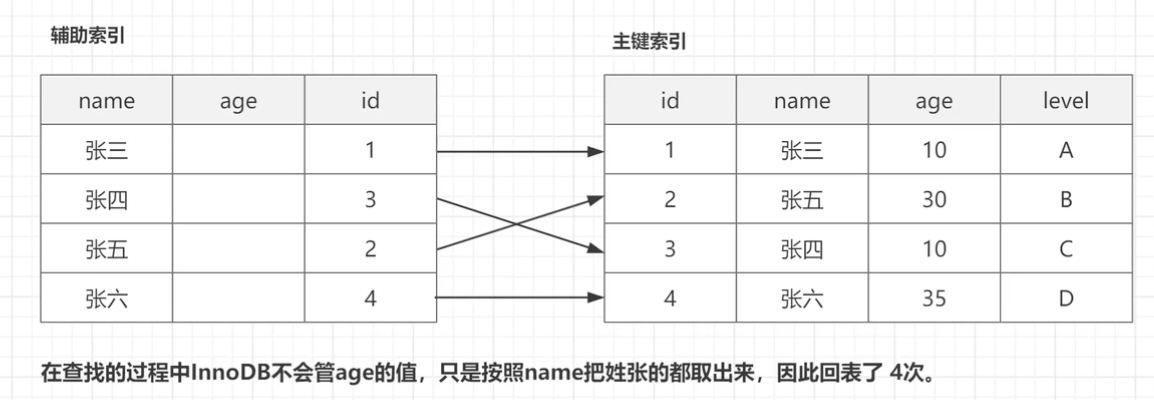
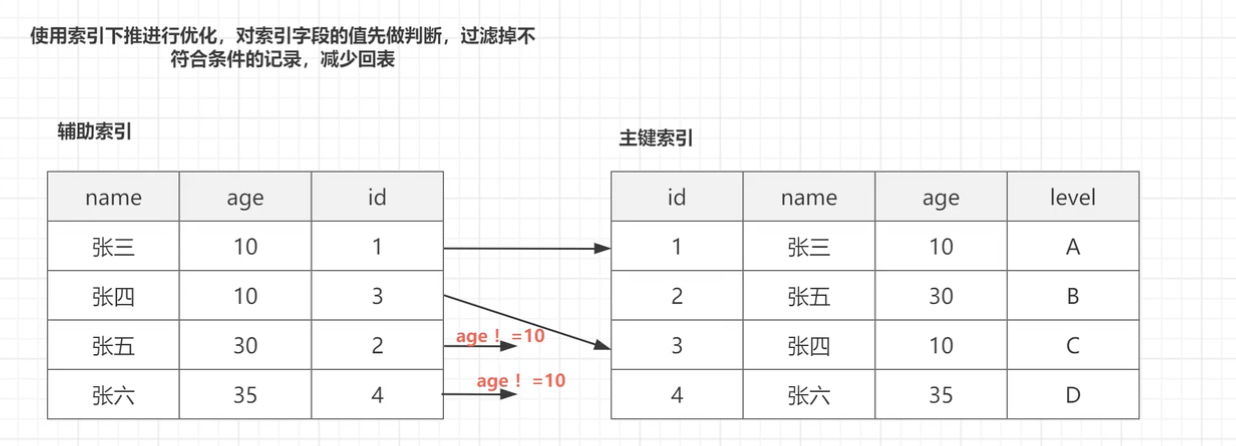
在不使用 ICP 时,存储引擎会先通过索引把所有满足“索引键范围”的记录全部回表,然后在 Server 层再过滤;使用 ICP 后,存储引擎在索引遍历时就直接把不满足条件的记录过滤掉,只有满足条件的才回表。
数据库主键类型选择
自增的优点
•字段长度比UUID小。
•在写的方面,由于是自增,新增的数据永远是在后面,有序,这点对性能有很大的提升。
•数据库自动编号,速度快,增量增长按顺序存放,检索比较快。
•数字型,占用的空间小,容易排序。
自增的缺点
•由于自增,比较容易通过网络爬虫获取当前系统的业务量。
•高并发场景下,竞争自增锁会降低数据库吞吐能力。
•数据迁移或者是分库分表场景下,自增方式不再适合
自增主键的本质是单库单表内的局部唯一,它依赖单个数据库实例的全局计数器(由 MySQL 的 AUTO_INCREMENT 机制维护)。
一旦数据被拆分到多个库/表,或需要合并多个数据源,这个”局部唯一”就失效了,会导致主键冲突、无法全局排序、迁移困难等问题。
因此分库分表和迁移场景下,需要改用全局唯一 ID 生成方案(如雪花算法)
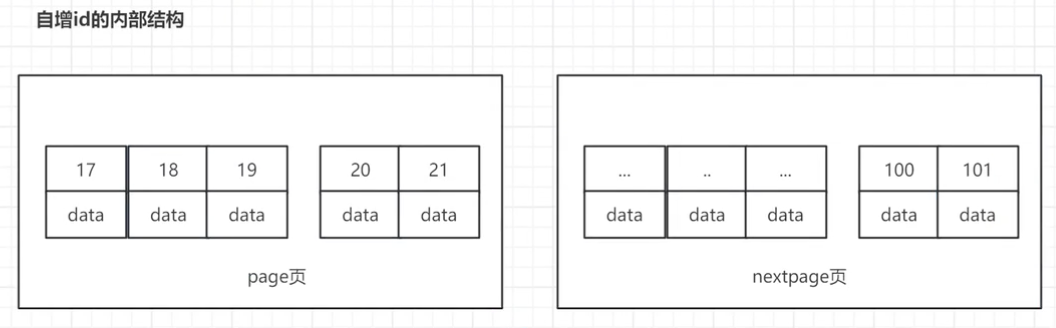
自增ID的内部结构:
新增的行一定会在原有最大数据行的下一行,MySQL的寻址定位很快,不会为计算新行的位置而作出额外的消耗,较少了页的分裂。
UUID的优点:
•主键在任何时候都不会冲突。进行分库分表,还是做合并存储的时候,都能保证主键全局的唯一性。
•可以在应用层生成,提高数据库的吞吐能力。
UUID的缺点:
•与自增相比,最大的缺陷就是随机IO。
•字符串类型要比整数类型更加消耗空间,而且要比整数类型操作慢
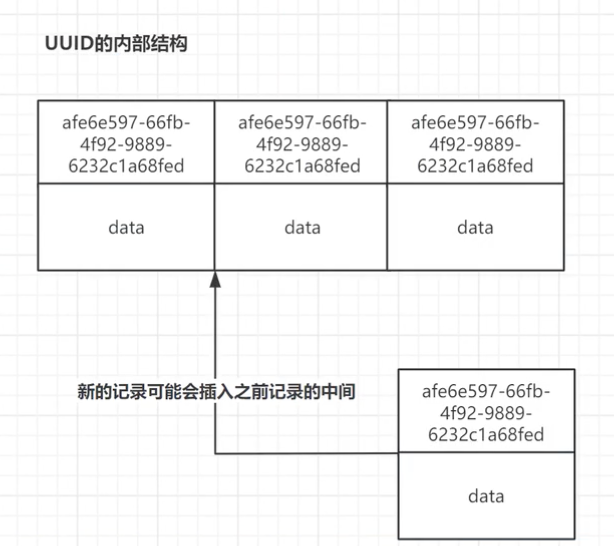
UUID的内部结构:
如果是uuidInnoDB无法做到总是把新插入的行放到索引的最后,每次都需要为新的行寻找合适的位置,分配新的空间。
还包括一些问题:
• 产生大量的随机IO
• 页分裂操作频繁
页分裂:
页分裂(Page Split) 是数据库(如 MySQL InnoDB)或操作系统文件系统中,当数据页(Page)已满,却需要插入新数据时,系统被迫将当前页拆分成两个页的过程。
简单来说:一个数据页装不下了,必须分一分为二,腾出空间给新数据。
总结:
如果是使用InnoDB应该尽可能的选择主键自增顺序插入。
但是如果是在分库分表场景下,分布式主键ID的生成方案优先选择:雪花算法生成全局的唯一ID。
雪花算法:
一种开源分布式 ID 生成算法,在分布式系统中生成全局唯一且有序的 ID,非常适合作为分库分表后的主键 ID 或全局订单号
它生成的 ID 是一个 64 位的长整型(Long)数字,由以下部分组成:
- 1位符号位:固定为 0,保证 ID 是正数。
- 41位时间戳:记录毫秒级时间,可以使用约 69 年,让 ID 整体趋势递增。
- 10位机器标识:通常拆分为 5 位数据中心 ID 和 5 位机器 ID,最多支持 1024 个节点,保证不同机器生成的 ID 不重复。
- 12位序列号:同一毫秒内可生成 4096 个不同的 ID,应对高并发场景。
小结
聚簇索引的优点:
1.可以将相关的数据保存在一起。
2.数据访问更快。
3.使用覆盖索引进行扫描查询时,可以直接使用叶节点中的主键值。
4.辅助索引使用的是主键作为指针,不是使用地址值。
聚簇索引的缺点:
- 随机主键会导致页分裂问题(主键生成选择UUID的情况)
- 使用辅助索引查询时,需要回表
多维索引(multi dimensional index)
一种为了高效处理基于多个属性(维度)进行查询而设计的数据库索引结构,是处理多条件、空间、向量等复杂查询需求的利器。无论是用树结构的R树、KD树,还是搜索引擎风味的倒排索引,或是OLAP的数据立方体,它们的目标都一样:在海量数据中,让多维度、组合式的查询变得更快。
相关实现数据结构:
R-Tree
R*-Tree
KD-Tree
QuadTree
GiST / SP-GiST
| 维度 | 联合索引 (Composite Index) | 覆盖索引 (Covering Index) | 多维索引 (Multi-Dimensional Index) |
|---|---|---|---|
| 核心目的 | 如何排序——把多个列拼成一个索引键,决定查询时能走哪个索引 | 如何偷懒——让索引里直接包含查询要的数据,避免回表 | 如何划分空间——把多个列看作多维空间,决定如何快速定位数据 |
| 底层结构 | 单棵 B+Tree,键值是 (col1, col2, ...) 拼接而成 |
不特定结构,任何索引(联合或单列)只要包含所需字段即可 | R-Tree、KD-Tree、倒排索引等,将数据映射为空间中的点或区域 |
| 核心规则 | 最左匹配原则:只有索引最左边的列能用上,跳过一个列,后面的就失效 | 无特殊规则:只要 SELECT 的列都在索引里,就能生效 |
无固定顺序要求:可以对所有维度同时进行范围或邻近查询,没有“最左”限制 |
| 典型查询 | WHERE a = 1 AND b = 2WHERE a = 1 ORDER BY b |
SELECT a, b FROM t WHERE a = 1 (无需回表) |
WHERE x BETWEEN 0 AND 10 AND y BETWEEN 20 AND 30(查找矩形区域) |
| 性能特点 | 对 = 和范围查询效果好,但受顺序限制,有一定维护开销 |
极高,直接省去随机 I/O,是查询优化的首选手段 | 对多维范围查询高效,但结构复杂,维护成本高,非所有数据库都支持 |
用例子加深理解
假设有一张地图数据表 places,有 x(经度)、y(纬度)、name 三个字段。
1. 联合索引:INDEX idx_xy (x, y)
- 它的排序规则是:先按 x 排,x 相同再按 y 排。
- 查询
WHERE x = 1 AND y = 2:能高效利用索引(先定位 x=1,再在结果中找 y=2)。✅ - 查询
WHERE y = 2 AND x = 1:优化器通常能调整顺序,也能用上。✅ - 查询
WHERE y = 2:由于 y 不是联合索引的最左列,这个索引基本失效,无法用于减少扫描范围。❌ - 这是典型的一维有序列表(先排第一列,再排第二列)。
2. 覆盖索引:INDEX idx_xy_cover (x, y, name)
- 当我们执行
SELECT x, y, name FROM places WHERE x = 1时,查询所需的所有列 (x,y,name) 都包含在这个联合索引中。 - 因此,数据库直接读取索引页就能返回结果,完全不用去读原始数据行(主键聚簇索引),省去了昂贵的回表操作。这就是“覆盖”的含义。
3. 多维索引(如 R-Tree):SPATIAL INDEX idx_xy_mdi (x, y)
- 它将
(x, y)视为二维平面上的一个点,所有点构成一个空间。 - 查询
WHERE x BETWEEN 0 AND 10 AND y BETWEEN 20 AND 30:这是个典型的二维矩形范围查询。多维索引能直接在这个平面空间里进行搜索,同时利用 x 和 y 两个维度的信息来剪枝,效率很高。 - 而联合索引面对这个查询,通常只能利用 x 的范围(0-10)来定位,然后对命中的每一行再检查 y 是否在 20-30 之间,无法同时利用两个维度的范围信息,效率相对较低。
一句话总结核心区别
- 联合索引:解决多条件排序和查找的问题,但受“最左匹配”约束。
- 覆盖索引:解决减少数据读取的问题,是一种避免回表的优化技巧。
- 多维索引:解决多维度同时过滤的问题,无顺序限制,专为空间、向量等复杂场景设计。
所以,在实际业务中,它们经常是组合使用的。比如,创建一个联合索引,恰好覆盖了查询需要的所有列,那这个联合索引同时也是一个覆盖索引。而当你遇到地理围栏、图像特征匹配等场景时,才需要考虑引入多维索引这种更专业的结构。