创建策略
索引在查询中的作用
一个索引就是一颗B+Tree,索引可以让我们的查询快速定位和扫描到我们需要的数据记录上,加快查询速度。
索引列的类型尽量小
1)定义表结构时一定会指定列类型,举例说:针对整数类型,就有很多选项:tinyint、smallint、int、bigint.。占用的存储空间是逐渐增加的。
2) 选择较小数据类型创建列的好处
•使用较小的数据类型,可以在查询时带来性能上的一些提升。
•较小的数据类型占用的索引存储空间比较少的,一个数据页就可以容纳更多的数据记录,从而減少磁盘/0性能的消耗。同时也意味着内存中,是可以有更多的数据页缓存,从而提高数据库的读写效率。
3)主键类型选择小类型非常重要
•主键值,不仅是在聚簇索引中存储,其他的二级索引的节点上也会存储主键值。选择较小的主键数据类型,可以节省存储空间,并且提高查询效率。
—>索引列类型尽量小好处
- 有利于提高查询效率
- 减少存储空间,一个是自身的存储空间,一个是作为主键在二级索引中的存储空间。
索引列的选择性尽量高
索引列的选择性是指在一个数据库表中,某个特定列的值的唯一性和多样性程度。
索引列的选择性衡量方式:选择性=不同值的数据量/总行数,选择性通常是介于0~1之间的值。
选择性高低的区别:
•选择性越高,表示该列中的值越多样化,就更加接近唯一。
•选择性越低,表示该列中重复值比较多。
选择性高的索引,可以让MySQL在查询时过滤掉更多的行。唯一性索引的选择性1,这是最好的索引选择性,性能也是最好的
1 | -- 索引选择性计算方式 |
前缀索引
对于不能直接使用全量值作为索引列的数据类型,比如字符串类型
通过选取不同的前n个数据作为索引内容,计算索引列的选择性后,选择索引列的选择性最高的n 值,作为最后进行索引的数据计算
针对于blob、text、很长的varchar类型,MySQL是不支持索引它们全部的长度,需要建立前缀索引.1
2-- 前缀索引的创建
alter table tablename add key index(column(n))
前缀索引的缺点:前缀索引是一种能使索引更小,更快的有效办法,但是它的缺点也很明显,MySQL中无法使用前缀索引做
order by、group by,也无法使用前缀索引进行索引覆盖。
前缀索引使用的注意事项:使用的是较短的前缀,可能会降低索引的选择性,影响查询效率。所以在使用前缀索引之前,需要仔
细考虑分析数据分布,确保前缀长度的选择是合适
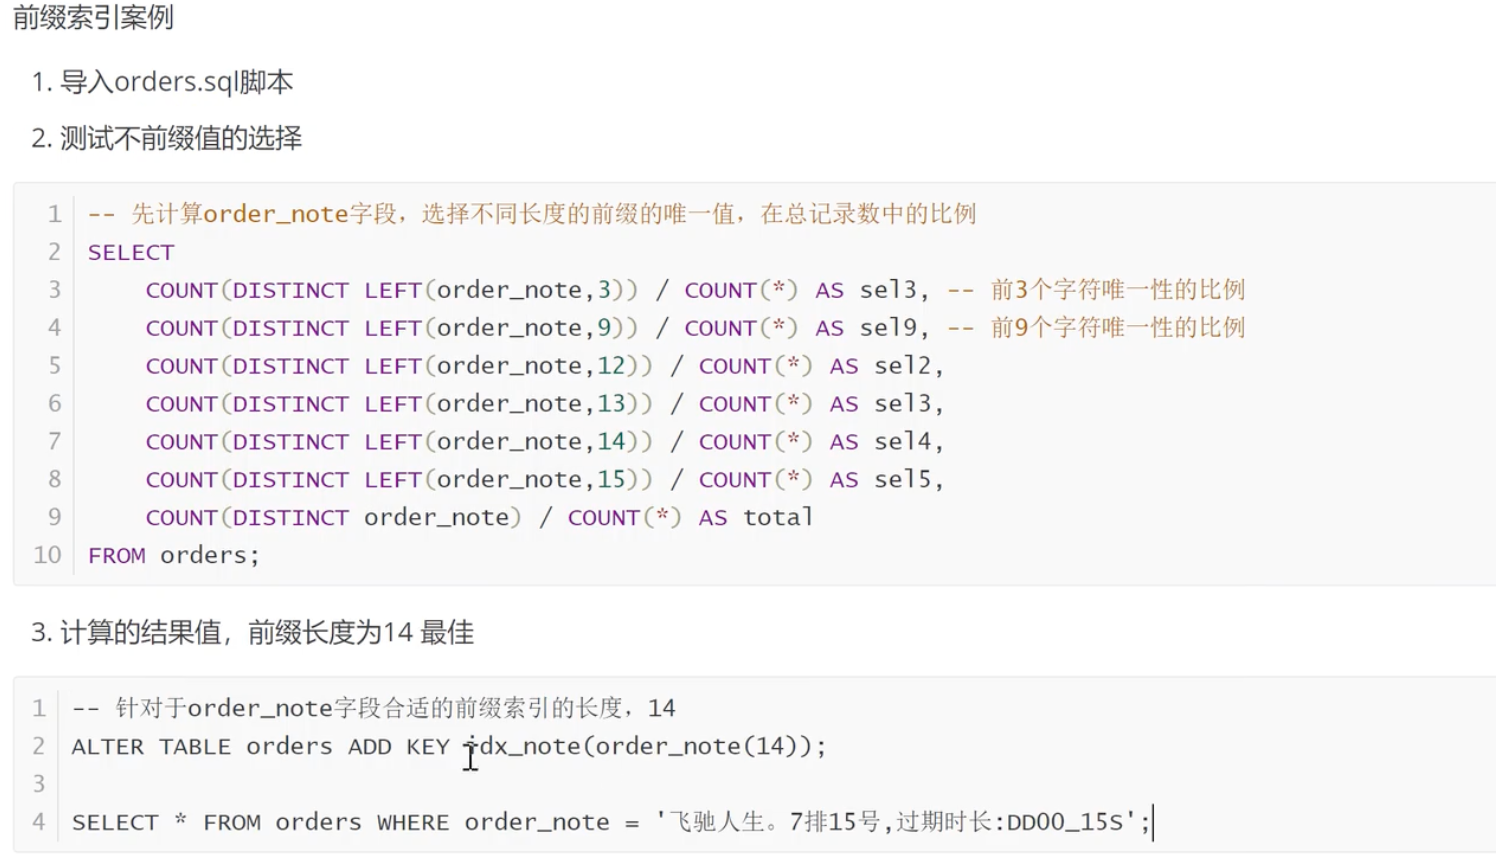
不同前缀长度的索引选择性:
| sel3 | sel9 | sel12 | sel13 | sel14 | sel15 | total |
|---|---|---|---|---|---|---|
| 0.0008 | 0.1717 | 0.7573 | 0.8673 | 0.9197 | 0.9592 | 0.9676 |
多列索引的创建原则
- 选择性最高的列放在最前面,因为选择性高的列通常可以更好的筛选数据,减少检索的数据量。
- 根据运行频率最高的查询,来调整索引的顺序。
- 覆盖查询需要的列,创建联合索引的时候,要注意这个联合索引是否是一个覆盖索引。可以避免在索引中和表中来回的跳转(回表)。
- 避免冗余索引:如果已经有了一个联合索引,再创建一个包含该索引一部分的索引是没有必要的。冗余索引会增加索引的维护成本。
- 权衡索引的长度:太长索引会占用更多的存储空间,同时也会降低索引检索效率。
- 避免使用过多列:只去选择那些在查询中被经常使用到的列。
- 只在查询条件中被经常使用,或者排序分组中经常使用的字段,去创建索引。
三星索引
针对查询而言,一个三星索引,可能是其最好的索引。
三星索引需要满足的条件
- 一星:索引将相关的记录放到了一起。
- 二星(排序星):索引中的数据顺序和查找中的排序顺序一致。
- 三星(宽索引星):索引中包含了所要查询的全部列的数据。
具体含义
- 一星:如果一个查询相关的索引行是相邻的,或者相距比较近,那么需要扫描的索引片的宽度就会缩短。一星要求让索引片尽量变窄,也就是索引的扫描范围越小越好。
- 二星(排序星):当查询需要排序时,使用的索引本身是有序的,就可以不用再去额外排序了。
- 三星(宽索引星):如果索引中包含了所要查询的全部列的数据,就是一个覆盖索引,查询不需要回表,减少了 I/O 的次数。
案例一:完全满足三星要求
1 |
|
—- 评估该索引满足几颗星
- 第一颗星:✅ 满足。
city、username作为索引前列,能有效减少索引片大小,减少需要扫描的行数。 - 第二颗星:✅ 满足。
ORDER BY city,而city字段在组合索引的最左侧,本身已经排好序。 - 第三颗星:✅ 满足。
SELECT查询的username和city字段都在联合索引中,无需回表。
案例二:评估现有索引(满足二颗星)
1 | --- 建表语句 |
评估结果
- 第一颗星:✅ 满足
- 第二颗星:❌ 不满足。因为查询语句中使用
age进行排序,而user_name采用了范围匹配,导致age无法保证有序。 - 第三颗星:✅ 满足
结论:修改后满足 1、3 星。
为满足第二颗星重新设计索引, 优化后的索引
1 | CREATE INDEX idx_sau ON customer2(sex, age, user_name); |
重新评估
- 第一颗星:❌ 不满足。
sex字段的选择性低,字段值重复率高,无法有效缩小索引片。 - 第二颗星:✅ 满足。在
sex等值条件下,age是有序的。 - 第三颗星:✅ 满足。
结论:修改后满足 2、3 星。
总结
同时满足三星的情况是比较少的。所以在设计索引的时候,尽可能满足两颗星就已经是不错的选择了。
使用策略
最佳左前缀法则
使用索引时,where后面的条件需要从索引的最左前列开始,并且不能够跳过索引中的列使用。创建的是联合索引,在使用时要遵守该法则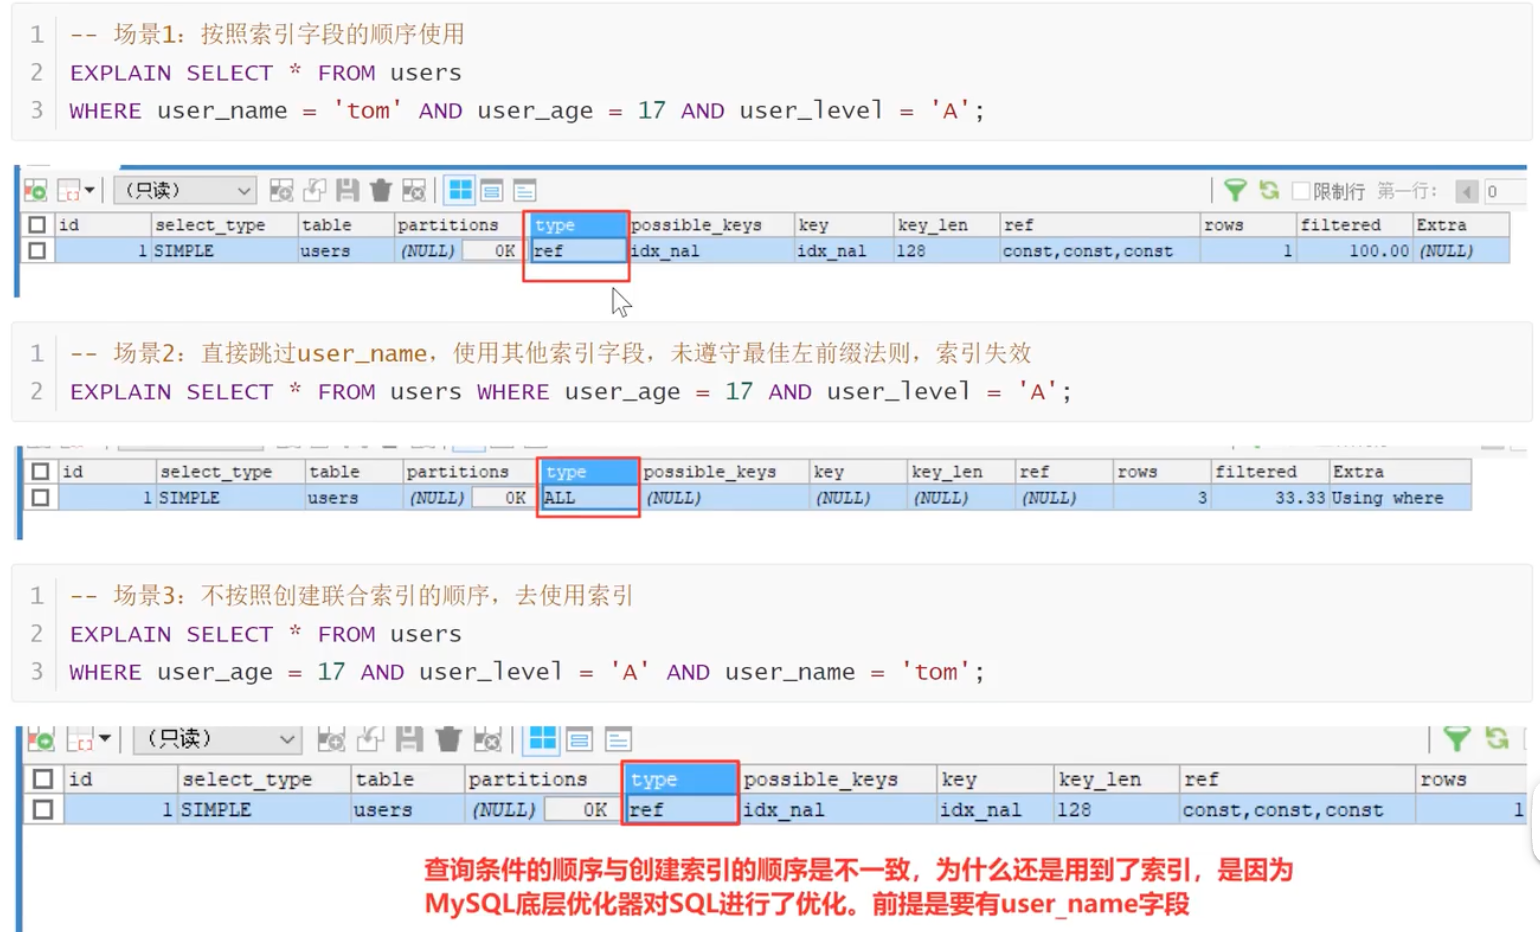
原理
MYSQL在创建联合索引时的规则是:首先会对联合索引最左边的字段进行排序(例子中user_name),在第一个字段的基础之上,再对第二个字段进行排序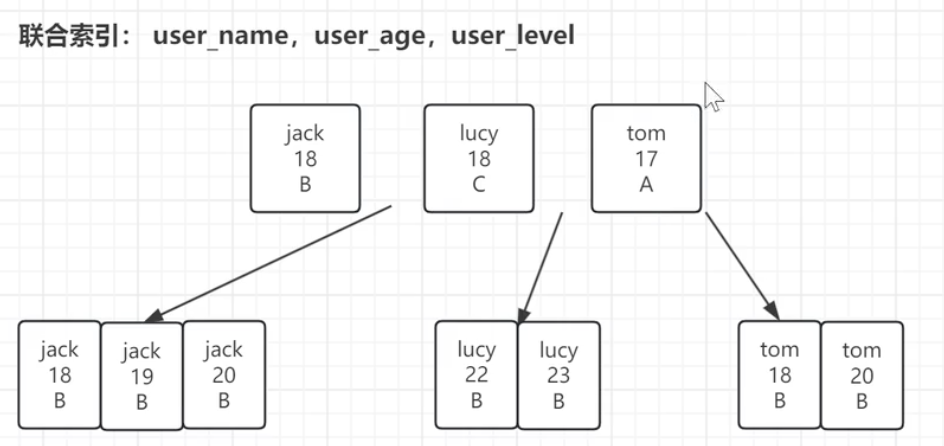
最佳左前缀原则其实是和B+树的结构有关系,最左字段肯定是有序的,第二个字段则是无序的
联合索引的排序方式是:先按照第一个字段进行排序,如果第一个字段相等再根据第二个字段排序
所以如果直接使用第二个字段 user_age 通常是使用不到索引的
不要在索引列上做任何操作
不要在索引列上做任何操作,包括了比如计算、使用函数、自动的或者手动进行数据类型转换,都会导致索引的失效,从而使查询转向全表扫描。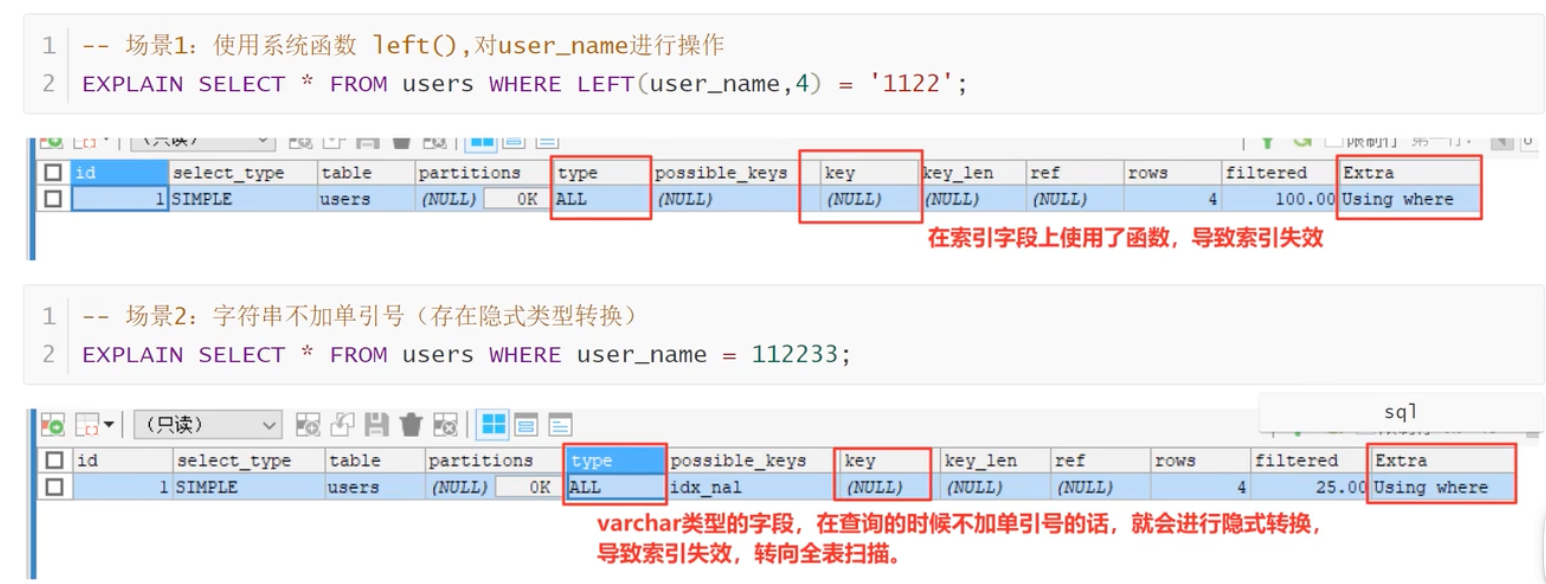
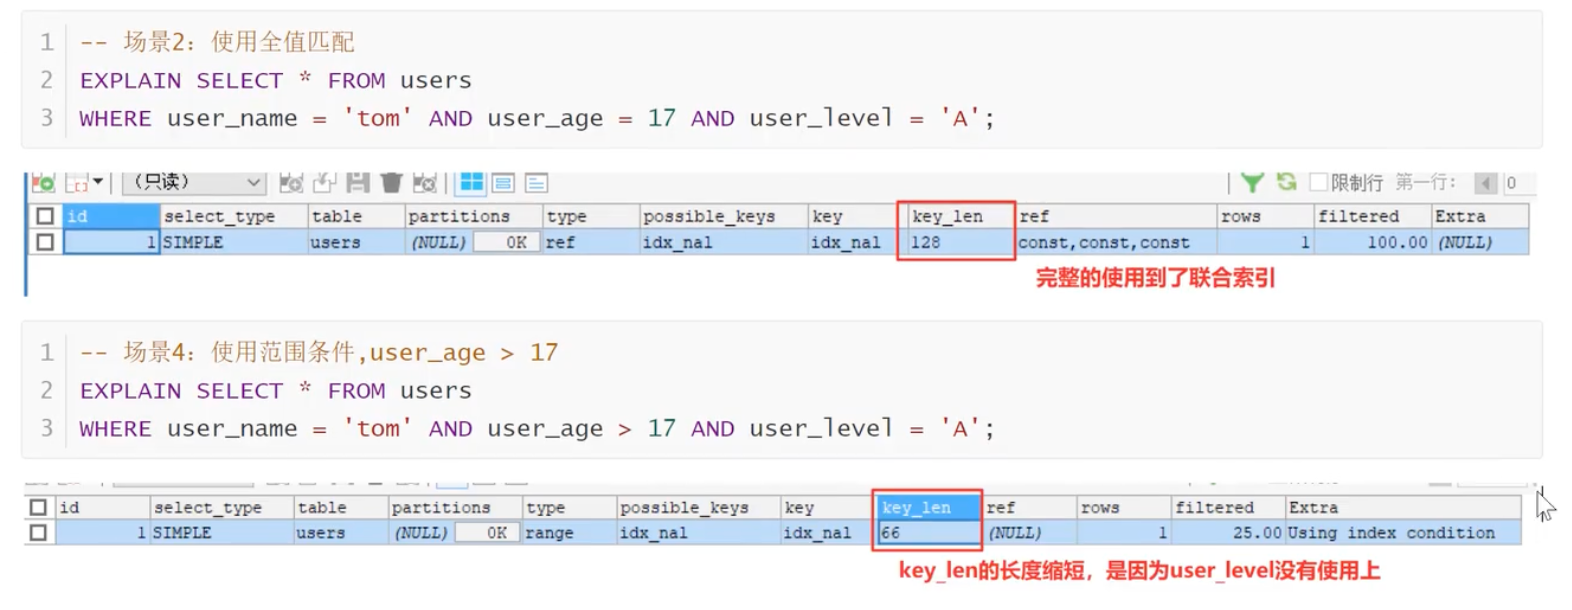
范围条件放最后
在编写查询语句的时候,where条件中如果有范围条件,并且范围条件之后还有其他过滤条件的话,那么范围条件之后的列就都将会索引失效
like 查询注意事项
like查询以%开头的话,就会使索引失效,%出现在左边索引失效,%出现在右边索引正常使用。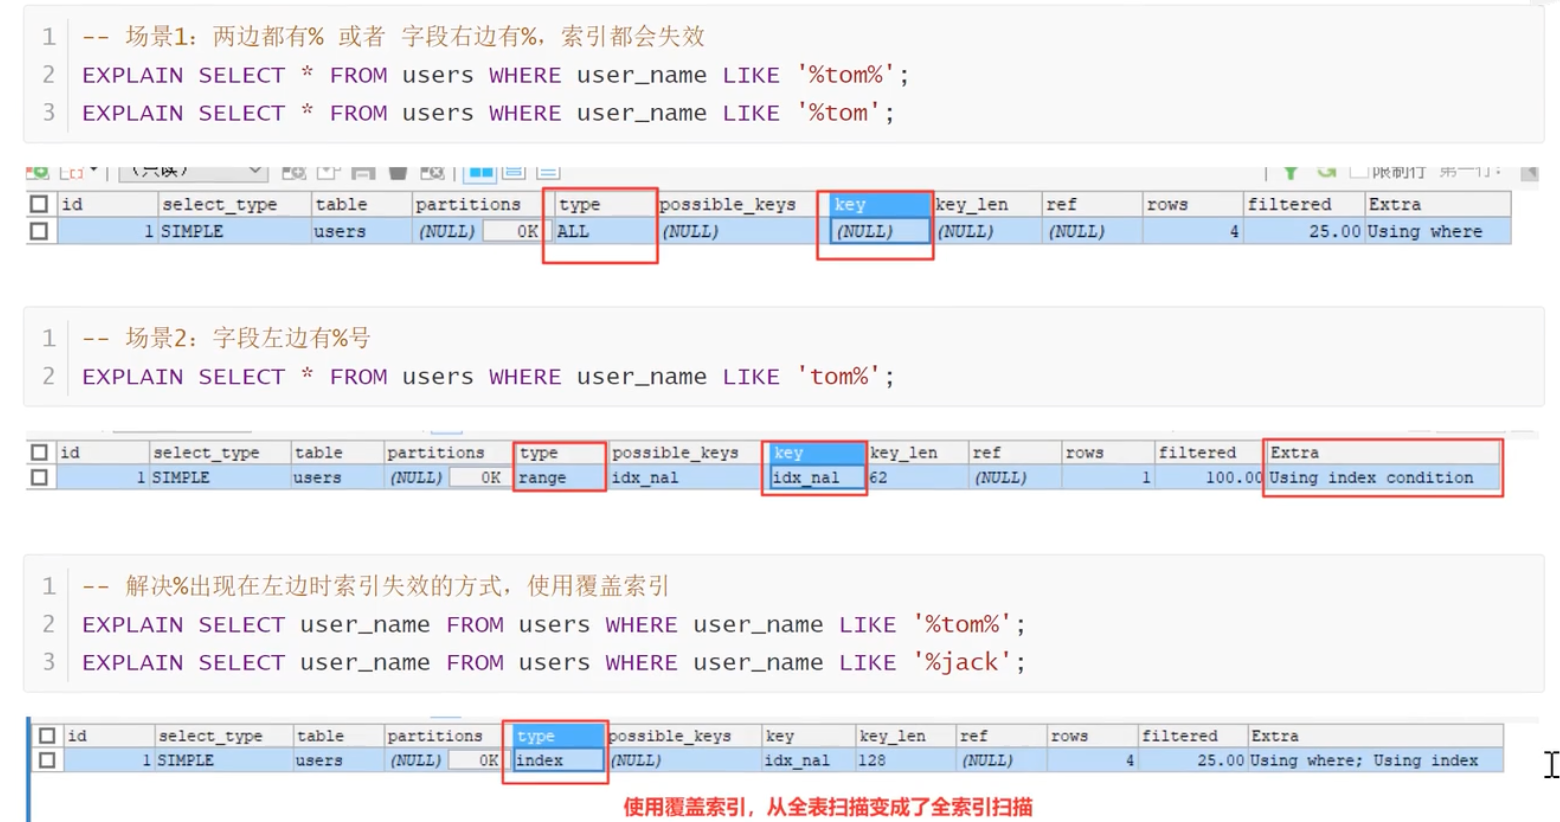
like % 在关键字左边导致索引失效原因
- %在右边:有B+树的索引顺序,按照首字母的大小进行排序,%如果是在右,匹配的是首字母。所以可以在B+树上进行有序查找,查找首字母符合要去的数据。
- %在左边:匹配的是字符串尾部的数据,尾部的字母是没有顺序的,所以无法按照索引顺序查询,索引失效。
- 两个%:查询任意位置的字母满足条件就可以。与%在左的问题一样只有首字母有序,其他位置的字母是无序的,所以索引失效。
null值注意事项
避免使用 is null、is not null、!= 、or
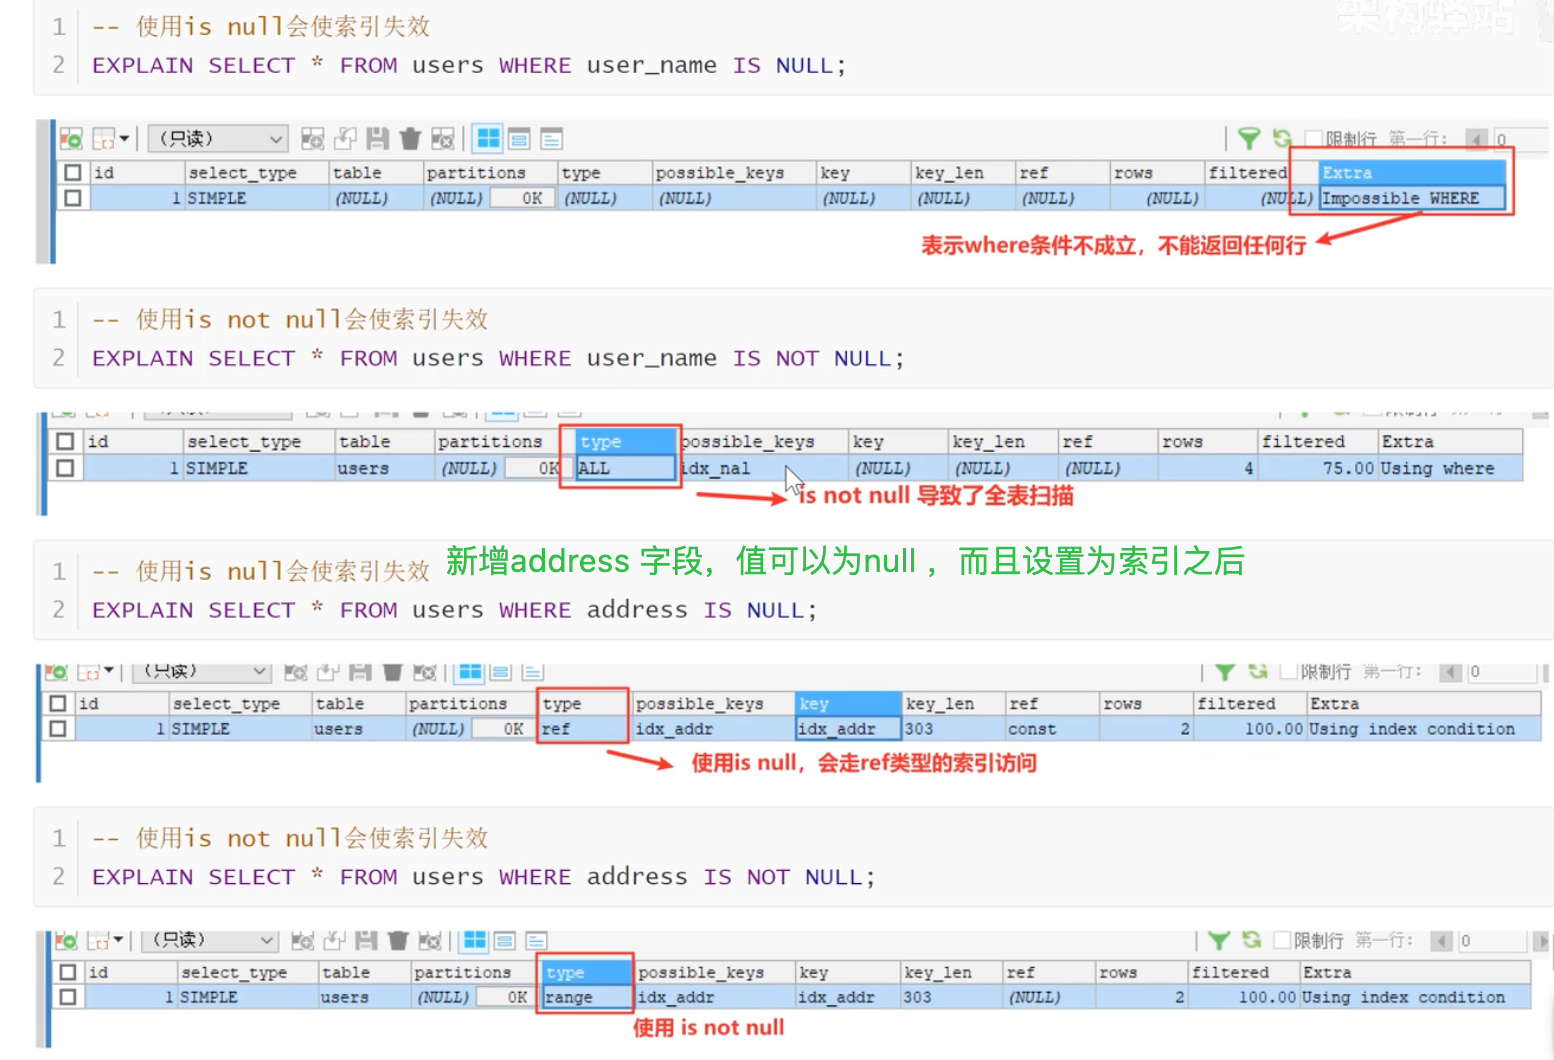
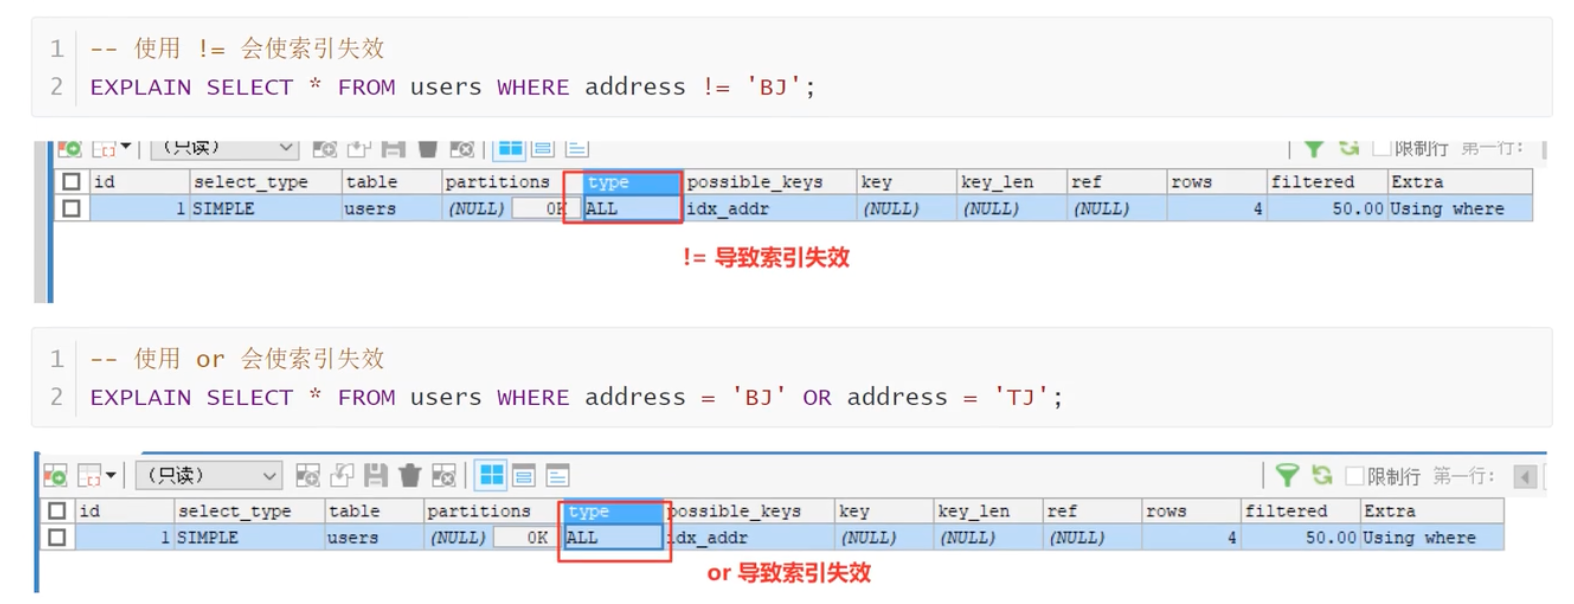
关于null值的说明可能有以下三种情况
1)定义1:null值代表着一个未确定的值,MySQL认为任何和nul值进行比较的表达式的结果都为null。所以认为每一个null值都
是独一无二。(nulls_unequal)
2)定义2:null值在业务上就是代表没有,所有的null 就被算作是一份。(null_equal)
3)定义3:null值完全没有意义,在统计的时候就不要算进来了 (nulls_ignored)
假设:一个表中的某个列c1列,记录分别为(2,1000,null,null),第一种情况表中根据c1统计的记录数为4.
第二种表中的c1的记录数为3,第三种表中c1的记录数为2
在MySQL5.7.2版本之后,MySQL将这个值写死为nulls_equal。总的来说对于列的声明,尽可能的不要允许为null!