将无序的数组,把首项当做根结点开始,按照比双亲结点小的做左子树,比双亲结点大的做右子树的规则
建立一颗二叉树,对二叉树进行中序遍历,即得到无序数组从小到大的排序
二叉排序树特点
—- 若它的左子树不为空,则左子树上所有结点的值均小于它的根结构的值
—- 若它的右子树不为空,则右子树上所有结点的值均大于它的根结构的值
—- 它的左右子树也分别为二叉排序树(递归)
代码链接
线性索引查找
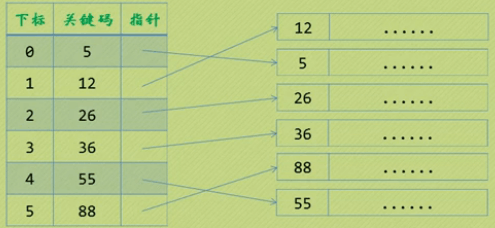
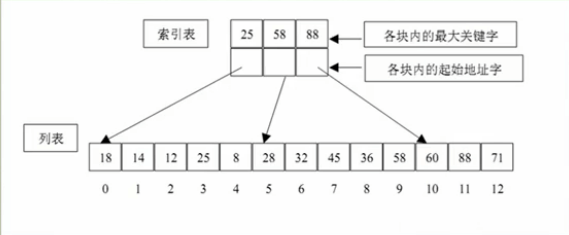
查找
静态查找: 数据集合稳定,不需要添加,删除元素的查找操作
– 组织数据宜用线性表结构
– 如果要对关键字排序,折半查找算法或斐波那契查找算法
动态查找:数据集合在查找过程中需要同时添加或删除元素的查找操作
– 二叉排序树,散列表结构
顺序查找
顺序查找/线性查找:从第一个(或者最后一个)记录开始,逐个进行记录的关键字和给定值进行比较,若某个记录的关键字和给定值相等,则查找成功。
—如果查找了所有的记录仍然找不到与给定值相等的关键字,则查找不成功1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19//方式一
function search(array,key){
var i;
for(var i = 0;i<= array.length;i++){
if(a[i] == key){
return i;
}
}
return 0;
}
//方式二
function search(array,key){
var i= array.length;
a[0] = key;
while(a[i] != key){
i--
}
return i;
}
插值查找(按比例查找)
查找方法类似于折半查找,只不过mid的值不再取low和high的中间值,
而是根据查找值在low和hight中间的大概位置确定mid
var mid = low +(high-low)*(num-list[low])/(list[high]-list[low]);
因此插值查找适用于有一定顺序规律的数组
代码链接
斐波那契查找(黄金查找)
同样适用于有一定顺序规律的数组
在折半查找的基础上根据斐波那契数列进行分割。
在斐波那契数列找一个等于略大于查找表中元素个数的数F[k],
将原查找表扩展为长度为F[k]-1(如果要补充元素,则补充重复最后一个元素,直到满足F[k]-1个元素)
进行斐波那契分割,即F[k]-1个元素分割为前半部分F[k-1]-1个元素,后半部分F[n-2]-1个元素,剩一个做mid
找出要查找的元素在那一部分并递归,直到找到。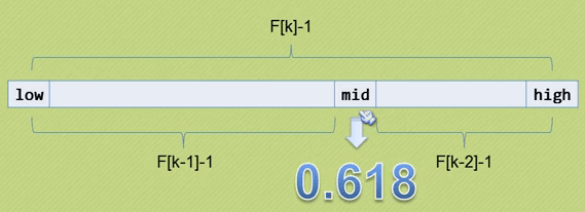
代码链接
关键路径
关键路径
AOE网:在一个表示工程的带权有向图中,用顶点表示事件,用有向边表示活动,用边上的权值表示活动的持续时间,
这种有向图的边表示活动的网,我们称之为AOE网(Activity On Edge Network)
始点/源点:AOE网中没有入边的顶点
终点/汇点:AOE网中没有出边的顶点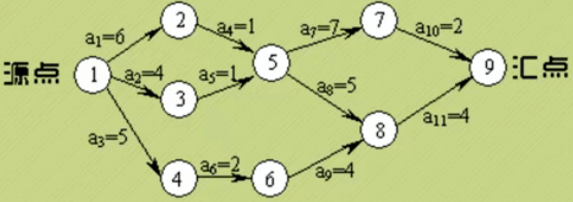
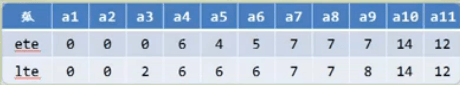
etv:时间最早发生时间,顶点的最早发生时间
ltv:事件最晚发生时间,每个顶点对应事件最晚需要开始的时间,如果超出此时间将会延误着整个工期
ete:活动最早开工时间,弧的最早发生时间
lte:活动最晚发生时间,不推迟工期的最晚开工时间
关键路径的目的是在规划工程各项活动执行的顺序时,找出关键的活动,保证工程不延期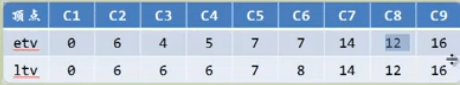
代码链接
拓扑排序
背景
DAG(Directed Acyclic)图/无环图:无环的有向图
‘活动’:所有的工程或者某种流程都可以分为的若干个小的工程或者阶段
AOV(Active On Vertex Network)网:在一个表示工程的有向图中,用顶点表示活动,用弧表示活动之间的优先关系
这样的有向图为顶点表示活动的网即AOV网
拓扑序列:设G=(V,E)是一个具有n个顶点的有向图,V中的顶点序列V1,V2,……Vn满足若从顶点Vi到Vj有一条路径,则在顶点序列中顶点Vi必在顶点Vj之前,我们称这样的顶点序列为一个拓扑序列,
拓扑排序:所谓的拓扑排序,其实就是对一个有向图构造拓扑序列的过程,保证活动是按一定顺序进行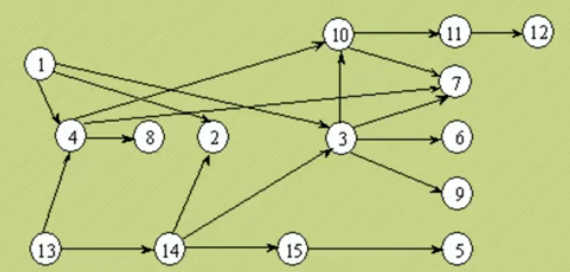
对AOV网进行拓扑排序的方法和步骤
——从AOV网中选择一个没有前驱的顶点(入度为0的顶点),并且输出它;
——从网中删去该顶点,并且删去从该顶点发出的全部有向边(将有向边终点入度减一)
——重复上述两步,直到剩余网中不再没有前驱的顶点为止。
代码链接
算法时间复杂度
对一个具有n个顶点,e条边的网来说,初始建立入度为0的顶点栈,要检查所有顶点一次,执行时间为O(n);
排序中,若AOV网无回路,则每个顶点入、出栈各一次,每个表结点被检查一次,因而执行时间是O(n+e);
因此整个算法时间复杂度是O(n+e)
最短路径
网图:两个顶点经过的边上权值之和最少的路径
非网图:两个顶点之间经过的边数最少的路径
源点:路径起始的第一个顶点
终点:最后一个顶点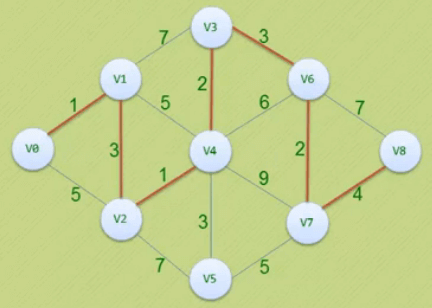
迪杰斯特拉(Dijkstra)算法
一个顶点到所有顶点的最短路径
主要思路:一步步求出它们之间顶点的最短路径,过程中都是基于已经求出的最短路径的基础上,求得更远顶点的最短路径
编程思路:类似于最小生成树普里姆算法
代码链接
佛洛依德(Floyd)算法
扩展版迪杰斯特拉(Dijkstra)算法,求图中所有结点到所有结点的最大路径,结果由二维数组展现
代码链接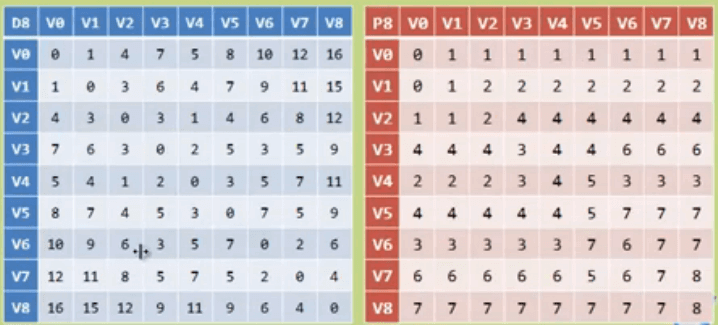
最小生成树
图的各结点连线间存在权值,寻找一种访问路径,使得访问各结点最终的路径的权值和最小,
最终访问路径和结点形成树的结构,即最小生成树
普里姆算法
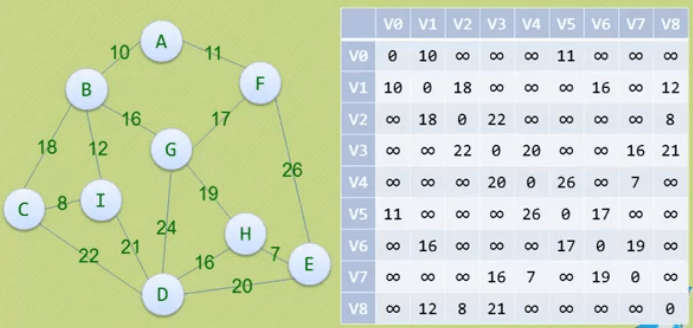
主要思路:研究对象为结点,以某顶点为起点,逐步找各个顶点上最小权值的边来构建最小生成树
编程思路:新建一数组,初始化为起点(最小生成树的根结点)在邻接矩阵所在行的权值
找到该组权值最小值,最小权值下标即要选择路径的终点,同时也是接下来要比较的邻接矩阵权值行的行号,
将该最小权值置0,然后将新建数组与矩阵权值行比较,
相同位置,矩阵行若小于新建数组值,就将新建数组值替换为矩阵行的值,
再次寻找新建数组中的最小权值,重复以上步骤
代码链接
克鲁斯卡尔算法
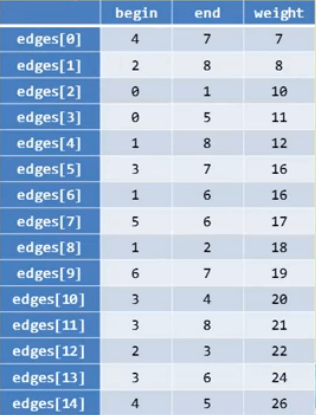
主要思路:研究对象为边,将边集数组从小到大排序,依次取边集数组的元素,判断边与边是否形成环路,不会形成则选择该边构建最小树
代码链接
关于commonjs、MVC、模板引擎
commonjs理解
是一种编写API的标准,根据该标准写的API可以在任何支持JavaScript的环境中使用,尤其是可以满足服务端的应用
四个个关键词
modules:模块,外部用 JavaScript 封装,具有对外接口并有一定功能作用的一个文件
packages:包,多个module的集合,相当于提供了一些固定接口的函数库,提供更高层的的抽象
exports:模块对外的接口对象,在模块文件中编写的功能函数作为它的属性函数,不同写法,使用规则不一样
require:当我们要使用某个模块时,用来获取/加载模块接口的对象,获取模块的 exports 对象。
定义模块与使用
方式一:
定义1
2
3
4
5
6
7
8
9function Change(a) {
a = 100;
console.log(a);
};
module.exports = Change;
//定义子函数
Change.childchange = function childchange(val){
console.log(val+20);
}
使用1
2
3
4
5var change = require('../models/testchange.js');
var a=10;
var aa=change(a);//100
console.log(a,aa);//10,100
change.childchange(a);//30
方式二:
定义
同时定义多个同级函数1
2
3
4
5
6
7
8exports.Change = function(a){
a = 100;
console.log(a);
return a;
}
exports.add = function(a,b){
return a+b;
}
使用1
2
3
4
5
6var change = require('../models/testchange.js');
var a=10;
var aa=change.Change(a);//100
console.log(a,aa);//10 100
var b=change.add(a,20);
console.log(b);//30
MVC
MODEL-VIEW-CONTROLL,模型-视图-控制器,是一种软件的设计模式
模型:对象及其数据结构的实现,通常包含数据库的操作
视图:表示用户界面,在网站中通常就是HTML的组织结构
控制器:用于处理用户请求和数据流,复杂模型,将输出传递给视图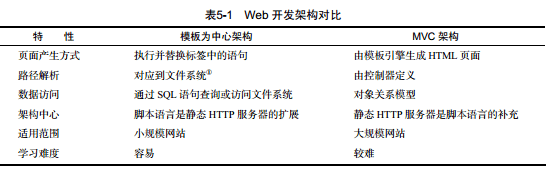
模板引擎
是一个生成HTML的工具
其功能是将页面模板和要显示的数据结合起来生成HTML页面
既可以运行在服务端又可以运行在客户端,
大多数时候它都在服务器端直接被解析为HTML,解析完后再传输给客户端
有时候也可以运行在客户端,即浏览器中
MVC架构中,模板引擎包含在服务器端,流程如下:
控制器得到用户请求后,从模型(原来页面)获取数据,调用模板引擎
模板引擎以数据(经过后台处理,要传递给客户端的)和页面模板为输入,生成HTML页面
返回给控制器,由控制器交会回给客户端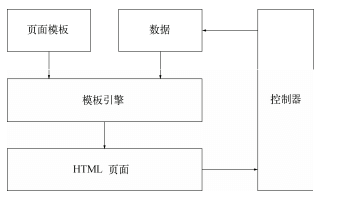
mongoDB使用
启动
cmd到mongoDB的bin文件夹,执行
mongod –dbpath data文件夹路径(例:D:\MongoDB\data)//运行
再打开一个cmd,同样切目录到bin文件夹下,执行
mongo //连接到数据库
命令
基础命令
use dbname //名为dbname的数据库若存在就将当前数据库切换到该数据库,若不存在,则新建该数据库并切换至该数据库
db //查看当前数据库
show dbs //查看所有数据库,新建的库,在插入数据后才会显示
db.dropDatabase() //删除当前数据库,但用db查看当前库,还是被删的这个库
db.tablename.drop() //删除数据库中名为tablename的集合
db.tablename.insert({“key”:”value”}) //创建名为objectname的表(对象),并插入数据,批量操作时可以直接在shell里面写for循环
show tables //查看该库中所有表(对象)
db.tablename.find() //在仓库中查找名为tablename的表,如果有就会将表中内容打印出来
db.tablename.find({“key”:”value”}) //在tablename表中查找具体数据,注意格式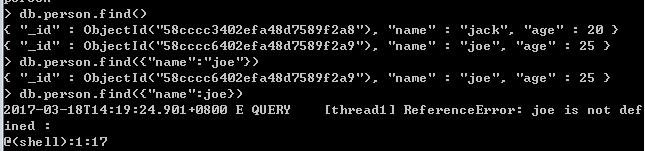
db.tablename.update({查找值},{替换值}) //将查找值所在的集合替换为替换值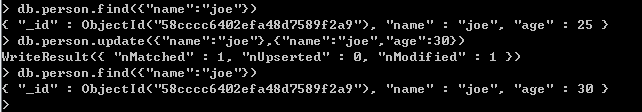
db.tablename.remove({查找值}) //删除查找值所在对象的全部数据,若为空,则将整表清空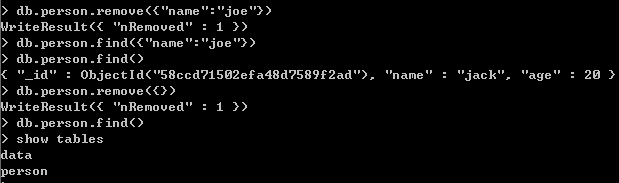
条件查找
1.比较查询
将查找条件放在value部分,用{}括起来
下图查询条件为age大于”$gt”22, 大于等于”$gte”22, 小于”$lt”22, 小于等于”$lte”22, 不等于”$ne”20,等于20的查询格式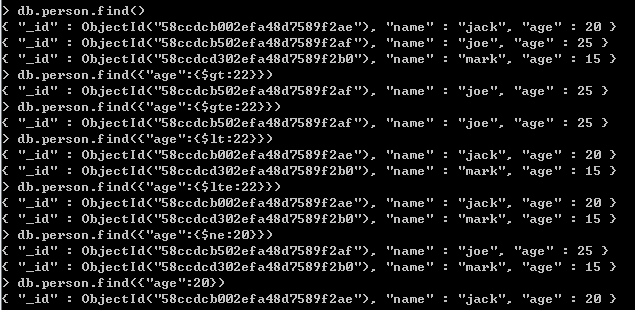
使用正则表达式匹配时同样将正则表达式放在value的位置,而且不用{}或者””包括,直接/开始/结束
2.逻辑查询
下图查询条件分别为且,或者$or,在氛围内$in,不在范围内$nin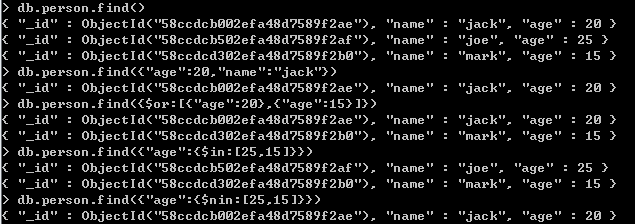
局部修改
$inc 属性不存在就创建并赋值,如果存在,就在原来的基础上增加要修改的值
$set 仅修改1
2
3
4
5
6
7
8
9
10
11
12
13> db.person.find()
{ "_id" : ObjectId("58ccdcb002efa48d7589f2ae"), "name" : "jack", "age" : 20 }
{ "_id" : ObjectId("58ccdcb502efa48d7589f2af"), "name" : "joe", "age" : 25 }
{ "_id" : ObjectId("58ccdcd302efa48d7589f2b0"), "name" : "mark", "age" : 15 }
> db.person.update({"name":"jack"},{$inc:{"age":10}})
WriteResult({ "nMatched" : 1, "nUpserted" : 0, "nModified" : 1 })
> db.person.update({"name":"mark"},{$set:{"age":10}})
WriteResult({ "nMatched" : 1, "nUpserted" : 0, "nModified" : 1 })
> db.person.find()
{ "_id" : ObjectId("58ccdcb002efa48d7589f2ae"), "name" : "jack", "age" : 30 }
{ "_id" : ObjectId("58ccdcb502efa48d7589f2af"), "name" : "joe", "age" : 25 }
{ "_id" : ObjectId("58ccdcd302efa48d7589f2b0"), "name" : "mark", "age" : 10 }
>
特殊情况:update的第一个参数不存在,即查找值不在person中,可以如下设置,将其新增
db.person.update({“name”:”jackson”},{$inc:{“age”:10}},true)
注意:update默认仅更新匹配得到的第一个集合,如果想更新全部匹配得到的结果,
可以将第四个参数设为true
数据处理
1.计数
db.person.count() //获取person中数据条数
db.person.count({“age”:20}) // 获取person中age等于20的数据条数
2.统计
db.person.distinct(“age”) //获取person中所有age的值,重复的值只取一次
3.分组
db.person.group({
“key”:{“age”:true},//按age分组,age相同的分一组
“initial”:{“person”:[]}, //分组内容
“$reduce”:function(cur,prev){ //符合分组条件,将该条数据放入该组集合中,cur指当前处理的该条数据,prev指上次函数的累计对象,第一次为initial的值。
prev.person.push(cur.name);
},
“finalize”:function(out){//将一条数据划分到一组后执行的处理
out.count = out.person.length;
},
“condition”:{“age”:{$lt:25}}//分组条件,对什么样的数据进行分组
})
4.映射
通过map对集合进行分组,通过reduce对分组结果进行处理,理解为复杂的重组处理,最后会生成一个全新的集合1
2
3
4
5
6
7
8
9
10
11
12var map = function(){
emit(this.name,{count:1}); //集合按照name分组,分组内容均为{count:1}
}
var reduce = function(key,value){ //对分组结果进行处理
var result = {count:0};
for(var i = 0;i<value.length;i++){
result.count +=value[i].count;
}
return result;
}
db.person.mapReduce(map,reduce,{"out":"collection"})
db.collection.find()
5.循环处理
可以将集合赋值给一个变量然后进行循环处理,
var list = db.person.find();
list.forEach(function(x){
print(x.name):
})
6.可以多操作查询
对person集合数据按name排序然后分页
var single=db.person.find().sort({“name”,1}).skip(2).limit(2);
7.索引查询
建立索引:
db.person.ensureIndex({“name”:1}) //建立按照name进行排序的索引,1为升序,-1为降序
db.person.ensureIndex({“name”:1},{“unique”:true}) //建立唯一索引,集合中不能出现重复键值对
db.person.ensureIndex({“name”:1,”birthday”:1}) //组合索引
查询优化器做出的选择往往是最优的,因为我们做查询时,查询优化器会使用我们建立的这些索引来创建查询方案,
如果某一个先执行完则其他查询方案被close掉,这种方案会被mongodb保存起来,当然如果非要用自己指定的查询方案,这也是可以的,在mongodb中给我们提供了hint方法让我们可以暴力执行。
db.person.find({“name”:”jack”,”birthday”:”1998-3-2”}).hint({“name”:1,”birthday”:1})
删除索引:
db.person.dropIndexes(“name_1”)
主从复制
将数据库数据复制到多台服务器上,防止因为一台服务器死机而导致数据无法使用的问题出现
将安装文件复制到其他磁盘上,模拟不同的服务器
启动H盘上的mongodb,把该数据库指定为主数据库
H:\mongoDB\bin>mongod –dbpath H:\mongoDB\data –master
启动D盘上的mongodb,把该数据库指定为从属数据库
D:\mongoDB\bin>mongod –dbpath D:\mongoDB\data –port 8888 –slave –source=127.0.0.1:27017
更换端口为8888,source表示主数据库地址
2017-03-20T10:12:17.424+0800 I REPL [replslave] syncing from host:127.0.0.1:
27017
然后分别打开主shell(mongo 127.0.0.1:27017)和从shell(mongo 127.0.0.1:8888)查看所有集合
show dbs
因为从服务器上的数据库是不允许进行读写操作,所以从shell中会报错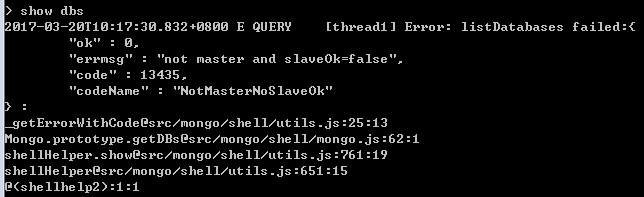
解决,先执行:rs.slaveOk()
现在主shell中更改数据,在从shell中查看,看是否进行了同步
但有可能因为服务连接状态问题导致数据内容不同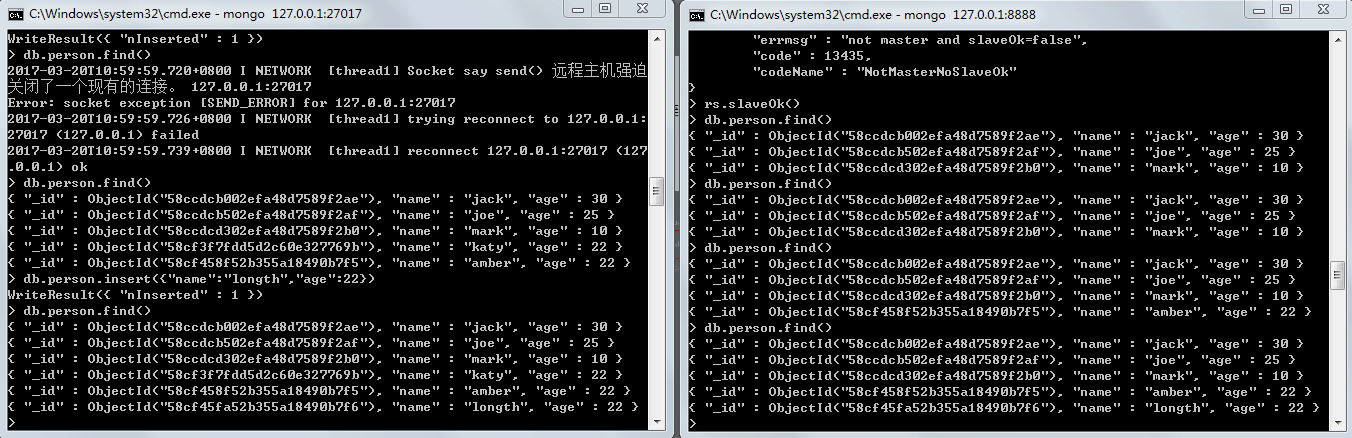
集群
不设定特定主数据库,如果哪个数据库死机了,集群就会推选一个从属数据库作为主数据库顶上,实现自动修复的效果
1.建立集群,命名集群名为shopex,replSet让服务器知道shopex下有端口为3333的另一个数据库服务器
新打开cmd
H:\mongoDB\bin>mongod –dbpath H:\mongoDB\data –port 2222 –replSet shopex/127.0.0.1:3333
2.打开端口为3333的另一个数据库服务器
新打开cmd
D:\mongoDB\bin>mongod –dbpath D:\mongoDB\data –port 3333 –replSet shopex/127.0.0.1:2222
3.在admin集合中初始化“副本集”
新打开cmd,开启shell
H:\mongoDB\bin>mongo 127.0.0.1:2222/admin1
2
3
4
5
6
7
8
9
10
11
12
13> db.runCommand({"replSetInitiate":{
... "_id":"shopex",
... "members":[
... {
... "_id":1,
... "host":"127.0.0.1:2222"
... },
... {
... "_id":2,
... "host":"127.0.0.1:3333"
... }
... ]}})
{ "ok" : 1 }
4.设置仲裁服务器
新打开cmd,开启服务
D:\mongoDB\bin>mongod –dbpath F:\mongoDB\data –port 4444 –replSet shopex/127.0.0.1:2222
开启shell,设置及产看结果
H:\mongoDB\bin>mongo 127.0.0.1:2222/admin
shopex:PRIMARY> rs.addArb(“127.0.0.1:4444”)
{ “ok” : 1 }1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79shopex:PRIMARY> rs.status()
{
"set" : "shopex",
"date" : ISODate("2017-03-20T05:55:12.742Z"),
"myState" : 1,
"term" : NumberLong(1),
"heartbeatIntervalMillis" : NumberLong(2000),
"optimes" : {
"lastCommittedOpTime" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
},
"appliedOpTime" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
},
"durableOpTime" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
}
},
"members" : [
{
"_id" : 1,
"name" : "127.0.0.1:2222",
"health" : 1,
"state" : 1,
"stateStr" : "PRIMARY",
"uptime" : 596,
"optime" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
},
"optimeDate" : ISODate("2017-03-20T05:55:07Z"),
"electionTime" : Timestamp(1489989026, 1),
"electionDate" : ISODate("2017-03-20T05:50:26Z"),
"configVersion" : 2,
"self" : true
},
{
"_id" : 2,
"name" : "127.0.0.1:3333",
"health" : 1,
"state" : 2,
"stateStr" : "SECONDARY",
"uptime" : 296,
"optime" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
},
"optimeDurable" : {
"ts" : Timestamp(1489989307, 1),
"t" : NumberLong(1)
},
"optimeDate" : ISODate("2017-03-20T05:55:07Z"),
"optimeDurableDate" : ISODate("2017-03-20T05:55:07Z"),
"lastHeartbeat" : ISODate("2017-03-20T05:55:11.766Z"),
"lastHeartbeatRecv" : ISODate("2017-03-20T05:55:10.786Z"
),
"pingMs" : NumberLong(0),
"syncingTo" : "127.0.0.1:2222",
"configVersion" : 2
},
{
"_id" : 3,
"name" : "127.0.0.1:4444",
"health" : 1,
"state" : 7,
"stateStr" : "ARBITER",
"uptime" : 44,
"lastHeartbeat" : ISODate("2017-03-20T05:55:11.765Z"),
"lastHeartbeatRecv" : ISODate("2017-03-20T05:55:07.948Z"
),
"pingMs" : NumberLong(0),
"configVersion" : 2
}
],
"ok" : 1
}
现在如果关掉2222端口服务器,再打开,在执行rs.status(),可以看到2222的“stateStr”变成”SECONDARY”
“3333”的变成”PRIMARY”
相关链接
开发小结
对于路由的理解
1 | 官方定义: |
当浏览器向服务器发过来一个http请求时,会携带请求路径和请求方法,服务器根据发过来的路径和请求方法进行匹配,二者都匹配的话,就执行对应的回调函数
请求的目的在客户端看来可能多种多样,比如单纯的访问页面,重新获取页面数据,向后台传递数据,但是在服务端看来都是一样的处理方法,匹配路径和方法,进行回调函数,
即通过匹配执行相应的动作,比如
客户端想访问一个页面,回调函数就执行渲染页面的操作
客户端要传递数据给数据库,回调函数就获取传递的数据然后给到数据库
作用就像一个指南针,根据客户端不同的请求,执行不同的操作
但涉及到的具体操作(数据处理)可能会通过其他文件的处理函数来实现
官方文档
对于中间件的理解
1 | 官方定义 |
粗浅的理解为功能处理函数,比如路由匹配里的回调函数,根据功能和使用方式不同分成多种
1.应用级中间件, app.use() 和 app.METHOD()的回调函数
2.路由级中间件,var router = express.Router(), router.use() 或 router.VERB() 的回调函数
3.错误处理中间件,进行错误处理的的函数,参数与其他不同
4.内置中间件, express.static
5.第三方中间件,通过npm安装的模块,即我们使用的模块也算是中间件
官方文档