order by优化
MySQL中有两种排序方式:
- 索引排序:通过有序索引进行顺序扫描,直接返回有序的数据。
- 额外排序:对返回的数据进行文件排序
order by 优化的核心原则: 尽量减少额外排序,通过索引直接返回有序数据。
索引排序
在排序查询中,如果能利用索引,就能够避免额外的排序操作。extra = Using index
1 | select * from user where age = 18 order by name; |
查询过程,找到 age = 18的记录,排序条件是name,name字段是联合索引的最左前列,是已经有序的了,所以不需要额外进行排序。
额外排序
所有不是通过索引直接返回排序结果的操作都是额外排序(FileSort排序)。Extra=Using filesort。
按照执行位置划分
1) 内存中 sort buffer
MySQL中为每个线程各维护了一块内存区域,用来进行排序,叫做 sort_buffer。
1 | SHOW VARIABLES LIKE '%sort_buffer_size%'; |
| Variable_name | Value |
|---|---|
| innodb_sort_buffer_size | 1048576 |
| myisam_sort_buffer_size | 306184192 |
| sort_buffer_size | 262144 |
以sort_buffer_size该参数为准
注意:sort_buffer_size并不是越大越好,因为是connection级别的参数,各大设置+高并发场景,可能会造成系统资源的耗尽。
2) sort buffer + 临时文件
如果加载的记录字段的总长度小于 sort buffer,就使用sort buffer,否则就会采用 sort buffer + 临时文件 进行排序。
按照执行方式划分
执行方式:max_length_for_sort_data 参数,如果用于排序的单条记录字段的长度 <= 该参数的值,就使用 全字段排序,否则就使用 rowid排序。
1 | -- 如果单条记录字段的长度 < max... 选择全字段排序,否则 rowid排序。 |
全字段排序
将查询的所有的字段,全部加载进来 进行排序
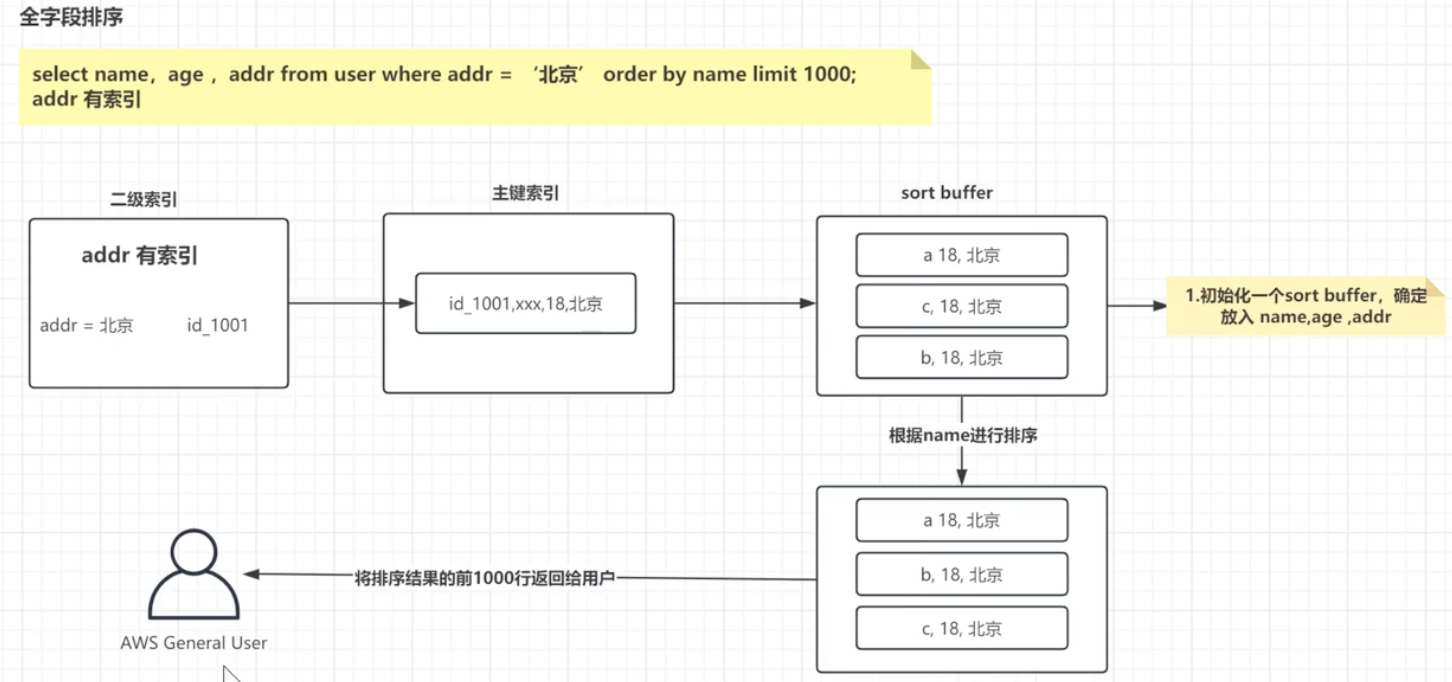
优点:查询快,执行过程简单,缺点是 需要的空间比较大。
rowid排序
rowid排序不会将全部字段放入sort buffer中,所以在sort buffer中排序之后,还要回表查询。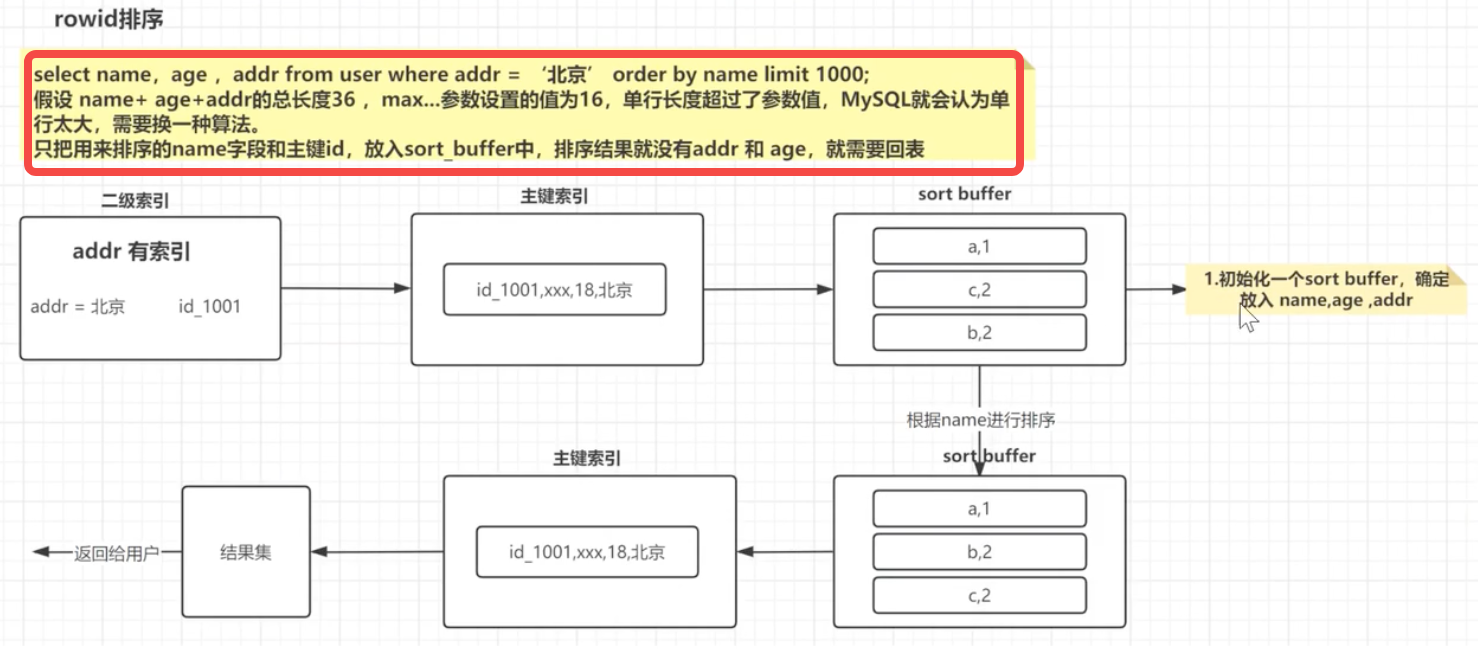
• 优点:所需要的空间小。
• 缺点:会产生更多的回表查询,查询效率相对低一些。
排序总结
• 如果MySQL内存足够大,会优先选择全字段排序。
• MySQL的一个设计思想:要多利用内存,尽量减少磁盘访问
排序优化
1 | -- 创建联合索引 |
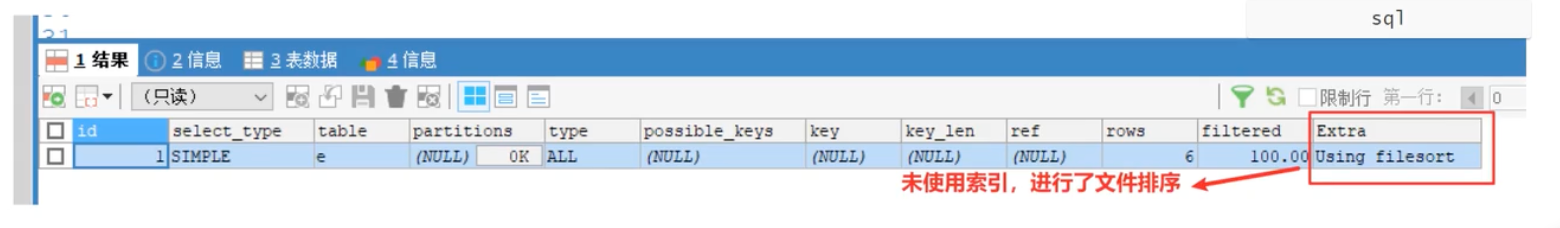
1 | -- 场景3:只查询用于排序的索引字段和主键值,可以利用索引进行排序 |
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | e | (NULL) | index | (NULL) | idx_name_age | 68 | (NULL) | 6 | 100.00 | Using index |
1 | -- 场景4:排序的索引字段,没有出现在查询的字段列表中,不会利用索引排序 |
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | e | (NULL) | ALL | (NULL) | (NULL) | (NULL) | (NULL) | 6 | 100.00 | Using filesort |
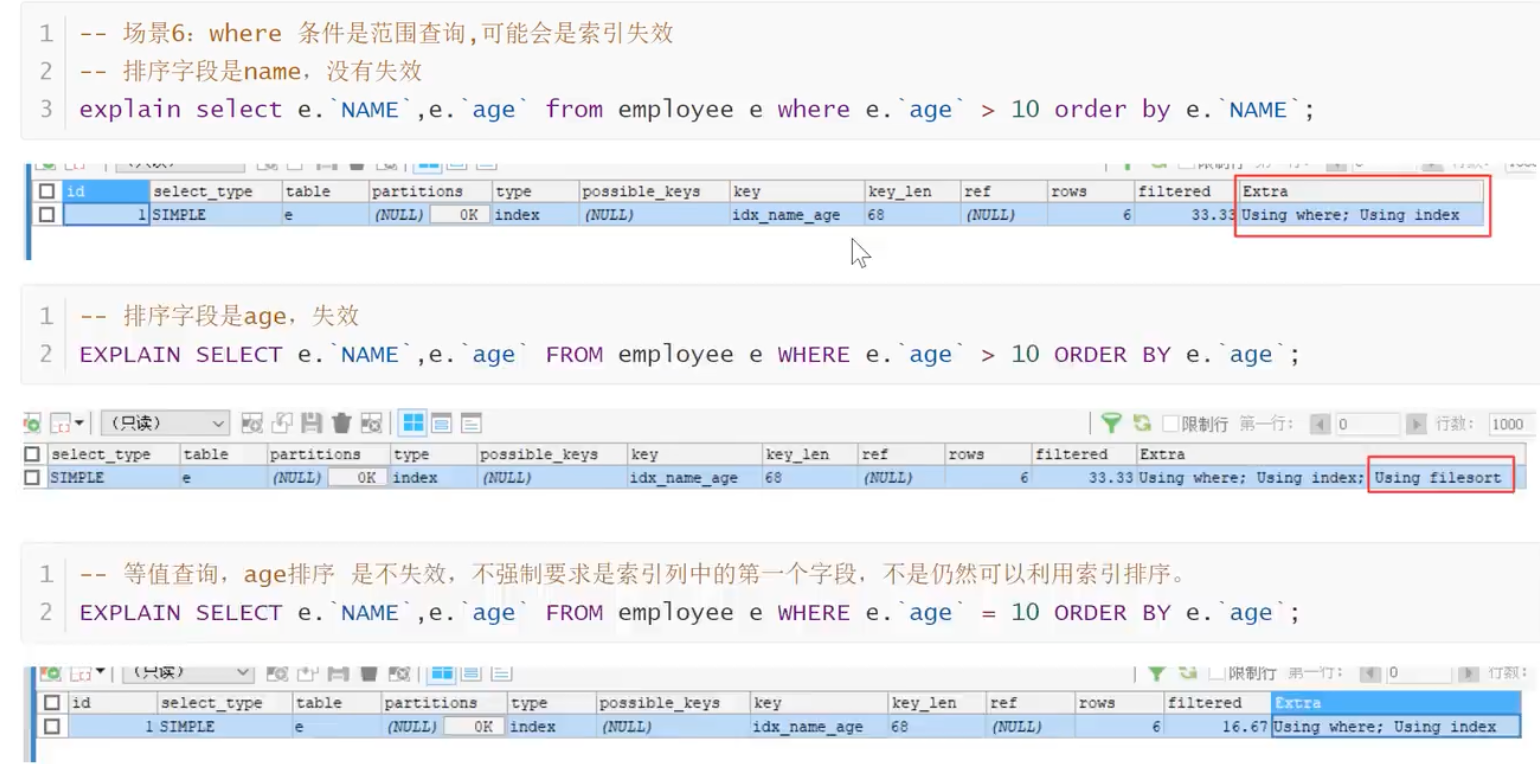
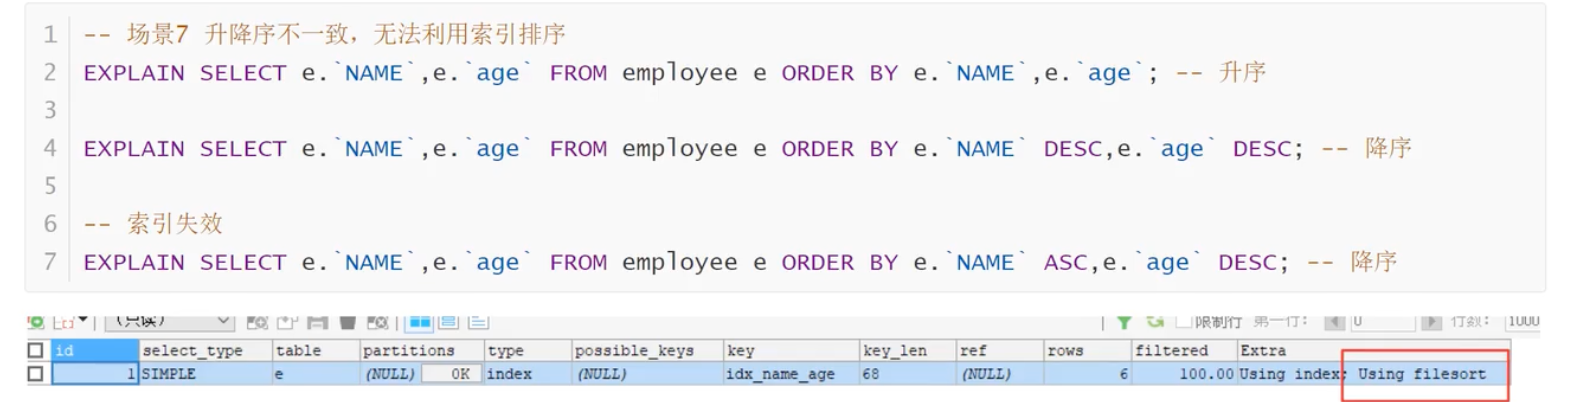
1 | -- 场景5: 排序字段的顺序和索引的顺序不一致,无法利用索引排序 |
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | e | (NULL) | index | (NULL) | idx_name_age | 68 | (NULL) | 6 | 100.00 | Using index; Using filesort |
group by优化
group by回顾
group by一般用于分组统计
1 | -- 需求:按照城市进行分组,统计每个城市的员工的数量。 |
问题1:group by一定要配合聚合函数吗?
答:分组就是要去做统计的,否则分组没有意义了,所以一般都要配合聚合函数去使用,比如:count、sum、avg…
问题2:group by后面跟的字段,一定要出现在select列表中吗?
答:是一定要出现。如果没有没法确定是哪一个分组的值了。在标准SQL规范中,这点是必须的。(MySQL中大部分版本没有强制规定,Oracle中强制规定的),编写SQL时尽量在select列表中列出分组字段,确保查询的可移植性和可读性。
问题3:where和having的区别?
group by + where
1 | EXPLAIN SELECT city,COUNT(*) num FROM emp WHERE age > 30 GROUP BY city; |
| table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|
| emp | . | range | idx_age | idx_a | 4 | (NULL) | 2 | 100.00 | Using index condition; Using temporary; Using filesort |
使用到了临时表,进行了文件排序
group by + having
1 | -- 需求:查询每个城市的员工数量,获取到员工数量不低于3的城市。 |
| select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 SIMPLE | emp | . | ALL | (NULL) | (NULL) | (NULL) | (NULL) | 10 | 100.00 | Using temporary; Using filesort |
where和having区别:
- having 子句用于分组后的筛选,where子句用于行条件的筛选。
- having 都是配合分组和聚合函数一起出现。
- where子句中不能使用聚合函数,但是having可以。
group by 执行原理
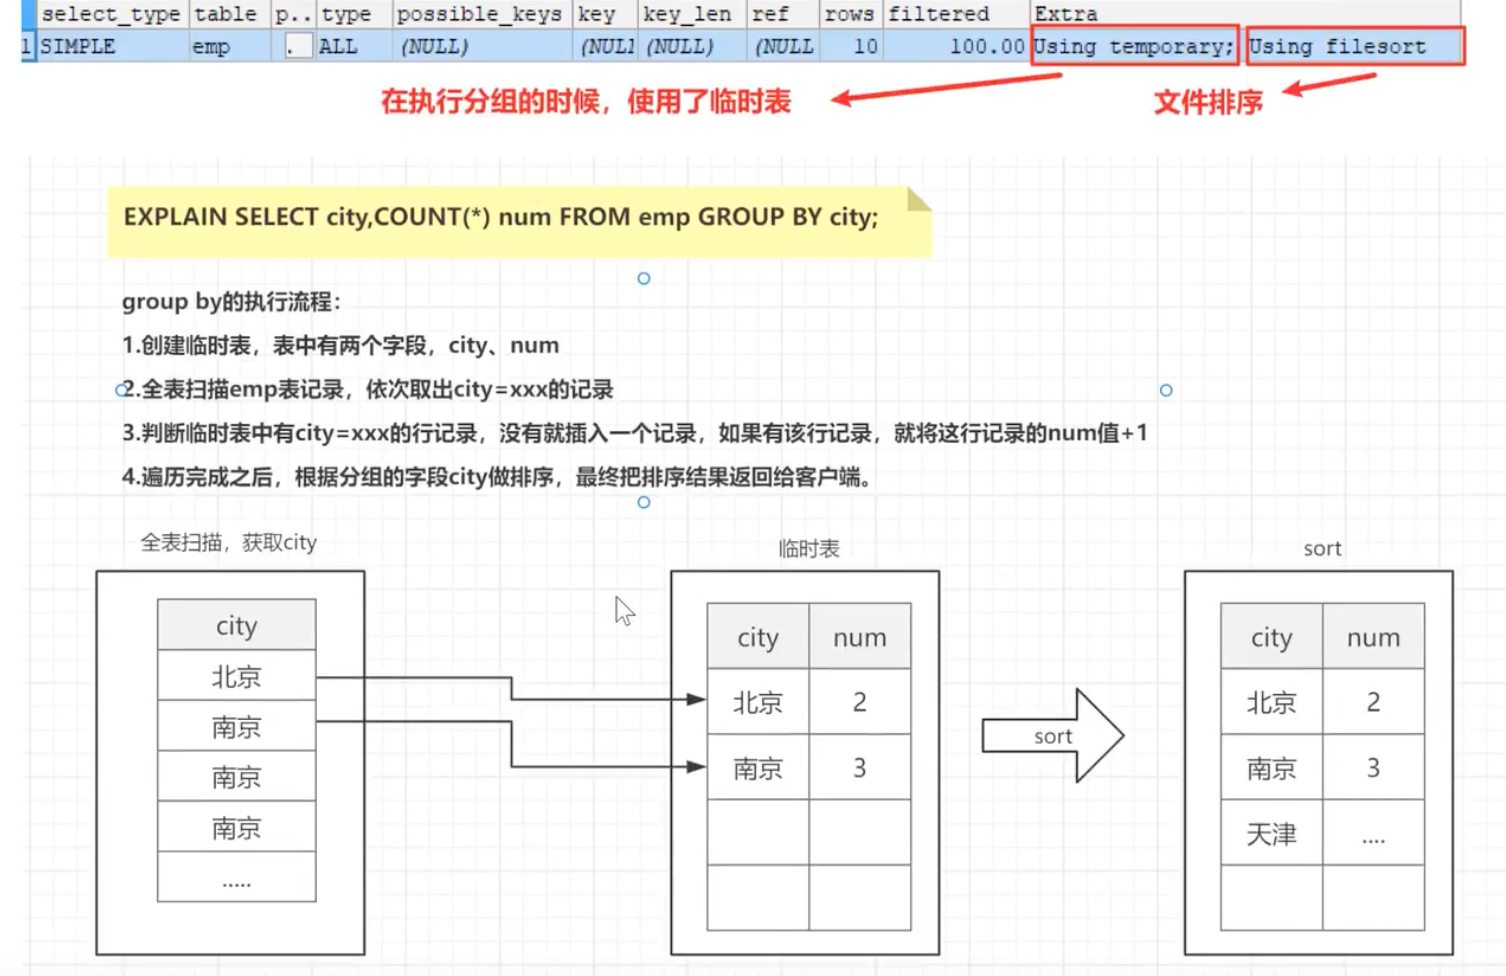
MySQL的分组中为什么包含排序?
- 聚合函数的使用:排序可以帮助最快找到最高或者最低的值。
- Top N查询:排序后,获取每个分组中前N个记录,更加方便。
- 结果的可读性:排序之后,可以更好的理解分组统计之后的结果。
- 用户需求:用户希望按某个列分组之后,进行排序。
group by优化
优化方案1:group by默认要进行排序,在合适的场景下,取消这个默认排序。
===> 使用 ORDER BY NULL
1 | -- 取消分组排序 |
| id | select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | emp | . | ALL | (NULL) | (NULL) | (NULL) | (NULL) | 10 | 100.00 | Using temporary |
没有filesort
优化方案2:为group by字段添加索引,让其一开始的时候就是有序的。
1 | EXPLAIN SELECT city,COUNT(*) num FROM emp WHERE age = 30 GROUP BY city; |
优化方案3:尽量使用内存表
如果group by需要统计的数据不多,可以尽量使用内存临时表,因为如果内存放不下,就会下沉到磁盘临时表中,导致性能下降。
1 | -- 调整临时表大小 |
优化方案4:使用SQL_BIG_RESULT优化
如果数据量特别大,数据就算放到临时表中(临时表已经够大了),但是还是会因为数据的插入达到上限,再转成磁盘临时表,还是会影响到数据库的性能。
如果预数据量比较大,我们使用SQL_BIG_RESULT直接提示MySQL 直接磁盘临时表。
- 禁用内存优化
- 适用于大结果集
一旦添加了SQL_BIG_RESULT,MySQL就不会再用B+树结构存储临时表数据,存储效率低,会选择使用数组,直接用数组存储。
1 | -- SQL_BIG_SORT |
| id | select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | emp | . | index | idx_city,idx_& | idx_c | 194 | (NULL) | 10 | 100.00 | Using index; Using filesort |
没有使用临时表