My Little World

Join 优化

JOIN回顾:MySQL中用来进行连表操作,用来匹配两个表的数据,筛选并合并出符合我们要求的结果集。

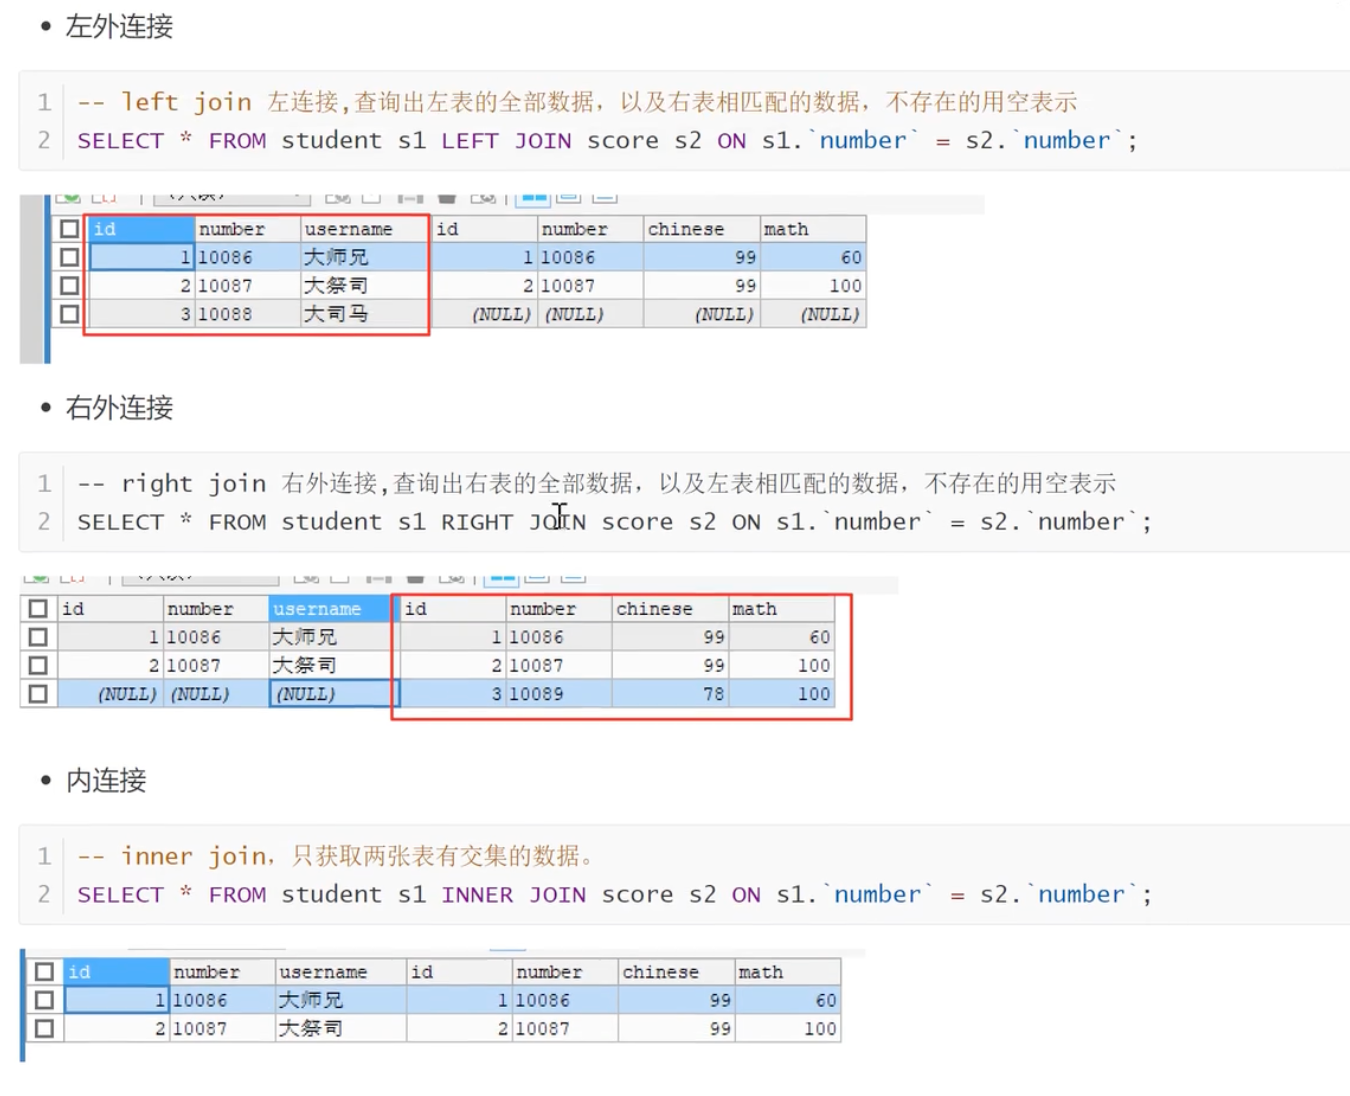
JOIN操作有几种方式,取决于最终数据的合并效果:

  • 左外连接
  • 右外连接
  • 内连接

    驱动表和被驱动表

    什么是驱动表?
    •多表关联查询的时候,第一个被处理的表就是驱动表,使用驱动表关联其他表。
    •驱动表的确定是非常关键的,会直接影响到多表关联的顺序,还有决定了后续的关联查询的性能。
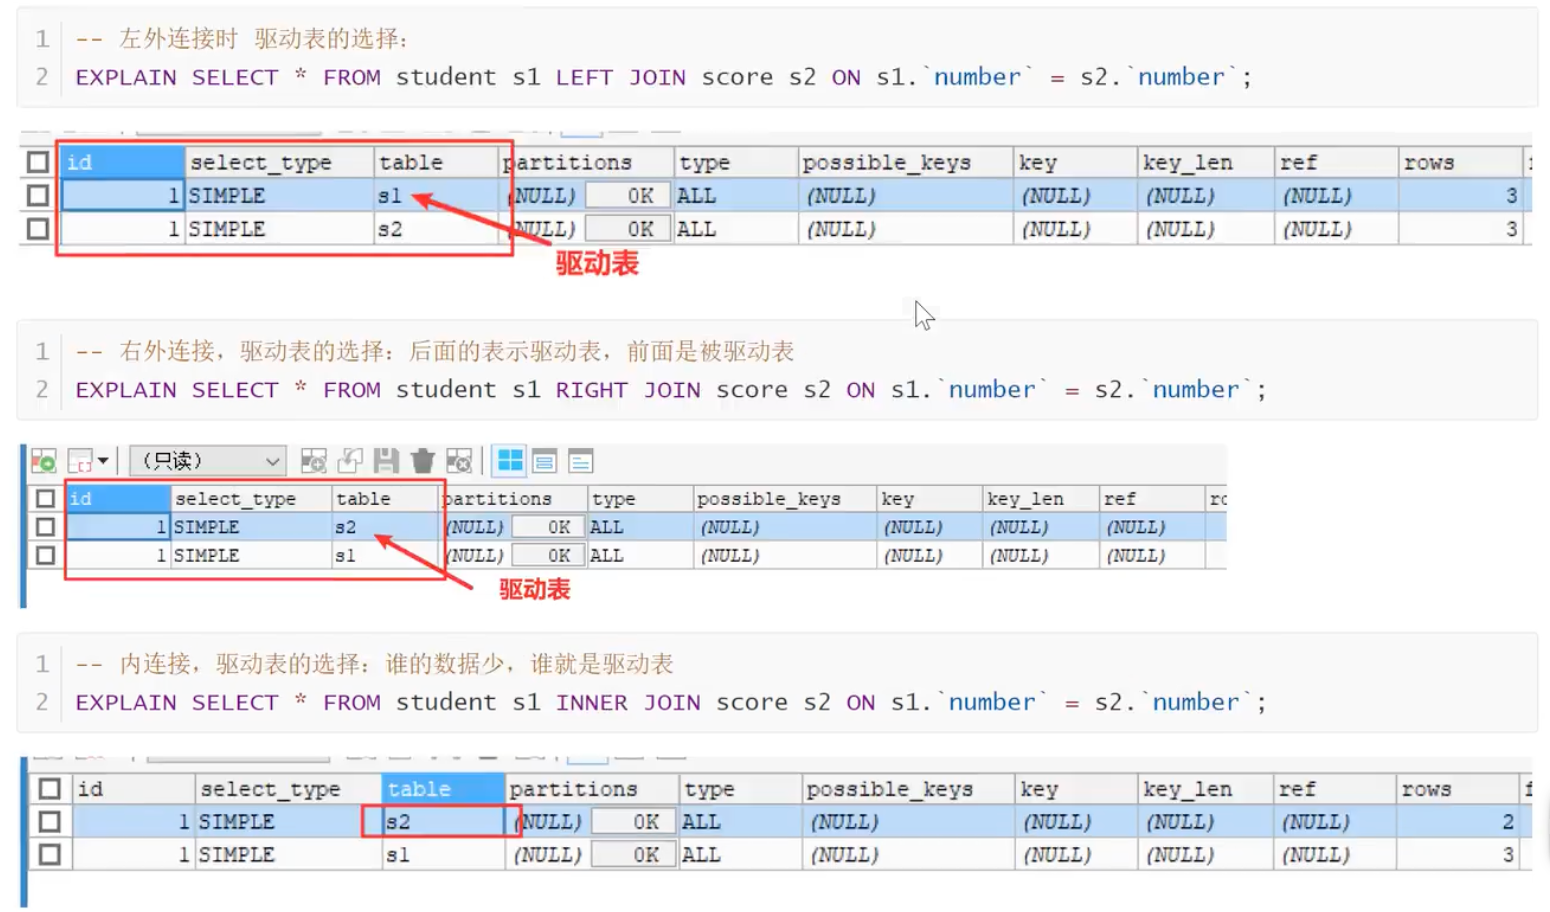
    通过Explain执行计划,验证一下不同的连接查询情况下,驱动表的选择

1)连接查询没有where条件的时候
2) 连接查询存在where条件:

  • 带where条件的表就是驱动表,否则是被驱动表
1
2
3
4
5
EXPLAIN SELECT * FROM student s1 LEFT JOIN score s2 ON s1.`number` = s2.`number` WHERE s2.`id` = 2;

EXPLAIN SELECT * FROM student s1 RIGHT JOIN score s2 ON s1.`number` = s2.`number` WHERE s1.`id` = 2;

EXPLAIN SELECT * FROM student s1 RIGHT JOIN score s2 ON s1.`number` = s2.`number` WHERE s2.`id` = 2;

3) 驱动表选择的原则:在对最终的结果集没有影响的情况下,优先选择结果集小的那张表作为驱动表。

JOIN 算法原理

SNL 算法

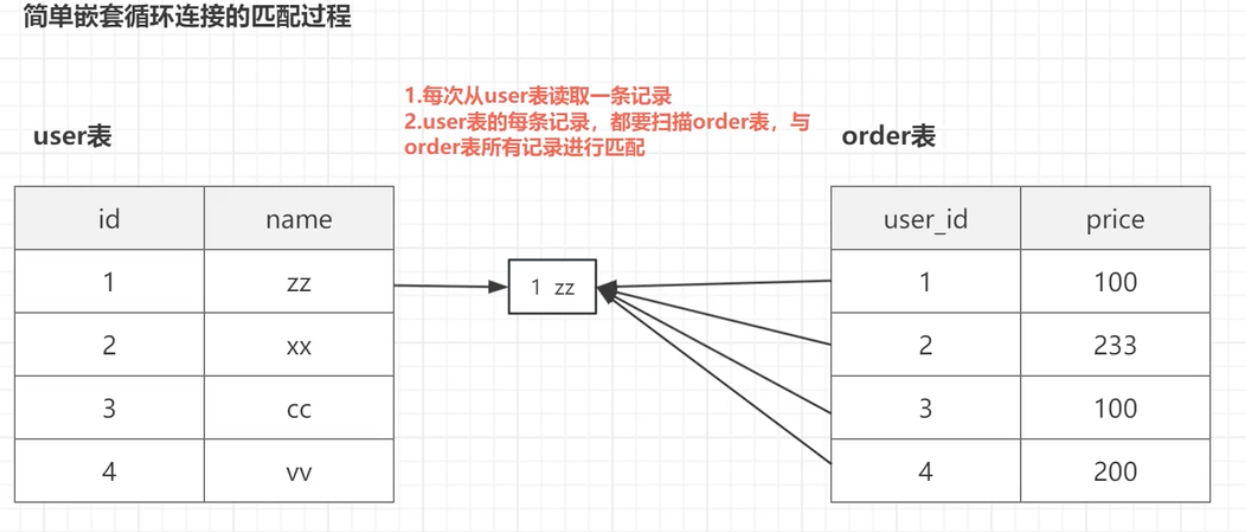
Simple Nested Loop JOIN 简单嵌套循环连接

简单嵌套循环连接就是一个双层for循环,通过循环外层表的行数据,逐个与内层表的行数据进行比较来获取结果。

1
2
3
4
5
6
7
8
9
10
11
-- 连接用户与订单表,连接条件 用户表id = 订单表的user_id
select * from user u left join order o on u.id = o.id;

-- 转换成代码后
for(URow : use表){
for(ORow : order){
if(URow.id = ORow.id){
return URow;
}
}
}

SNL的特点

  • 简单粗暴,容易理解,就是通过双层循环比较数据,获取结果。
  • 查询效率非常低,假设A表有N行,B表有M行,SNL开销:
    • A表扫描1次
    • B表扫描M次
    • 一个有N个内循环,每个内循环就要M次,一共是N*M次。

Index Nested Loopjoin 索引嵌套循环连接

与SNL的区别:减少了内层表的数据的匹配次数,主要是因为在join字段(指的是被驱动表中的用于连接的字段)上建立了索引。
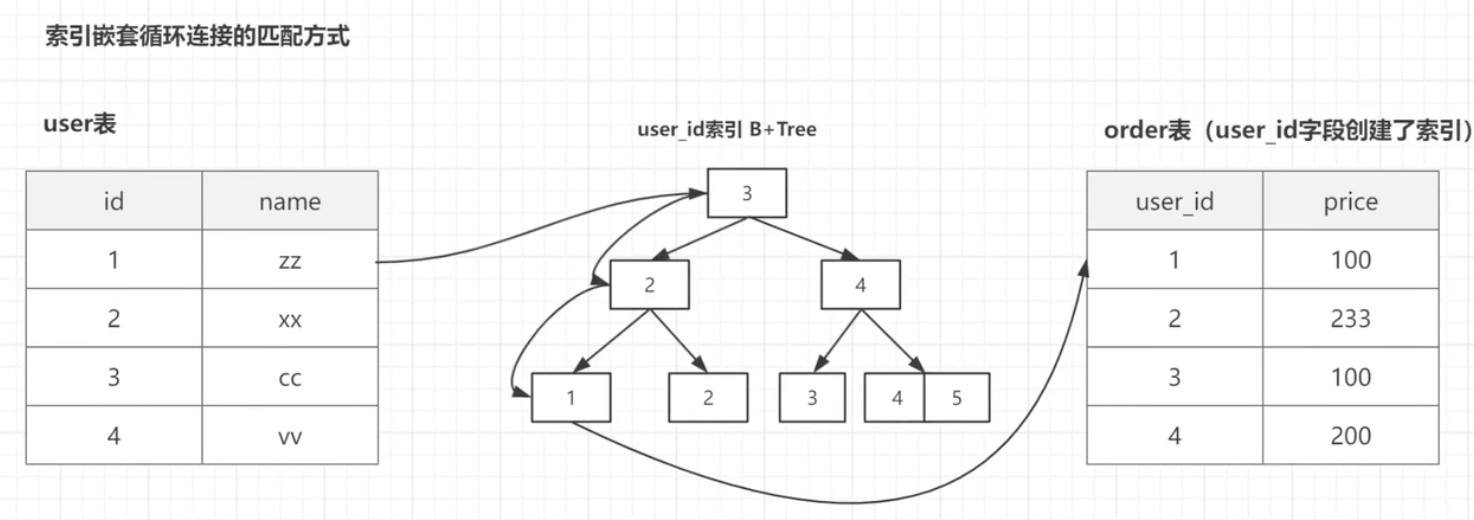
从原来 匹配次数=外层表行数*内层表行数,变成了匹配次数=外层表行数* 内层表连接字段的索引高度,从而提升了JOIN的性能。
注意:使用Index Nested loopjoin算法,前提是被驱动表的匹配字段,必须建立索引。

Block Nested Loop Join 块嵌套循环连接

在没有使用到索引字段进行表连接的时候,MYSQL会选择使用BNL块嵌套循环连接,通过加入buffer缓冲区,降低内循环的次数。
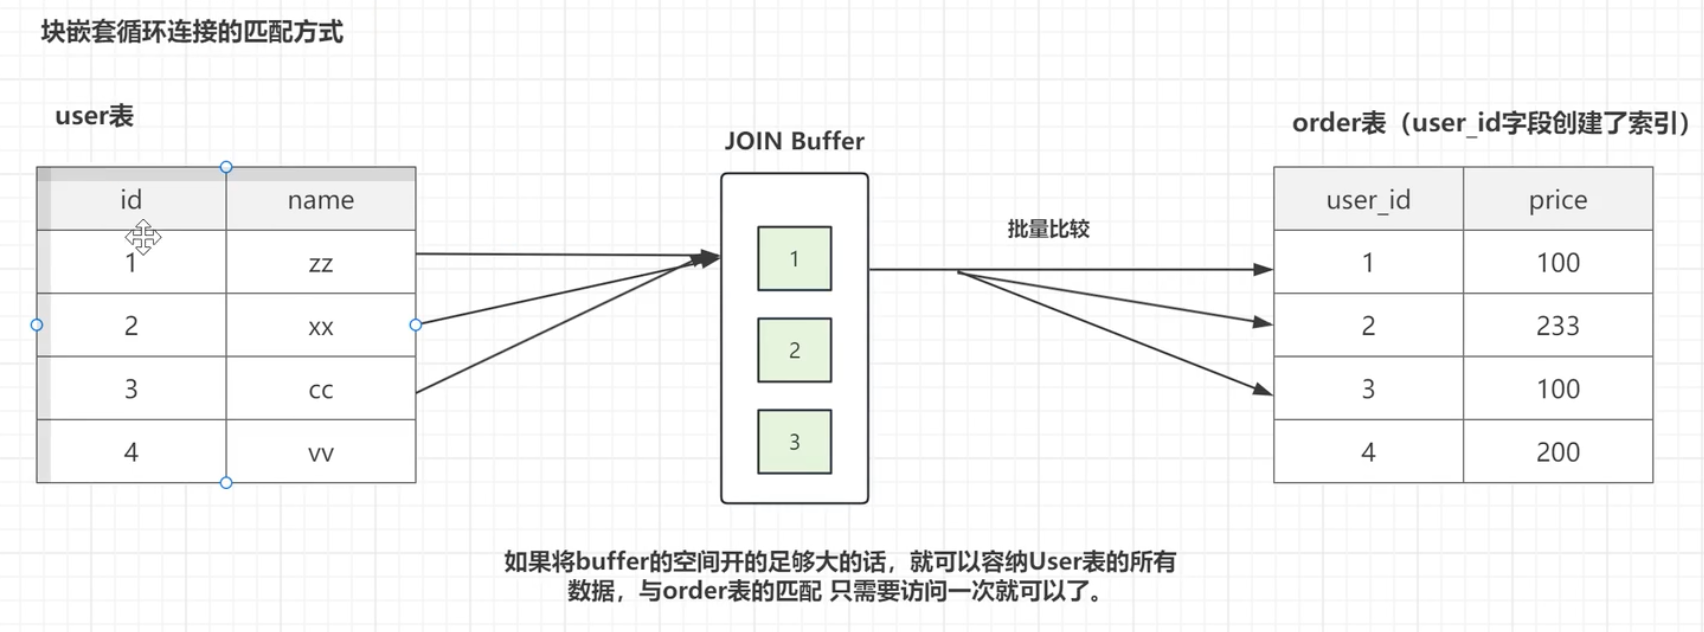
调整join buffer的大小

1
2
3
4
5
6
7
-- JOIN buffer 的大小,默认大小是256K。
SHOW VARIABLES LIKE '%join_buffer%';

SELECT 262144 / 1024;

-- 设置JOIN Buffer的大小
SET SESSION join_buffer_size = 262144;

JOIN使用总结:

  1. 永远用小的结果集去驱动大的结果集(本质就是减少外层循环的数据数量)。
  2. 应该为匹配的条件 增加索引(減少内层表的循环匹配次数)。
  3. 增加 join buffer的大小(一次缓存的越多,内层表扫描的次数就越少)
  4. 减少不必要的字段查询(字段越少,join buffer所缓存的数据就越多)

in函数 和 exists函数

小表去驱动大表,目的是为减少数据库连接的次数

in函数

1
2
-- 需求: 使用in函数将所有部门下的员工查出来
SELECT * FROM employee e WHERE e.`dep_id` IN (SELECT id FROM department);

in函数执行原理

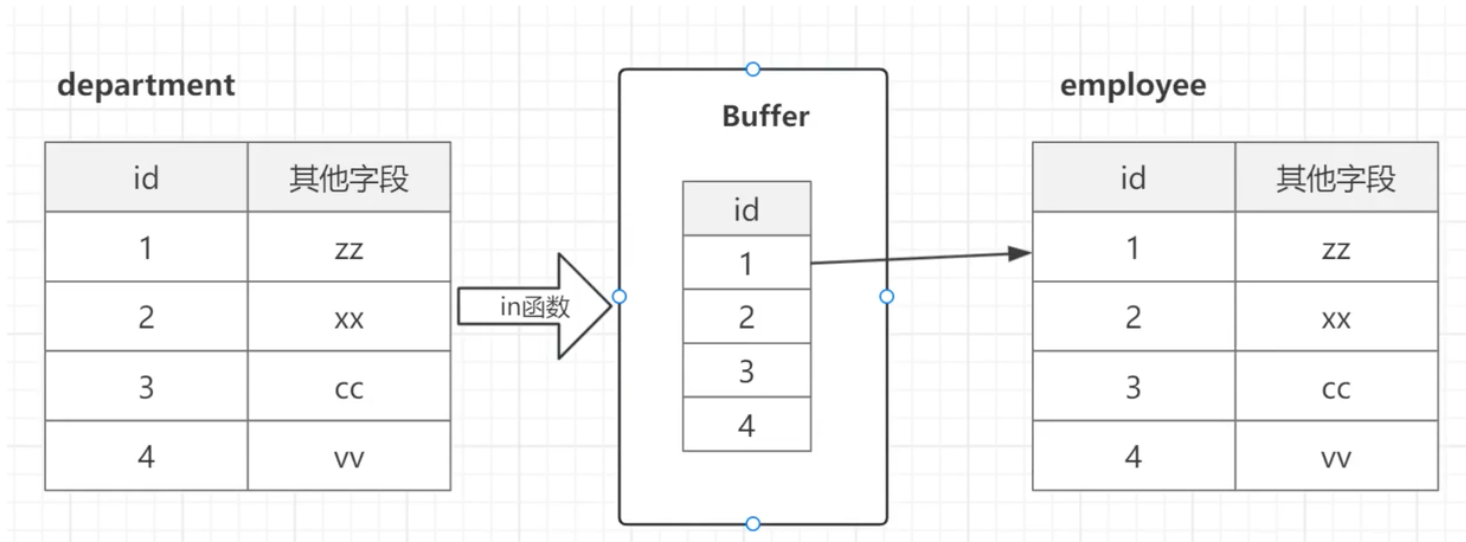
  • in语句,只执行一次,将部门表中所有的id字段查询出来,并缓存,接下来就是比较的过,伪代码:
1
2
3
4
5
6
7
8
for(did : dept){ --小表  SELECT id FROM department
for(eid : emp){ 大表
if(did == eid){ SELECT * FROM employee e WHERE e.`dep_id` = dept_id
return e;
break;
}
}
}

exists函数

1) exists函数介绍

  • 是一个用于判断子查询是否返回结果的条件函数,返回值是boolean类型。通常使用的场景是判断一个子查询是否至少返回一行数据,根据判断结果进行相应操作。

2) exists函数语法

1
2
select col from table where exists(subquery);
subquery:是一个子查询,用于判断是否存在满足特定条件的数据行。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
-- 查询有员工的部门
-- 连接查询
SELECT
DISTINCT d.*
FROM department d LEFT JOIN employee e ON d.`id` = e.`dep_id`
WHERE e.`dep_id` IS NOT NULL;

-- exists函数
SELECT * FROM department d WHERE EXISTS(
SELECT 1 FROM employee e WHERE e.`dep_id` = d.`id`
);

-- 2.查询没有员工的部门
SELECT
DISTINCT d.*
FROM department d LEFT JOIN employee e ON d.`id` = e.`dep_id`
WHERE e.`dep_id` IS NULL;

-- exists函数
SELECT * FROM department d WHERE NOT EXISTS(
SELECT 1 FROM employee e WHERE e.`dep_id` = d.`id`
);

-- 3.查询有部门的员工
SELECT * FROM employee e WHERE e.`dep_id` IS NOT NULL; -- 有问题SQL

SELECT * FROM employee e WHERE EXISTS(
SELECT 1 FROM department d WHERE d.`id` = e.`dep_id`
);

-- 4.查询没有部门的员工
SELECT * FROM employee e WHERE NOT EXISTS(
SELECT 1 FROM department d WHERE d.`id` = e.`dep_id`
);

3) exists特点

  • exists子句返回的是一个布尔类型值,如果有符合条件的数据返回true,否则返回FALSE
  • 如果为true,外层的查询语句就会进行匹配,否则外层查询语句就不进行查询。

5) exists执行原理

1
2
3
4
5
6
7
8
9
10
11
12
SELECT * FROM employee e WHERE EXISTS(
SELECT 1 FROM department d WHERE d.`id` = e.`dep_id`
);

-- 先循环 SELECT * FROM employee e
-- 再判断 SELECT 1 FROM department d WHERE d.`id` = e.`dep_id`

for(e : emp){
if(exists(e.dept_id)){
return e;
}
}

in和exists的区别

  • 如果子查询得出的结果集记录比较少,主查询中的表比较大并且有索引,该用in。
  • 如果主查询结果集得出的记录比较少,子查询的表比较大,并且有索引,该用exists。

一句话:in后面跟的是小表,exists后面跟的是大表。