什么是成本?
在MySQL中,一条查询语句的执行成本实际上是由两部分构成的:
- I/O 成本
- MyISAM 和 InnoDB都需要将数据和索引存储到磁盘,当进行查询时,就需要把数据或者索引加载到内存中。从磁盘到内存这个加载过程,损耗的时间,我们称之为 I/O成本。
- CPU成本
- 读取记录的时候,需要检测记录是否满足对应的搜索条件、对结果集进行排序等等操作发生的损耗都称之为 CPU成本。
- 成本常数
MySQL中找出成本最低方案的过程,大致如下:
- 根据搜索条件,找出所有可能使用的索引。
- 计算全表扫描的代价。
- 计算使用不同索引,执行查询的代价。
- 对比各种执行方案的代价,找出成本最低的那个。
根据搜索条件,找出所有可能使用的索引。
1 | SELECT * FROM orders |
| Indexes | Columns | Index Type |
|---|---|---|
| PRIMARY | id | Unique |
| u_idx_day_status | insert_time, order_status, expire_time | Unique |
| idx_order_no | order_no | |
| idx_expire_time | expire_time | |
| idx_note | order_note |
分析一下上面SQL中的涉及到的搜索条件:
1) IN (‘DD00_6S’, ‘DD00_9S’, ‘DD00_10S’)这个搜索条件,可以使用二级索引:idx_order_no。
2) AND expire_time > ‘2021-03-22 18:28:28’ AND expire_time <= ‘2021-03-22 18:35:09’这个搜索条件可以使用二级索引 idx_expire_time。
3) AND insert_time > expire_time: 这个搜索条件索引列没有和常数进行比较,所以就不能使用索引。
4) AND order_note LIKE ‘%7排1%’: order_note是有索引的,但是由于like查询 % 出现在了左边,不符合最左前缀原则,索引索引就失效。
5) AND order_status = 0; order_status 是处在联合索引的第二个位置上,所以索引是无法使用的。
1 | EXPLAIN SELECT * FROM orders |
| id | select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | orders | . | range | idx_order_no,idx_expire_time | idx_expire_time | 5 | (NULL) | 38 | 0.13 | Using index condition; Using where |
计算全表扫描的代价
对于InnoDB存储引擎来说,全表扫描指的就是把聚簇索引中的记录和给定的搜索条件依次进行比较,把符合条件的记录加入到结果集中。要把聚簇索引对应的页面加载到内存中,然后在检测记录是否符合条件。
查询成本 = I/O成本+CPU 的成本,所以就计算全表扫描的代价需要两个信息:
1) 聚簇索引占用的页面数
2) 该表的记录数
1 | show table status like 'orders'\G |
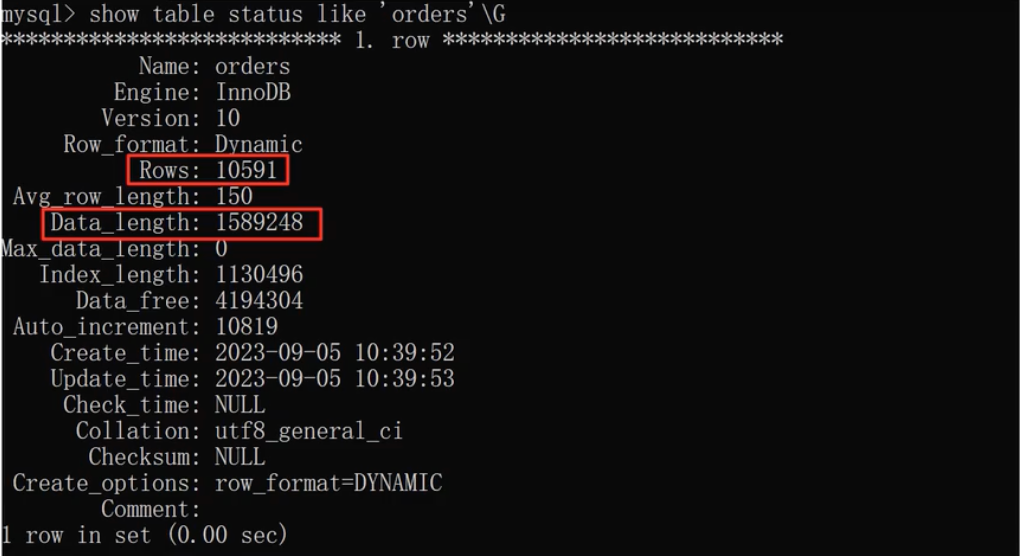
1) rows :表示的是表中的记录数,值为10591。而实际的记录数为10567。在InnoDB中 rows是一个估值。但是计算成本的时候,按照 show table status like ‘orders’\G显示的结果来进行计算。
2) Data_length :表示当前表 占用的存储空间的字节数。对于InnoDB来说,聚簇索引占用的存储空间的大小就是该值的大小。
- Data_length = 聚簇索引的页面的数量 x 每个页面的大小。
- 聚簇索引页面数量 = 1589248 / 16 / 1024 = 97
得到上两个值之后,接下来计算一下全表扫描的成本:
- I/O成本: 97 x 1.0 + 1.1 = 98.1;
- 97表示聚簇索引页面数
- 1.0 表示加载一个页面的成本常数
- 1.1 是一个微调值
- CPU成本: 10591 x 0.2 + 1.0 = 2119.2
- 10591表中记录数,但是是估算值
- 0.2 访问一条记录所需的成本常数
- 1.0 微调值。
- I/O + CPU,全表扫描所需总成本 = 2217.3
计算使用不同的索引,执行查询的代价
使用idx_expire_time执行查询的成本分析
对应的搜索条件为:
1 | AND expire_time> '2021-03-22 18:28:28' AND expire_time<= '2021-03-22 18:35:09' |
上面的条件的区间范围是 2021-03-22 18:28:28 , 2021-03-22 18:35:09
使用idx_expire_time进行搜索会使用 二级索引 + 回表查询的方式,MySQL计算这种查询的成本的依赖两个方面的数据:
1) 范围区间的数量
- 查询优化器认为 读取索引一个范围区间的I/O 成本和读取一个页是相同。
- 范围区间的二级索引付出的I/O 成本: 1 x 1.0 = 1.0;
2) 需要回表的记录数
对于本例来说,就是要计算2021-03-22 18:28:28到2021-03-22 18:35:09这个范围中包含多少二级索引记录,计算过程: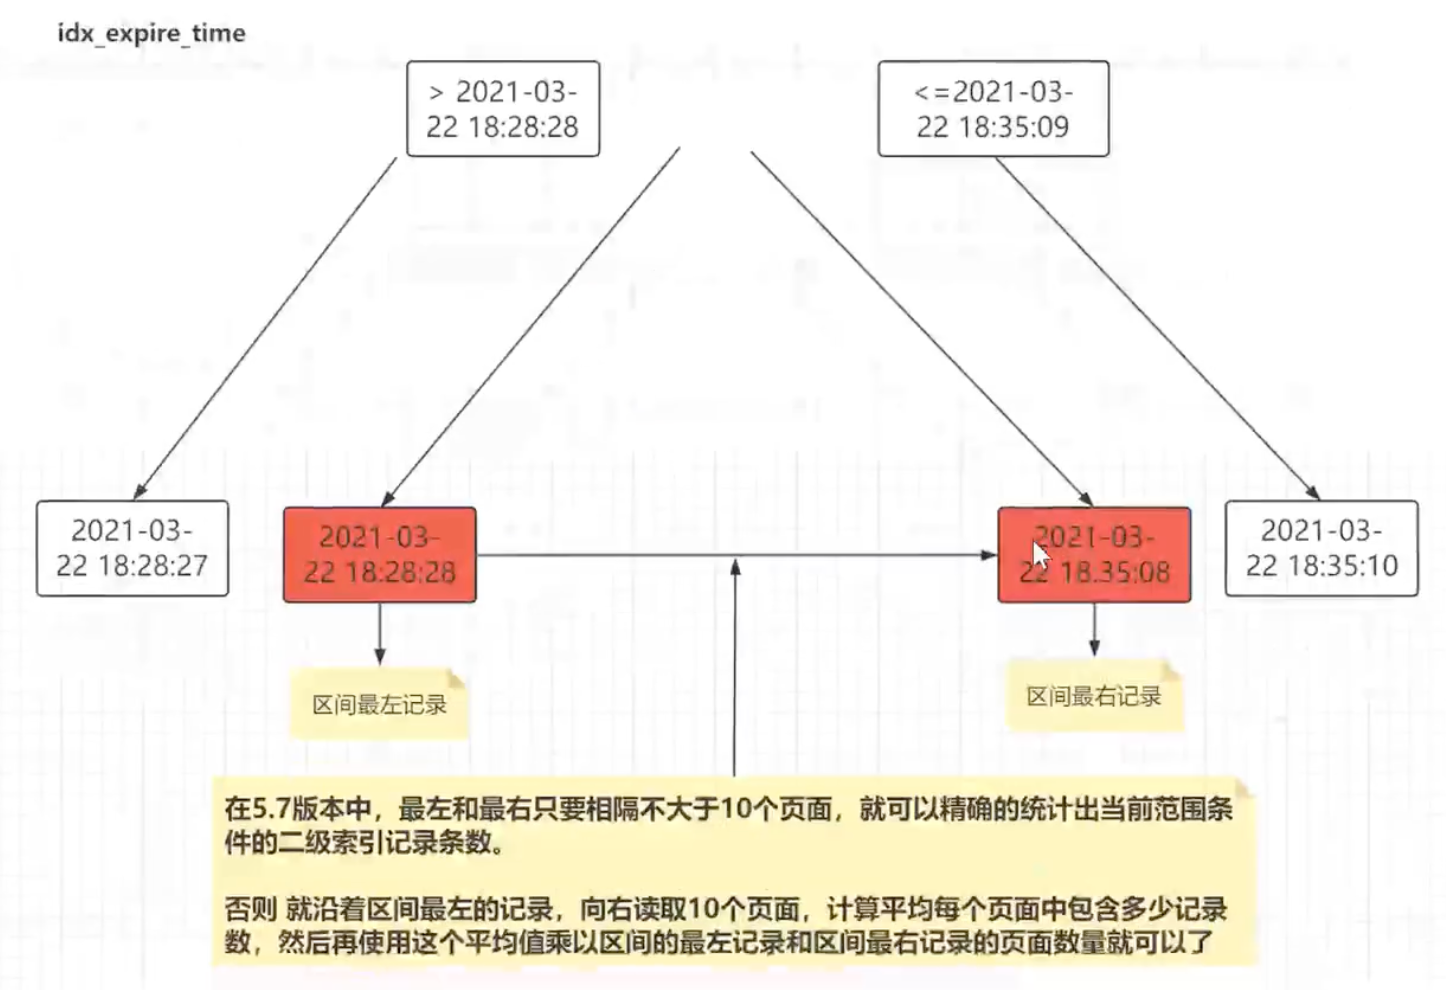
根据MySQL的算法,测出的该二级索引的范围区间的记录数大约是:
AND expire_time> ‘2021-03-22 18:28:28’ AND expire_time<= ‘2021-03-22 18:35:09’ 之间大约有38条记录。
| id | select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | orders | . | range | idx_order_no,idx_expire_time | idx_expire_time | 5 | (NULL) | 38 | 0.13 | Using index condition; Using where |
读取38条二级索引记录需要付出CPU成本:
- 38 x 0.2 + 0.01 = 7.61
在通过二级索引获取到记录之后,还要干两件事情:
- 根据这些记录的主键值,到聚簇索引中做回表操作:
- 二级索引之间有多少记录,就需要多少次回表,有多少次回表,就需要进行多少次的页面IO。
- 上面的执行计划中预计有38条需要进行回表,回表带来的I/O成本: 38 x 1.0 = 38
回表操作后,得到完整的用户记录,然后在检测其他的搜索条件是否成立。
找到完整的记录之后,再检测
1
2
3
4
IN ('DD00_6S', 'DD00_9S', 'DD00_10S')
AND insert_time > expire_time
AND order_note LIKE '%7****排1%'
AND order_status = 0;二级索引区间范围中共有38条数据,对应了聚簇索引汇中38条完整记录,读取并且检测是否符合其余查询条件的CPU成本: 38 x 0.2 = 7.6
本例中,使用idx_expire_time索引执行查询的成本如下:
- I/O成本: 38 x 1.0 + 1.0 = 39
- CPU成本: 38 x 0.2 +0.01 + 38 x0.2 = 15.21 (读取二级索引记录的成本 + 读取并检查回表聚簇索引的记录成本)
idx_expire_time执行查询的总成本就是: 39 + 15.21 = 54.21
补充
- 为什么这里计算I/O 没有微调参数?
I/O 相关的微调值 只有在全量表扫描时才会使用,当前两次I/O成本计算直接使用页数 × 1.0 来计算 - 为什么这里计算CPU 有的加微调参数,有的没加?
上面两处CPU成本计算
+0.01 是 MySQL 给”读取索引记录”这一操作附带的固定启动成本,只挂在 cpu_index_tuple_cost 的计算路径上
而”回表读取聚簇索引完整记录”走的是 cpu_tuple_cost 路径,公式里本来就没有这个常数项
小结—>不同场景计算公式不同
使用idx_order_no执行查询的成本分析
idx_order_no 对应的搜索条件是
1 | IN ('DD00_6S', 'DD00_9S', 'DD00_10S') |
上面的条件是三个单点区间:
- 访问这三个范围区间的二级索引付出的I/O成本: 3 x 1.0 = 3
- 需要回表的记录数:为58
| id | select_type | table | p.. | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | orders | . | range | idx_order_no | idx_order_no | 152 | (NULL) | 58 | 100.00 | Using index condition |
- 读取这些二级索引记录的CPU成本: 58 x 0.2 + 0.01 = 11.61
- 根据这些记录的主键值到聚簇索引中做回表。所需的I/O成本: 58 x 1.0 = 58.0
- 获取到完整记录之后,还需要用其他条件进行检查过滤, CPU成本: 58 x 0.2 = 11.6
- 所以本例中的成本总值为:
- IO成本: 3 + 58 x 1.0 = 61 (范围区间数量 + 预估二级索引的记录数)
- CPU成本: 58 x 0.2 + 0.01 + 58 x 0.2 = 23.21
- 总成本: 61 + 23.21 = 84.21
对比各种方案,找出成本最低的
- 全表扫描:2117.3
- 使用idx_expire_time索引:54.21
- 使用idx_order_no索引:84.21
最终选择 idx_expire_time。
连接查询成本
驱动表的扇出值计算
连接查询成本的构成:
1) 单次查询驱动表的成本
2) 多次查询被驱动表的成本
对驱动表进行查询后,得到的记录条数称之为驱动表的扇出。
查询1
1 | select * from orders as s1 inner join orders2 as s2; |
假设s1是驱动表,只能使用全表扫描,扇出值很好计算,就是驱动表中有多少条记录,扇出值就是多少.
查询2
1 | select * from orders as s1 inner join orders2 as s2 |
假设s1表是驱动表,对于驱动表的查询可以使用到索引idx_expire_time进行查询,此时区间范围的记录有多少,扇出值就是多少。
连接查询成本分析
连接查询成本计算公式:
连接查询的总成本 = 单次访问驱动表的成本 + 驱动表扇出数 x 单次访问被驱动表的成本。
- 左外或者右外连接只需要分别为驱动表和被驱动表选择成本最低的访问方法就可以了,因为驱动表固定的。
- 如果是内连接,驱动表和被驱动表可以互换的,所以要考虑两个问题:
- 要选择最优表连接顺序
- 分别为驱动表和被驱动表选择成本最低的访问方法
1 | SELECT |
在Explain 和查询语句之间,加一个 FORMAT = JSON,得出一个JSON格式的计划,里面就有该计划花费的成本:
1 | explain FORMAT = JSON SELECT |