主从模式
架构模式
1 | +----------+ |
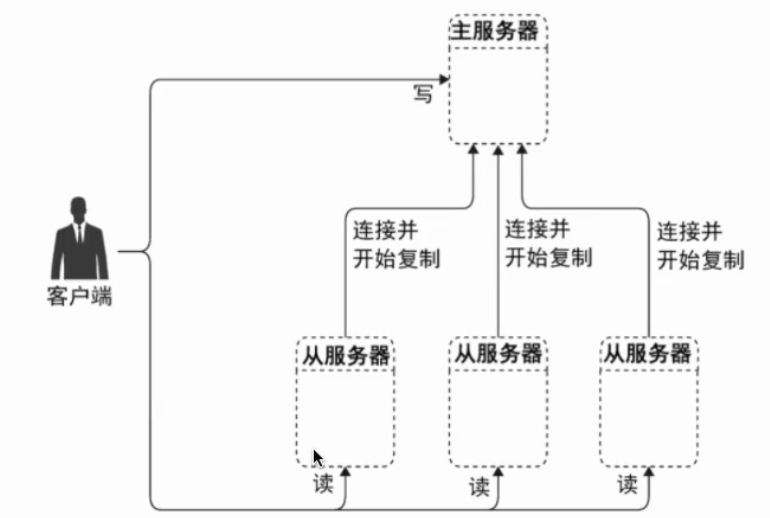
一主多从复制有四大优点:分摊负载、专机专用、便于冷备、高可用。
实现原理
复制概述
Replication,MySQL 的主从复制是一种数据同步机制,除了可以将一个主数据库中的数据同步复制到一个从数据库上,还可以将一个主数据库上的数据同步复制到多个从数据库上,也就是所谓的 MySQL 的一主多从复制。
多个从数据库关联到主数据库后,将主数据库上的 Binlog 日志同步地复制到了多个从数据库上,通过执行日志,每个从数据库的数据都和主数据库上的数据保持了一致。
这里面的数据更新操作表示的是所有数据库的更新操作,除了 SELECT 之类的查询读操作以外,其他的 INSERT、DELETE、UPDATE 这样的 DML 写操作,以及 CREATE TABLE、DROP TABLE、ALTER TABLE 等 DDL 操作都可以同步复制到从数据库上去。
Replication,复制使来自一个MySQL数据库服务器(源)的数据可以复制到一个或多个MySQL数据库服务器(副本)。
- 默认情况下,复制是异步的
- 复制品不需要永久连接即可接收源的更新
- 根据配置,可以复制数据库中的所有数据库、选定的数据库,甚至选定的表。
MySQL中复制的优点包括:
- 扩展解决方案:在多个副本之间分散负载以提高性能。
- 读写分离,所有写入和更新都必须在源服务器上进行。然而,读取可能会在一个或多个副本上进行。
- 该模型可以提高写入性能(源服务器专门用于更新),同时大幅提高越来越多的副本的读取速度。
- 数据安全:由于副本可以暂停复制过程,因此可以在副本上运行备份服务,而不会损坏相应的源数据。
- 分析:可以在源代码上创建实时数据,而信息分析可以在副本上进行,而不会影响源的性能。
- 远程数据分发:可以使用复制创建本地数据副本供远程站点使用,而无需永久访问源。
异步复制
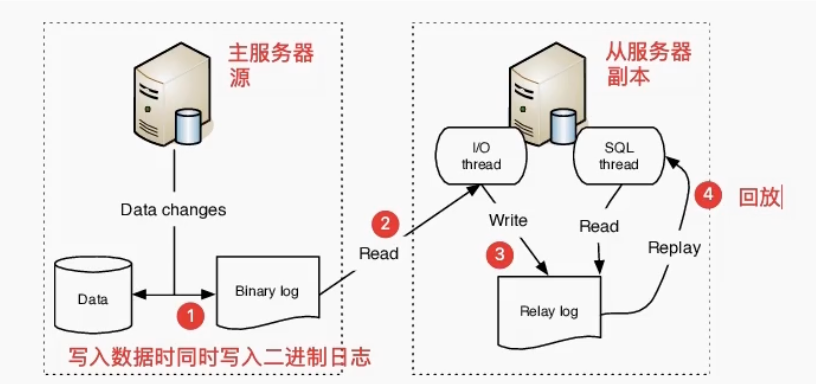
复制流程:
- 主库 Master 将数据库的变更操作记录在二进制日志 Binary Log 中。
- 备库 Slave 读取主库上的日志并写入到本地中继日志 Relay Log 中。
- 备库读取中继日志 Relay Log 中的 Event 事件在备库上进行重放 Replay(回放)。
线程工作:
- Master 服务器上对数据库的变更操作记录在 Binlog 中。
- Master 的 Binlog Dump Thread 接到写入请求后读取 Binlog 推送给 Slave I/O Thread。
- Slave I/O Thread 将读取的 Binlog 写入到本地 relay log 文件。
- Slave SQL Thread 检测到 relay log 的变更请求,解析 relay log 并在从库上进行应用。
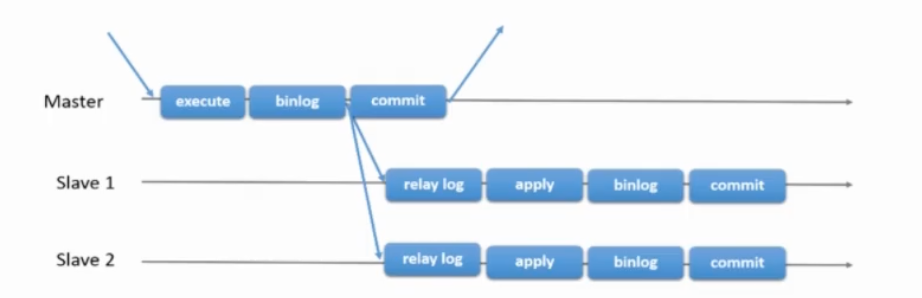
以上整个复制过程都是异步操作,所以主从复制俗称异步复制(MySQL 默认的复制策略),存在数据延迟。Master 数据变更后记录 Binlog,只是通知 Binlog Dump Thread 线程处理,然后告诉存储引擎提交事务,并不会关注 Slave 是否接受并落地 Binlog Event。
异步复制性能最好,但是一旦 Master 崩溃,发送主从切换将会发送数据不一致性的风险。
考虑到一个场景:主库正常写入数据并提交事务 T1,但是 Slave1 和 Slave2 由于某种原因(例如网络原因)一直无法接受到 Binlog Dump Thread Event 的推送请求,如果这时候 Master Crash,Slave 提升为 Master 后导致事务 T1 数据丢失。
全同步复制
指当主库执行完一个事务,所有的从库都执行了该事务才返回给客户端。因为需要等待所有从库执行完该事务才能返回,所以全同步复制的性能必然会收到严重的影响。
对于全同步复制,当主库提交事务之后,所有的从库节点必须收到,APPLY并且提交这些事务,然后主库线程才能继续做后续操作。这里面有一个很明显的缺点就是,主库完成一个事务的时间被拉长,性能降低。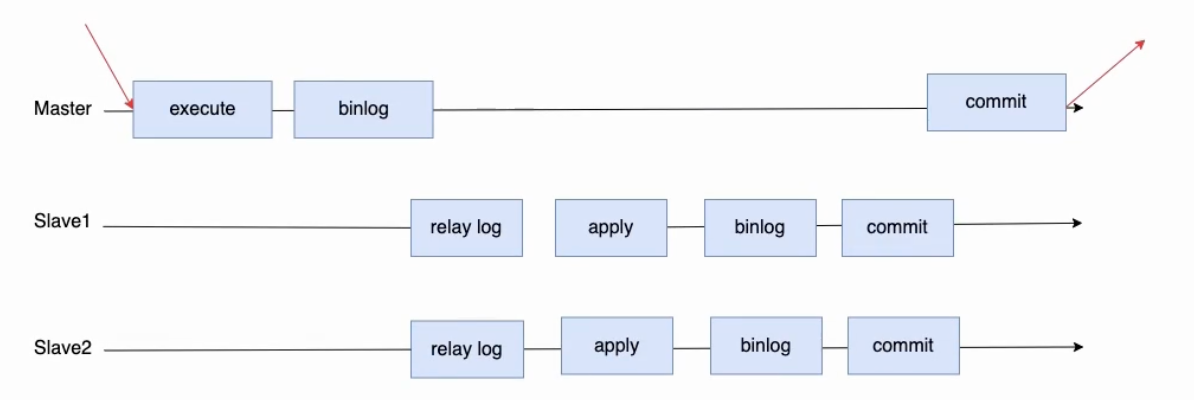
半同步复制
除了内置的异步复制外,MySQL 8.0还支持由插件实现的半同步复制接口。半同步复制介于异步复制和全同步复制之间。主服务器等待至少一个副本接收并记录事件,然后提交事务。
主服务器不会等待所有副本确认接收,它只需要副本的确认,而不是事件已在副本端完全执行和提交。因此,半同步复制保证,如果主服务器崩溃,它提交的所有事务都已传输到至少一个副本。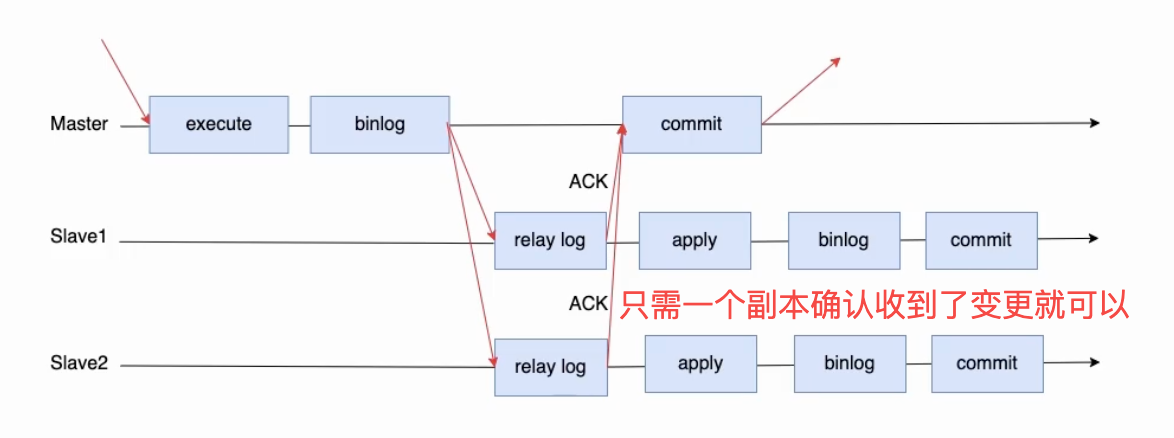
相比异步复制,半同步复制提高了数据完整性,在一个事务提交成功之后,这个事务就至少会存在于两个地方(主服务器、某一个从服务器)。
与异步复制相比,半同步复制的性能和数据完整性的权衡。
增加的延迟是将提交发送到副本并等待副本确认接收的TCP/IP往返时间(发送binlog到从机、从机写入relay log、从机返回ack)。这意味着半同步复制最适合通过快速网络通信的近距离服务器,而最不适合通过慢网络通信的远程服务器。半同步复制还限制了二进制日志事件从源(主服务器 master)发送到副本(从服务器 slave)的速度,超时时间。当一个用户太忙时,这会减慢速度,这在某些部署情况下可能会有用。
半同步复制具体特性:
- 从库会在连接到主库时告诉主库,它是否支持半同步。
- 如果半同步复制在主库端是开启了的,并且至少有一个半同步复制的从库节点,那么此时主库的事务线程在提交时会被阻塞并等待,结果有两种可能,要么至少一个从库节点通知它已经收到了所有这个事务的Binlog事件,要么一直等待直到超时,如果超时则半同步复制将自动关闭,转换为异步复制。
- 从库节点只有在接收到某一个事务的所有Binlog,将其写入并Flush到Relay Log文件之后,才会通知对应主库上面的等待线程。
- 半同步复制必须是在主库和从库两端都开启时才行,如果在主库上没打开,或者在主库上开启了而在从库上没有开启,主库都会使用异步方式复制。
对于当前会话的客户端进行事务提交后,主库等待 ACK 的过程中有两种情况。
- 事务还没发送到从库,主库 crash 并发起切换,从库为新主库。客户端收到事务提交失败的信息,需要重新提交该事务。
- 事务已经发送到从库,主库 crash 并发起切换,从库为新主库。从库已经应用该事务并写入数据,但客户端连接重置同样会收到事务提交失败的信息,重新提交该事务时会报错数据已存在(如订单已提交成功)
复制延时解决
由于主库和从库是两个不同的数据源,主从复制过程会存在一个延时,当主库有数据写入之后,同时写入 binlog 日志文件中,然后从库通过 binlog 文件同步数据,由于需要额外执行日志同步和写入操作,这期间会有一定时间的延迟。特别是在高并发场景下,刚写入主库的数据是不能马上在从库读取的,要等待几十毫秒或者上百毫秒以后才可以。
主从复制本质是实现的数据的最终一致性,而不是强一致性。在非常短的时间内,主从机器可能会存在数据不一致的情况。
在某些对一致性要求较高的业务场景中,这种主从导致的延迟会引起一些业务问题,比如订单支付,付款已经完成,主库数据更新了,从库还没有,这时候去从库读数据,会出现订单未支付的情况,在业务中是不能接受的。
为了解决主从同步延迟的问题,通常有以下几个方法:
敏感业务强制读主库
在开发中有部分业务需要写库后实时读数据,这一类操作通常可以通过强制读主库来解决。关键业务不进行读写分离
对一致性不敏感的业务,比如电商中的订单评论、个人信息等可以进行读写分离,对一致性要求比较高的业务,比如金融支付,不进行读写分离,避免延迟导致的问题。
读写分离
大多数互联网业务中,往往读多写少,这时候数据库的读会首先成为数据库的瓶颈。如果我们已经优化了SQL,但是读依旧还是瓶颈时,这时就可以选择“读写分离”架构了。读写分离首先需要将数据库分为主从库,一个主库用于写数据,多个从库完成读数据的操作,主从库之间通过主从复制机制进行数据的同步,如图所示。
写:主库
读:主库、从库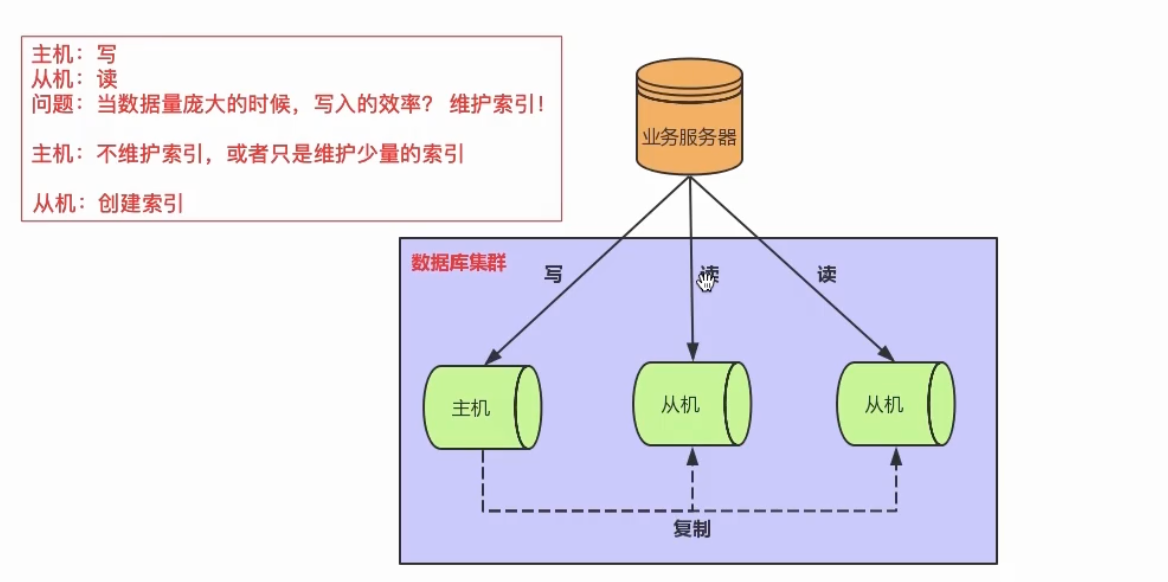
在应用中可以在从库追加多个索引来优化查询,主库这些索引可以不加,用于提升写效率。
读写分离架构也能够消除读写锁冲突从而提升数据库的读写性能。使用读写分离架构需要注意:主从同步延迟和读写分配机制问题
主从同步延迟
使用读写分离架构时,数据库主从同步具有延迟性,数据一致性会有影响,对于一些实时性要求比较高的操作,可以采用以下存储层解决方案。
- 写后立刻读
在写入数据库后,某个时间段内读操作就去主库,之后读操作访问从库。 - 二次查询策略
先去从库读取数据,找不到时就去主库进行数据读取。该操作容易将读压力返还给主库,为了避免恶意攻击,建议对数据库访问API操作进行封装,有利于安全和低耦合。 - 根据业务特殊处理
根据业务特点和重要程度进行调整,比如重要的,实时性要求高的业务数据读写可以放在主库。对于次要的业务,实时性要求不高可以进行读写分离,查询时去从库查询。
读写分离落地
读写路由分配机制是实现读写分离架构最关键的一个环节,就是控制何时去主库写,何时去从库读。目前较为常见的实现方案分为以下两种:
- 基于编程和配置实现(应用层)
程序员在代码中封装数据库的操作,代码中可以根据操作类型进行路由分配,增删改时操作主库,查询时操作从库。这类方法也是目前中小型企业生产环境下应用最广泛的。
优点是实现简单,因为程序在代码中实现,不需要增加额外的硬件开支,缺点是需要开发人员来实现,运维人员无从下手,如果其中一个数据库宕机了,就需要修改配置重启项目。 - 基于数据库代理实现(数据网关层)
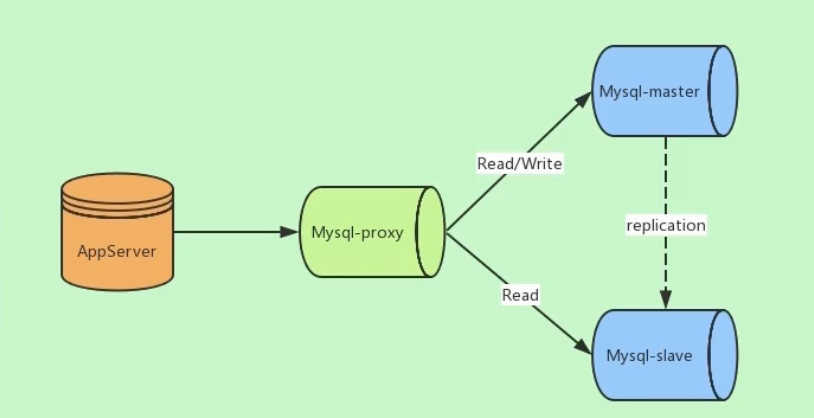
中间件代理一般介于应用服务器和数据库服务器之间,从图中可以看到,应用服务器并不直接进入到master数据库或者slave数据库,而是进入MySQL proxy代理服务器。代理服务器接收到应用服务器的请求后,先进行判断然后转发到后端master和slave数据库。
- MySQL Proxy:是官方提供的MySQL中间件产品可以实现负载平衡、读写分离等。
- MyCat:MyCat是一款基于阿里开源产品Cobar而研发的,基于 Java 语言编写的开源数据库中间件。
- ShardingSphere:ShardingSphere是一套开源的分布式数据库中间件解决方案,它由Sharding-JDBC、Sharding-Proxy和Sharding-Sidecar (计划中)这3款相互独立的产品组成。已经在2020年4月16日从Apache孵化器毕业,成为Apache顶级项目。
- Atlas:Atlas是由 Qihoo 360公司Web平台部基础架构团队开发维护的一个数据库中间件。
主主模式
很多企业刚开始都是使用MySQL主从模式,一主多从、读写分离等。但是单主如果发生单点故障,从库切换成主库还需要作改动。因此,如果是双主或者多主,就会增加MySQL入口,提升了主库的可用性。
因此随着业务的发展,数据库架构可以由主从模式演变为双主模式。双主模式是指两台服务器互为主从,任何一台服务器数据变更,都会通过复制应用到另外一方的数据库中。
工作原理
一主多从,当主数据库宕机不可用的时候,数据依然是不能够写入的,因为数据不能够写入到从服务器上面去,从服务器是只读的。
为了解决主服务器的可用性问题,我们可以使用 MySQL 的主主复制方案。所谓的主主复制方案是指两台服务器都当作主服务器,任何一台服务器上收到的写操作都会复制到另一台服务器上。
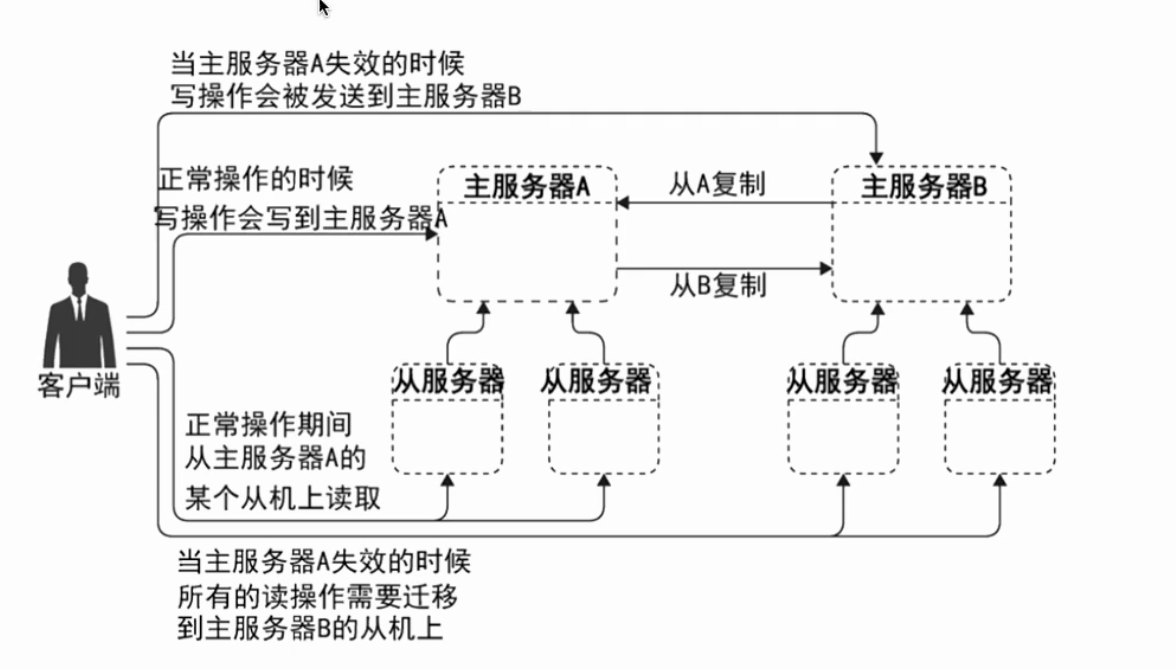
当客户端程序对主服务器 A 进行数据更新操作的时候,主服务器 A 会把更新操作写入到 Binlog 日志中,然后 Binlog 会将数据日志同步到主服务器 B,写入到主服务器的 Relay log 中,然后执行 Relay log,获得 Relay log 中的更新日志,执行 SQL 操作写入到数据库服务器 B 的本地数据库中。B 服务器上的更新也同样通过 Binlog 复制到了服务器 A 的 Relay log 中,然后通过 Relay log 将数据更新到服务器 A 中,通过这种方式,服务器 A 或者 B 任何一台服务器收到了数据的写操作都会同步更新到另一台服务器,实现了数据库主主复制。主主复制可以提高系统的写可用,实现写操作的高可用。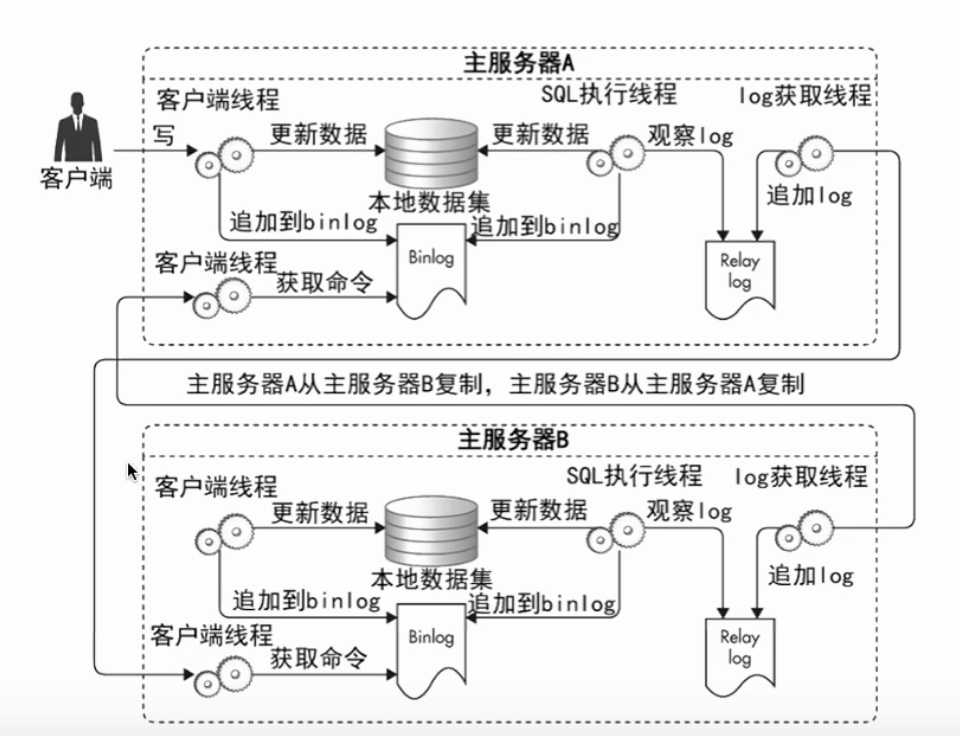
如下图所示,正常情况下用户会写入到主服务器 A 中,然后数据从 A 复制到主服务器 B 上。当主服务器 A 失效的时候,写操作会被发送到主服务器 B 中去,数据从 B 服务器复制到 A 服务器。
再具体看一下主主失效的维护过程,如下图。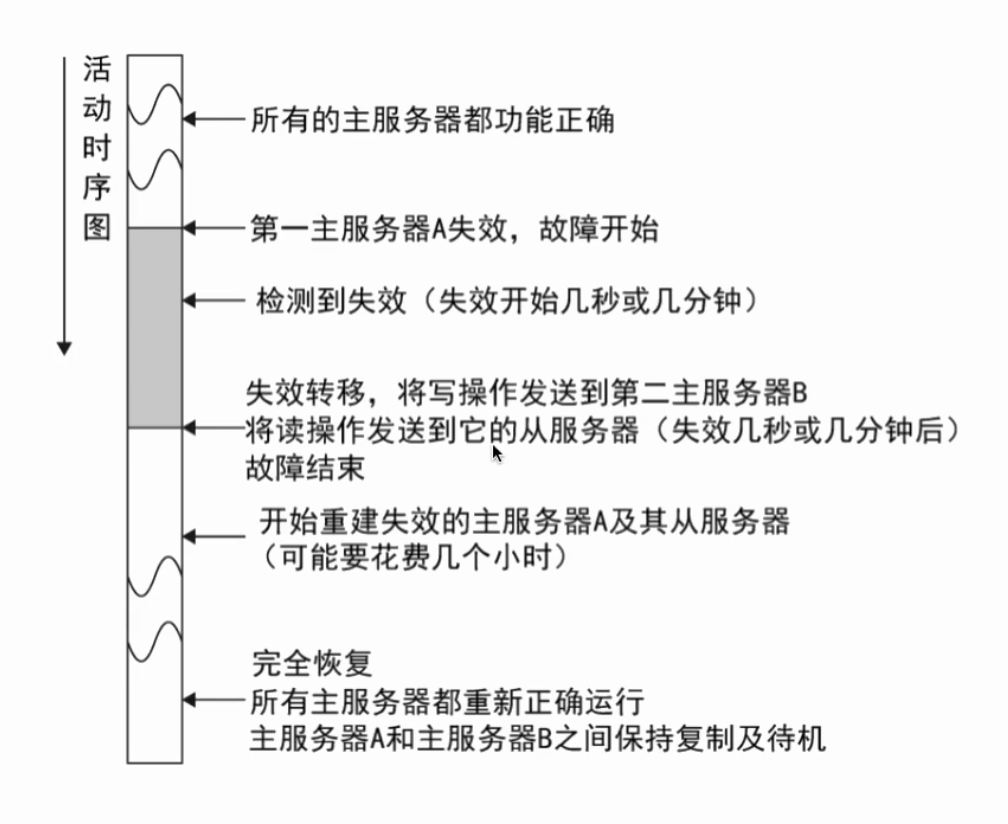
最开始的时候,所有的主服务器都可以正常使用,当主服务器 A 失效的时候,进入故障状态,应用程序检测到主服务器 A 失效,检测过程可能需要几秒钟或者几分钟的时间,然后应用程序需要进行失效转移,将写操作发送到备份主服务器 B 上面去,将读操作发送到 B 服务器对应的从服务器上面去。一段时间后故障结束,A 服务器需要重建失效期间丢失的数据,也就是把自己当作从服务器去从 B 服务器上面同步数据,同步完成后系统才能恢复正常。这个时候 B 服务器是用户的主要访问服务器,A 服务器当作备份服务器。
主主复制注意事项
不要对两个数据库同时进行数据写操作,因为这种情况会导致数据冲突。
两个服务器对同一条记录进行写操作,互相进行数据复制的时候,数据库就不知道哪条数据是正确的。主主复制并没有增加写并发的能力和系统存储能力。
因为数据复制后,所有的数据库存储的数据都是一样的,不管是主主复制,还是主从复制。如果存储资源不足、磁盘不够大,数据复制后,即使写到多个服务器上,存储依然是不够用的。同时,它也没有增加写并发能力,即使使用主主复制,应用程序一个时间内也只能向一个数据库写入。更新数据表的结构会导致巨大的同步延迟。
比如要在一张表中增加一个字段,要执行一个 ALTER TABLE 操作,这个操作会导致同步延迟巨大,因为该操作会阻塞其它的 Binlog 日志同步,这时候主数据库的很多写操作都无法同步到从数据库上面去,导致数据不一致。所以在实践中需要更新表结构的操作,不要写入到 Binlog 中,也就是关闭更新表结构的 Binlog。如果要对表结构进行更新,应该有运维工程师DBA 对所有主从数据库分别手动进行数据表结构的更新操作。
单写还是双写
使用双主双写还是双主单写?
建议大家使用双主单写,因为双主双写存在以下问题:
- ID冲突
- 自增策略,A(1,2)1,3,5…. B(2,2)2,4,6,…
- 分布式ID生成解决方案,借助于雪花算法、中间件生成id
- 写冲突
- 两个客户端分别在同一个时刻针对同一个行数据进行更新,Thread1->A,Thread2—>B
高可用架构如下图所示,其中一个Master提供线上服务,另一个Master作为备胎供高可用切换,Master下游挂载Slave承担读请求。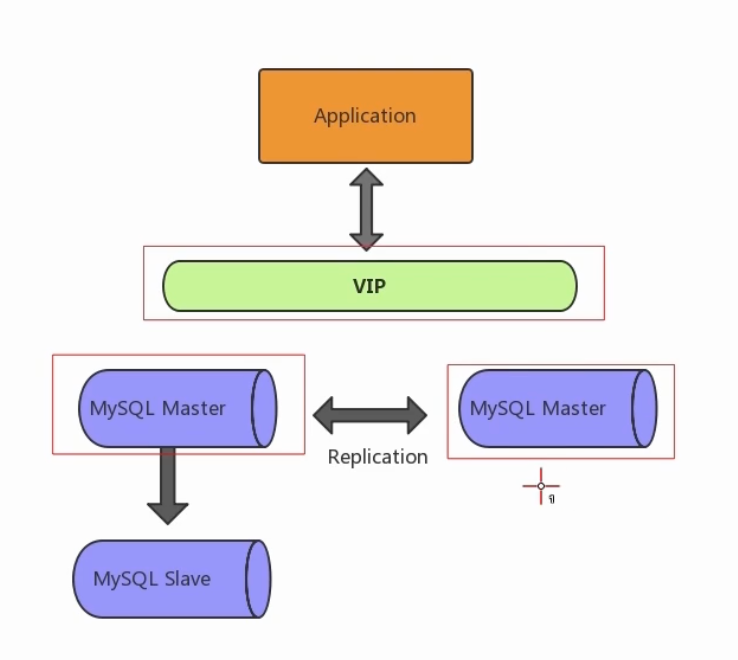
随着业务发展,架构会从主从模式演变为双主模式,建议用双主单写,再引入高可用组件,例如Keepalived和MMM等工具,实现主库故障自动切换。
集群高可用
高可用性
系统高可用的挑战
一个互联网应用想要完整地呈现在最终用户的面前,需要经过很多个环节,任何一个环节出了问题,都有可能会导致系统不可用。
系统的高可用架构,说的就是如何去应对这些问题和挑战。
互联网应用可用性的度量
业务常用的描述方法是“系统的可用性达到几个 9”。这“几个 9”就表示可用水平,正如下图所示,9 越多意味着可用性越高。常说的“5 个 9”意味着系统每年故障时间小于 5.3 分钟,其计算方式也很简单:系统 1 年内服务中断维护了 5 分钟,HA = 1年/(1 年+5 分钟) = 99.999% 。
| HA (可用水平) | T (每年可中断时间) |
|---|---|
| 99.9999% | <1分钟 |
| 99.999% | <5.3分钟 |
| 99.99% | <53分钟 |
| 99.9% | <8小时46分钟 |
| 99% | <87小时36分钟 |
故障分类
故障分类的计算方式是用故障时间乘以故障权重来计算得到的。而故障的权重通常是在故障产生以后,根据影响程度,由运营方确定的一个故障权重值。下图是故障权重的示例。
| 分类 | 描述 | 权重 |
|---|---|---|
| 事故级故障 | 严重故障,网站整体不可用 | 100 |
| A类故障 | 网站访问不顺畅或核心功能不可用 | 20 |
| B类故障 | 非核心功能不可用,或核心功能少数用户不可用 | 5 |
| C类故障 | 以上故障以外的其他故障 | 1 |
故障分=故障时间x故障权重
一般互联网应用的故障处理流程和故障时间的确定,如下图。
(流程图)1
2
3
4
5
6+---------------------+ +---------------------+ +---------------------+ +---------------------+ +---------------------+
| 客服报告故障 | | 提交故障给相关 | | | | 故障处理完毕 | | 确认故障归属 |
| 或 | ---> | 部门接口人 | ---> | 故障接手&处理 | ---> | 故障归档 | ---> | 记入绩效考核 |
| 监控系统发现故障 | | | | | | (故障结束时间) | | |
| (故障开始时间) | +---------------------+ +---------------------+ +---------------------+ +---------------------+
+---------------------+
高可用策略
(1)负载均衡
*   HTTP 重定向负载均衡
*   DNS 负载均衡
*   反向代理负载均衡
*   IP 层负载均衡(四层负载均衡
*   数据链路层负载均衡
(2) 数据库复制与失效转移
(3) 消息队列隔离
(4)限流和降级
* 系统高可用的另一个策略是限流和降级。主要针对的是,在高并发场景下,如果系统的访问量超过了系统的承受能力,如何对系统进行保护
(5)异地多活机房架构
* 系统高可用的另一个策略是异地多活的架构。
(6)高可用运维
*   自动化测试
*   自动化监控
    *   业务指标:用户访问量、订单量、查询量
    *   技术指标:CPU、磁盘、内存
*   预发布
*   灰度发布
高可用架构
MMM 架构
企业初期使用较多的高可用架构:
一类是基于 Keepalived + VIP + MySQL 主从/双主
一类是封装好的 MMM 集群,两者本质是一样的,MMM 相比前者多了一套工具集来帮助运维。
MMM故障处理机制:
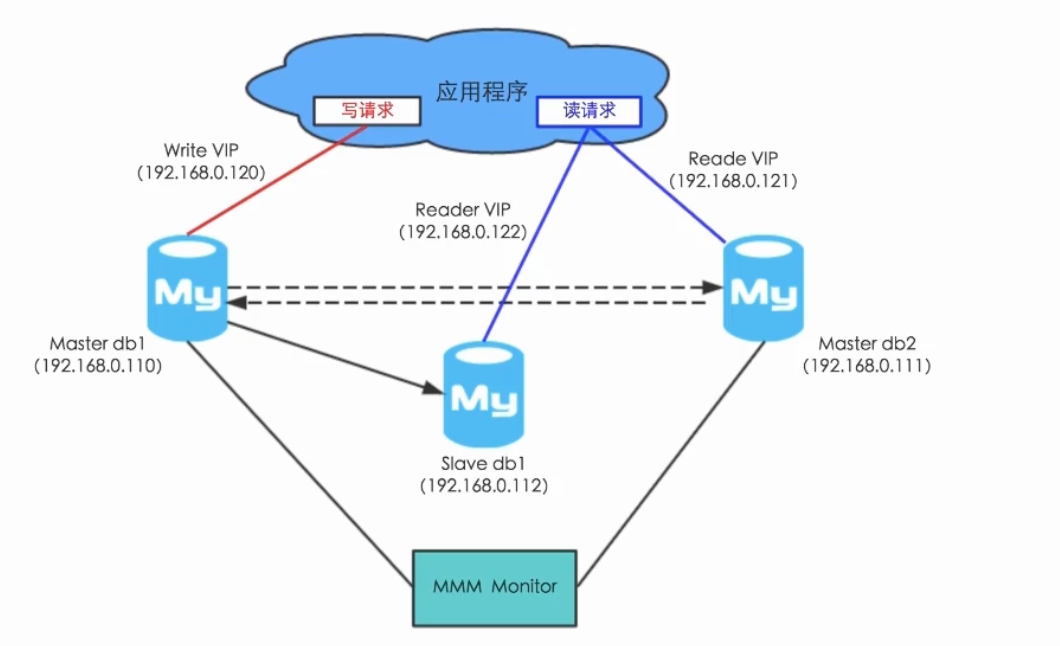
MMM 的VIP包含writer和reader两类角色,分别对应写节点和读节点。
- 当 writer节点出现故障,程序会自动移除该节点上的VIP
- 写操作切换到 Master2,并将Master2设置为writer
- 将所有Slave节点会指向Master2
除了管理双主节点,MMM 也会管理 Slave 节点,在出现宕机、复制延迟或复制错误,MMM 会移除该节点的 VIP,直到节点恢复正常。
| 优点 | 缺点 |
|---|---|
| 1.基于MySQL原生态复制 | 1.VIP无法跨网段 |
| 2.稳定成熟的开源产品 | 2.网络抖动误切导致集群双写 |
| 3.安装/部署/使用简单 | 3.MMM agent/monitor单进程,无watch dog守护 |
| 4.工具集功能强大,提供一整套HA、failover的tools | 4.MMM备选主延迟过大会导致无法切换 |
| 5.读写分离和负载均衡需要程序支持 | |
| 6.MMM不支持MySQL新特性,长时间没有更新 |
MHA架构
MHA(Master High Availability)是一套比较成熟的 MySQL 高可用方案,也是一款优秀的故障切换和主从提升的高可用软件。
MHA为了保证 Master 的高可用,通常会部署一个 Standby(备用) 角色的 Master。在 MySQL 故障切换过程中,MHA能做到在 0~30 秒内自动完成数据库的故障切换操作,并且在进行故障切换的过程中,MHA 能最大程度的保证数据的一致性,以达到真正意义上的高可用。
如下图,整个 MHA 架构分为 MHA Manager 节点和 MHA Node 节点,其中 MHA Manager 节点是单点部署,MHA Node节点是部署在每个需要监控的 MySQL 集群节点上的。MHA Manager 会定时探测集群中的 Master 节点,当 Master 出现故障时,它可以自动将最新数据的 Standby Master 或 Slave 提升为新的 Master,然后将其他的 Slave 重新指向新的Master。
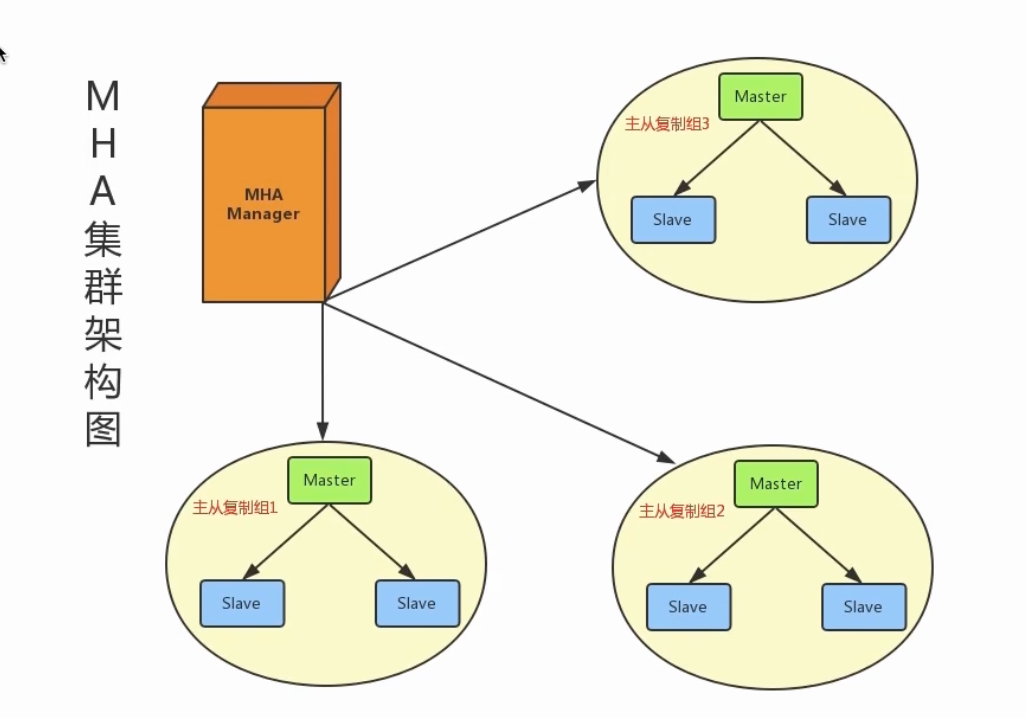
MHA由两部分组成:MHA Manager(管理节点)和MHA Node(数据节点)。
- MHA Manager可以单独部署在一台独立的机器上管理多个master-slave集群,也可以部署在一台slave节点上。负责检测master是否宕机、控制故障转移、检查MySQL复制状况等。
- MHA Node运行在每台MySQL服务器上,不管是Master角色,还是Slave角色,都称为Node,是被监控管理的对象节点,负责保存和复制master的二进制日志、识别差异的中继日志事件并将其差异的事件应用于其他的slave、清除中继日志。
MHA Manager会定时探测集群中的master节点,当master出现故障时,它可以自动将最新数据的slave提升为新的master,然后将所有其他的slave重新指向新的master,整个故障转移过程对应用程序完全透明。
MHA故障处理机制:
- 把宕机master的binlog保存下来
- 根据binlog位置点找到最新的slave
- 用最新slave的relay log修复其它slave
- 将保存下来的binlog在最新的slave上恢复
- 将最新的slave提升为master
- 将其它slave重新指向新提升的master,并开启主从复制
MHA优点:
- 自动故障转移快
- 主库崩溃不存在数据一致性问题
- 性能优秀,支持半同步复制和异步复制
- 一个Manager监控节点可以监控多个集群
MHA Manager 和 MMM Monitor 一样,都没有 watch dog 守护进程,存在单点故障的问题。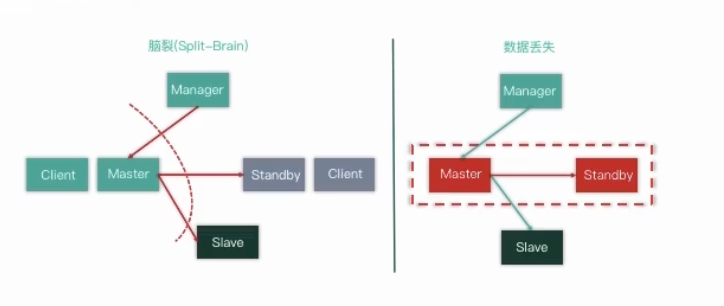
首先是集群脑裂,当一部分应用程序 Client 和 Master 形成内部网络,而 Manager、Slave、Standby及其他 Client 端组成内部网络时。首先集群的复制状态中断,两边数据不一致。其次 Manager 会认为 Master 已经 Crash,会发起故障切换,例如将 Standby Master 提升为新主库,将 Slave 自动 change master 挂载到 Standby Master 节点下形成新的数据库集群。这时候集群一分为二,出现集群脑裂的故障。
其次是数据丢失,同样当出现 Master 和 Standby(最新的 Slave)节点所处的服务器Crash 或组成内部网时,Manager 只能提升为 Slave(数据非最新,存在延迟),并为新 Master 提供服务,这就导致数据丢失。虽然 MHA 可以使用半同步复制来保证数据安全,但是半同步复制在网络抖动时同样是会存在退化为异步复制的风险。
MHA 作者承诺最大程度上保证数据的一致性,但故障切换过程中存在数据丢失的风险。
QMHA架构
下图是去哪儿网基于分布式监控哨兵构建的 QMHA 高可用集群,它是加强版的 MHA 集群。
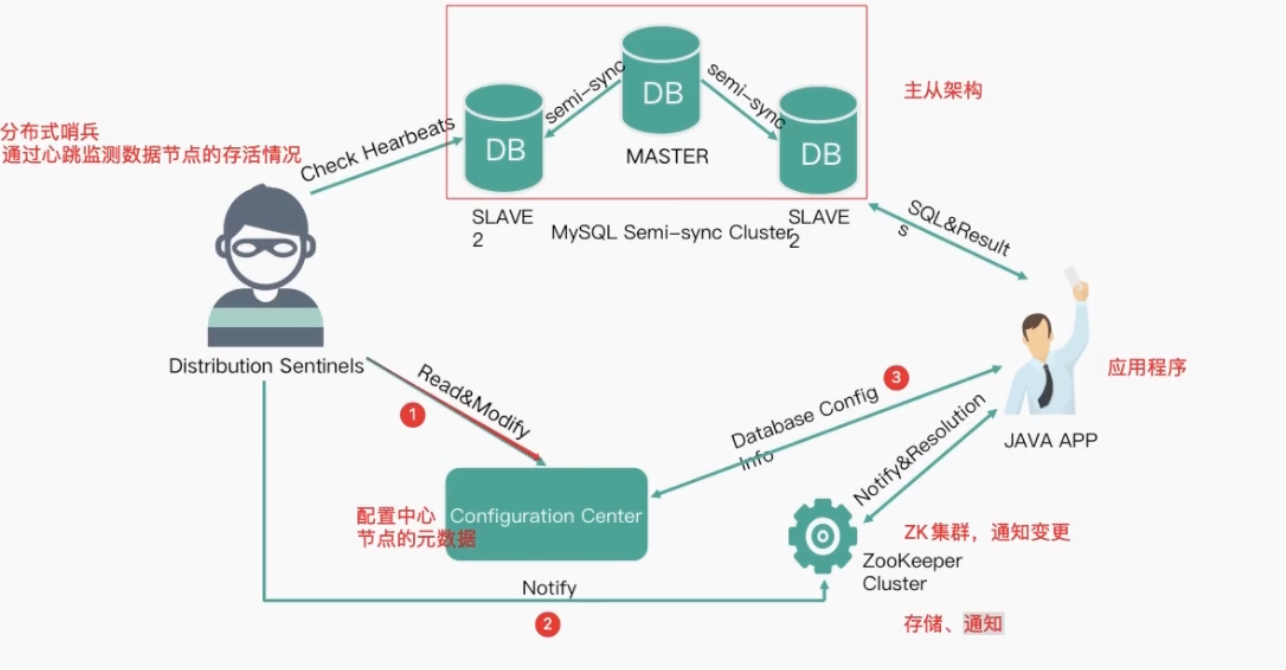
QMHA 集群能够满足数据一致性的需求,支持跨机房部署,但不支持多点写入。通过分布式哨兵选举投票来减少误切换,发起切换时会比对 GTID 来进行主从数据的快速比对,然后进行数据补齐。同时使用 Semi Sync 半同步复制提高数据安全性。
PXC/MGR
对于 MySQL,PXC 集群和 MGR 集群同样可以使用分布式监控哨兵进行集群高可用性守护
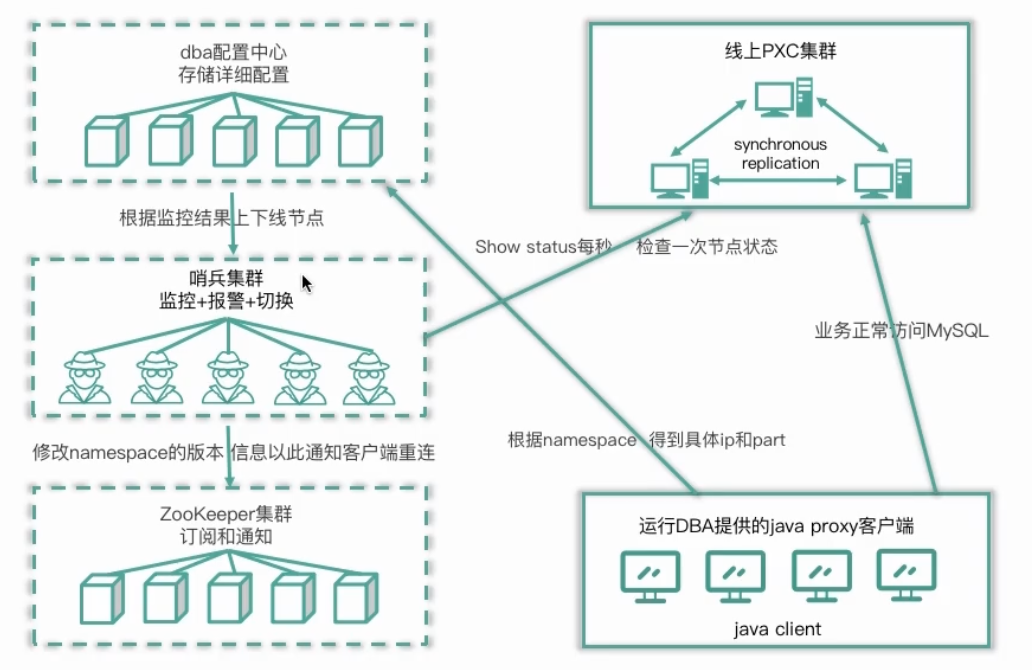
相比传统主从复制,PXC 集群和 MGR 集群支持多点写入,更完美得满足了高可用切换的需求,集群自身保证数据强一致性,不需要额外进行数据补齐操作。多点写入意味着切换时间更短,集群切换后恢复更快。