存储引擎概述
数据库存储引擎是数据库底层软件组织,数据库管理系统(DBMS)使用数据引擎进行创建、查询、更新和删除数据。不同的存储引擎提供不同的存储机制、索引技巧、锁定水平等功能,使用不同的存储引擎,还可以获得特定的功能。现在许多不同的数据库管理系统都支持多种不同的数据引擎,MySql的核心就是插件式存储引擎。
Mysql中不同的表可以指定不同的存储引擎,也就是说一套Mysql服务器可以同时使用N种不同的存储引擎。
InnoDB 事务型数据库的首选,支持事务安全表(ACID),支持行锁定和外键。
MySQL 5.5.5 之后,InnoDB 作为默认存储引擎。
1 | /** 查看系统所支持的引擎类型 */ |
| Engine | Support | Comment | Transactions | XA | Savepoints |
|---|---|---|---|---|---|
| FEDERATED | NO | Federated MySQL storage engine | [NULL] | [NULL] | [NULL] |
| MEMORY | YES | Hash based, stored in memory, useful for temporary | NO | NO | NO |
| InnoDB | DEFAULT | Supports transactions, row-level locking, and foreig | YES | YES | YES |
| PERFORMANCE_SCHEMA | YES | Performance Schema | NO | NO | NO |
| MyISAM | YES | MyISAM storage engine | NO | NO | NO |
| MRG_MYISAM | YES | Collection of identical MyISAM tables | NO | NO | NO |
| BLACKHOLE | YES | /dev/null storage engine (anything you write to it dis | NO | NO | NO |
| CSV | YES | CSV storage engine | NO | NO | NO |
| ARCHIVE | YES | Archive storage engine | NO | NO | NO |
不同的存储引擎都有各自的特点,以适应不同的需求,如表所示。为了做出选择,首先要考虑每一个存储引擎提供了哪些不同的功能。
| 特点 | Myisam | BDB | Memory | InnoDB | Archive |
|---|---|---|---|---|---|
| 存储限制 | 没有 | 没有 | 有 | 64TB | 没有 |
| 事务安全 | 支持 | 支持 | |||
| 锁机制 | 表锁 | 页锁 | 表锁 | 行锁 | 行锁 |
| B树索引 | 支持 | 支持 | 支持 | 支持 | |
| 哈希索引 | 支持 | 支持 | |||
| 全文索引 | 支持 | ||||
| 集群索引 | 支持 | ||||
| 数据缓存 | 支持 | 支持 | |||
| 索引缓存 | 支持 | 支持 | 支持 | ||
| 数据可压缩 | 支持 | 支持 | |||
| 空间使用 | 低 | 低 | N/A | 高 | 非常低 |
| 内存使用 | 低 | 低 | 中等 | 高 | 低 |
| 批量插入的速度 | 高 | 高 | 高 | 低 | 非常高 |
| 支持外键 | 支持 |
MyISAM:默认的MySQL插件式存储引擎,它是在Web、数据仓储和其他应用环境下最常使用的存储引擎之一
InnoDB:用于事务处理应用程序,具有众多特性,包括ACID事务支持。
Memory:将所有数据保存在RAM中,在需要快速查找引用和其他类似数据的环境下,可提供极快的访问。
使用下面的语句可以修改数据库临时的默认存储引擎
1 | SET default_storage_engine='存储引擎名' |
InnoDB
简介
InnoDB是一款通用存储引擎,平衡了高可靠性和高性能。
- 高可靠性:任何时候可以保证数据是不丢失的
- 高性能:数据读取(查询、检索)和数据变更效率高、RT短(Response Time,服务响应时间)
- 通常性能和可靠性是相悖的,磁盘的效率是远远低于内存的。
MySQL 8.0中,InnoDB是默认的MySQL存储引擎。除非配置了不同的默认存储引擎,否则在没有ENGINE子句的情况下发布CREATE TABLE语句会创建InnoDB表。
主要优势:
- 其DML操作遵循ACID模型(事务模型),其事务具有提交、回滚和崩溃恢复功能(InnoDB redo、undo日志),以保护用户数据。
- 行级锁定和甲骨文风格的一致读取提高了多用户并发性和性能。
- InnoDB表在磁盘上排列数据,以根据主键优化查询。每个InnoDB表都有一个名为聚类索引的主键索引,该索引组织数据以最小化主键查找的I/O。
- 为了保持数据完整性,InnoDB支持FOREIGN KEY约束。使用外键,会检查插入、更新和删除,以确保它们不会导致相关表之间的不一致。
架构
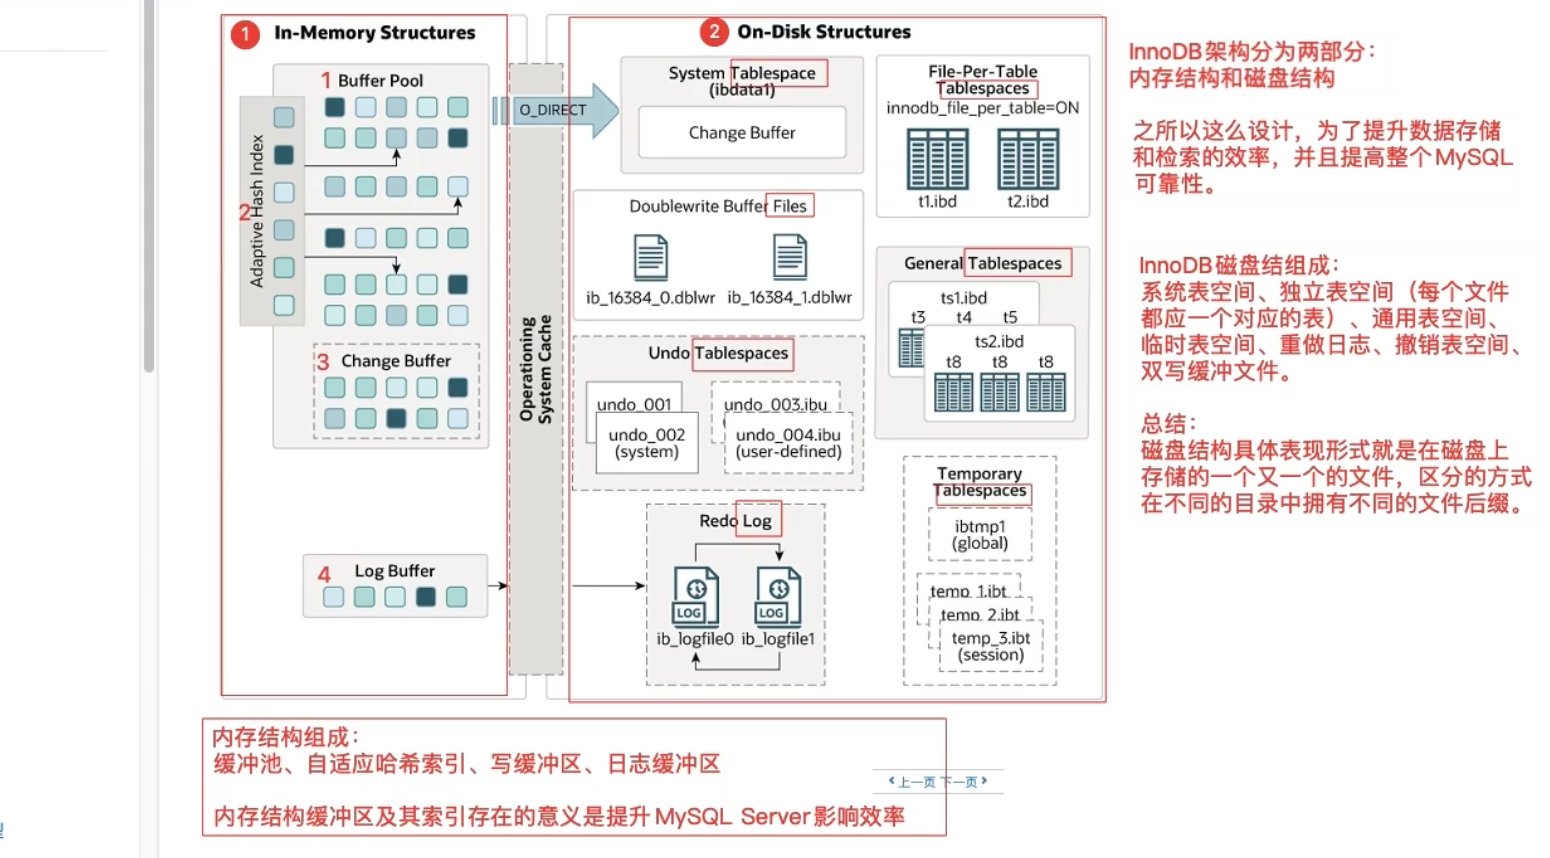
内存
buffer pool
Buffer Pool,中文名:缓冲池。
在使用MySQL进行查询时,具体查询数据其实是在存储引擎中实现的,MySQL数据是存储于磁盘里,如果每次查询都直接从磁盘里面查询,这样势必会很影响性能(从磁盘进行数据的检索/提取效率是最低的,最佳方式是从内存中提取),所以一定是先把数据从磁盘中取出,然后放在内存中,下次查询直接从内存中去查询。
缓冲池与查询缓存的对比:
查询缓存:在服务层,存储的数据是查询的结果集。
缓冲池:在存储引擎层,缓冲的数据其实是磁盘上的数据信息,就可以在缓冲池进行数据的查询。将磁盘中的部分热点数据页都给放入到内存某一个区域中(缓冲池),从内存中进行检索,所以使用缓冲池可以大大提升查询效率。
Buffer Pool是MySQL或者说InnoDB中,十分重要、非常核心的一部分,位于主内存。
缓冲池是主内存中的一个区域,InnoDB在访问时缓存表和索引数据。缓冲池允许直接从内存访问常用数据,从而加快处理速度。在专用服务器上,高达80%的物理内存通常分配给缓冲池(官方建议)。
缓冲池不可能缓存所有的数据,如果缓冲池中没有要检索的数据也怎么办?缓冲池是有大小限制的,满了怎么办?
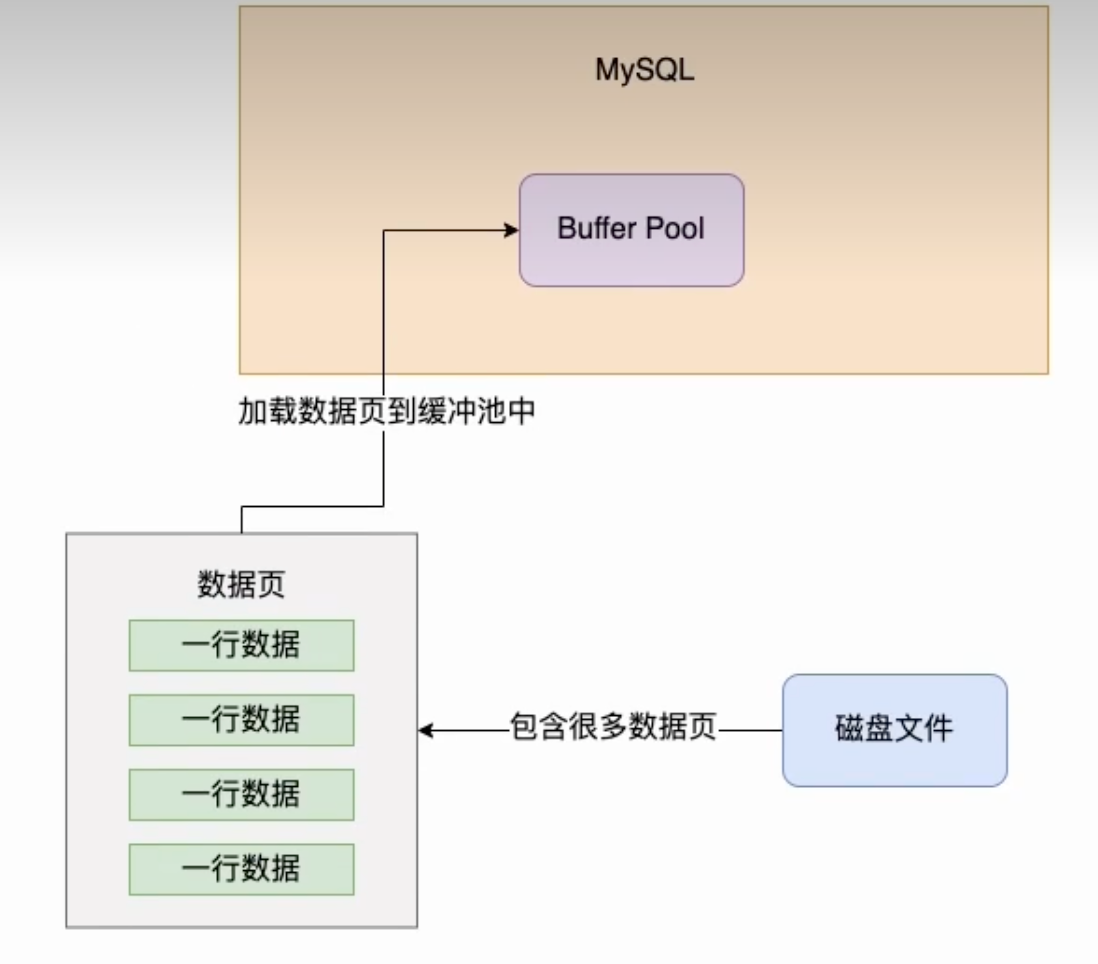
- 会将要检索数据对应的数据页都给加载到缓冲池中
- 缓冲池针对LRU算法进行了优化,淘汰算法
在Inno DB中,数据的访问是按照数据页(默认情况下,数据页的大小是 16kb)的方式从数据文件中读取到 Buffer Pool 中,所以对应的,在 Buffer Pool 中,也是以数据页为数据单位,存放着很多数据。但是我们通常叫做缓存页。
磁盘中的数据也在内存中用同样大小的内存空间做一个映射。为了提高访问速度MySQL 预先就分配许多这样的空间,为的就是与MySQL数据文件中的页做交换,来把数据文件中的页放到事先准备好的内存中。
怎么识别数据在哪个缓存页中
每个缓存页都会对应着一个描述数据块,里面包含数据页所属的表空间、数据页的编号,缓存页在 Buffer Pool 中的地址等等。
描述数据块本身也是一块数据,它的大小大概是缓存页大小的5%左右,大概800个字节左右的大小。假设你设置的buffer pool大小是128MB,实际上Buffer Pool真正的最终大小会超出一些,可能有个130多MB的样子,因为还要存放每个缓存页的描述数据。
在Buffer Pool中,每个缓存页的描述数据放在最前面,然后各个缓存页放在后面。
InnoDB会维护一个哈希表数据结构,它使用表空间号+数据页号,作为一个key,然后缓冲页对应的控制块作为value。
(表格:数据页缓存的Hash表)
| KEY | VALUE |
|---|---|
| 表空间号+数据页号 | 对应描述控制块 |
| 表空间号+数据页号 | 对应描述控制块 |
| …… | …… |
- 当需要访问某个页的数据时,先从哈希表中根据表空间号+页号看看是否存在对应的缓冲页。
- 如果有,则直接使用;如果没有,就从free链表中选出一个空闲的缓冲页,然后把磁盘中对应的页加载到该缓冲页的位置
InnoDB使用了链表来组织页和页中存储的数据,页与页之间形成了双向链表,这样可以方便的从当前页跳到下一页,同时使用LRU(Least Recently Used)算法去淘汰那些不经常使用的数据。
(注释:内存空间不连续,但是每个节点都是指向下一个节点和上一个节点)
(图示:页与页之间通过双向链表连接,页内部有上一页指针、下一页指针,以及User Records)
+-----------------------------+          +-----------------------------+
|             页              |          |             页              |
|                             |          |                             |
|  +-----------+-----------+  |          |  +-----------+-----------+  |
|  | 上一页指针 | 下一页指针 |  | -------> |  | 上一页指针 | 下一页指针 |  |
|  +-----------+-----------+  | <------- |  +-----------+-----------+  |
|                             |          |                             |
|  +-----------------------+  |          |  +-----------------------+  |
|  |                       |  |          |  |                       |  |
|  |      User Records     |  |          |  |      User Records     |  |
|  |                       |  |          |  |                       |  |
|  +-----------------------+  |          |  +-----------------------+  |
|                             |          |                             |
+-----------------------------+          +-----------------------------+
同时,每页中的一行行数据是通过单向链表进行链接。因为这些数据是分散到Buffer Pool中的,单向链表将这些分散的内存给连接了起来。
(图示:页内部的User Records通过单向链表连接1 -> 2 -> 3)
+-----------------------------+
|             页              |
|                             |
|  +-----------+-----------+  |
|  | 上一页指针 | 下一页指针 |  |
|  +-----------+-----------+  |
|                             |
|  +-----------------------+  |
|  |      User Records     |  |
|  |                       |  |
|  |   +-----------+       |  |
|  |   |     1     |       |  |
|  |   +-----------+       |  |
|  |         |             |  |
|  |         v             |  |
|  |   +-----------+       |  |
|  |   |     2     |       |  |
|  |   +-----------+       |  |
|  |         |             |  |
|  |         v             |  |
|  |   +-----------+       |  |
|  |   |     3     |       |  |
|  |   +-----------+       |  |
|  |         |             |  |
|  |         v             |  |
|  |   +-----------+       |  |
|  |   |    ...    |       |  |
|  |   +-----------+       |  |
|  +-----------------------+  |
|                             |
+-----------------------------+
那 InnoDB 为什么要这么设计?
假设我们没有页这个概念,那么当我们查询时,成千上万的数据要如何做到快速的查询出结果?
众所周知,MySQL 的性能是不错的,而如果没有页,我们剩下的只能是逐条逐条的遍历数据了。
那页是如何做到快速查询的呢?
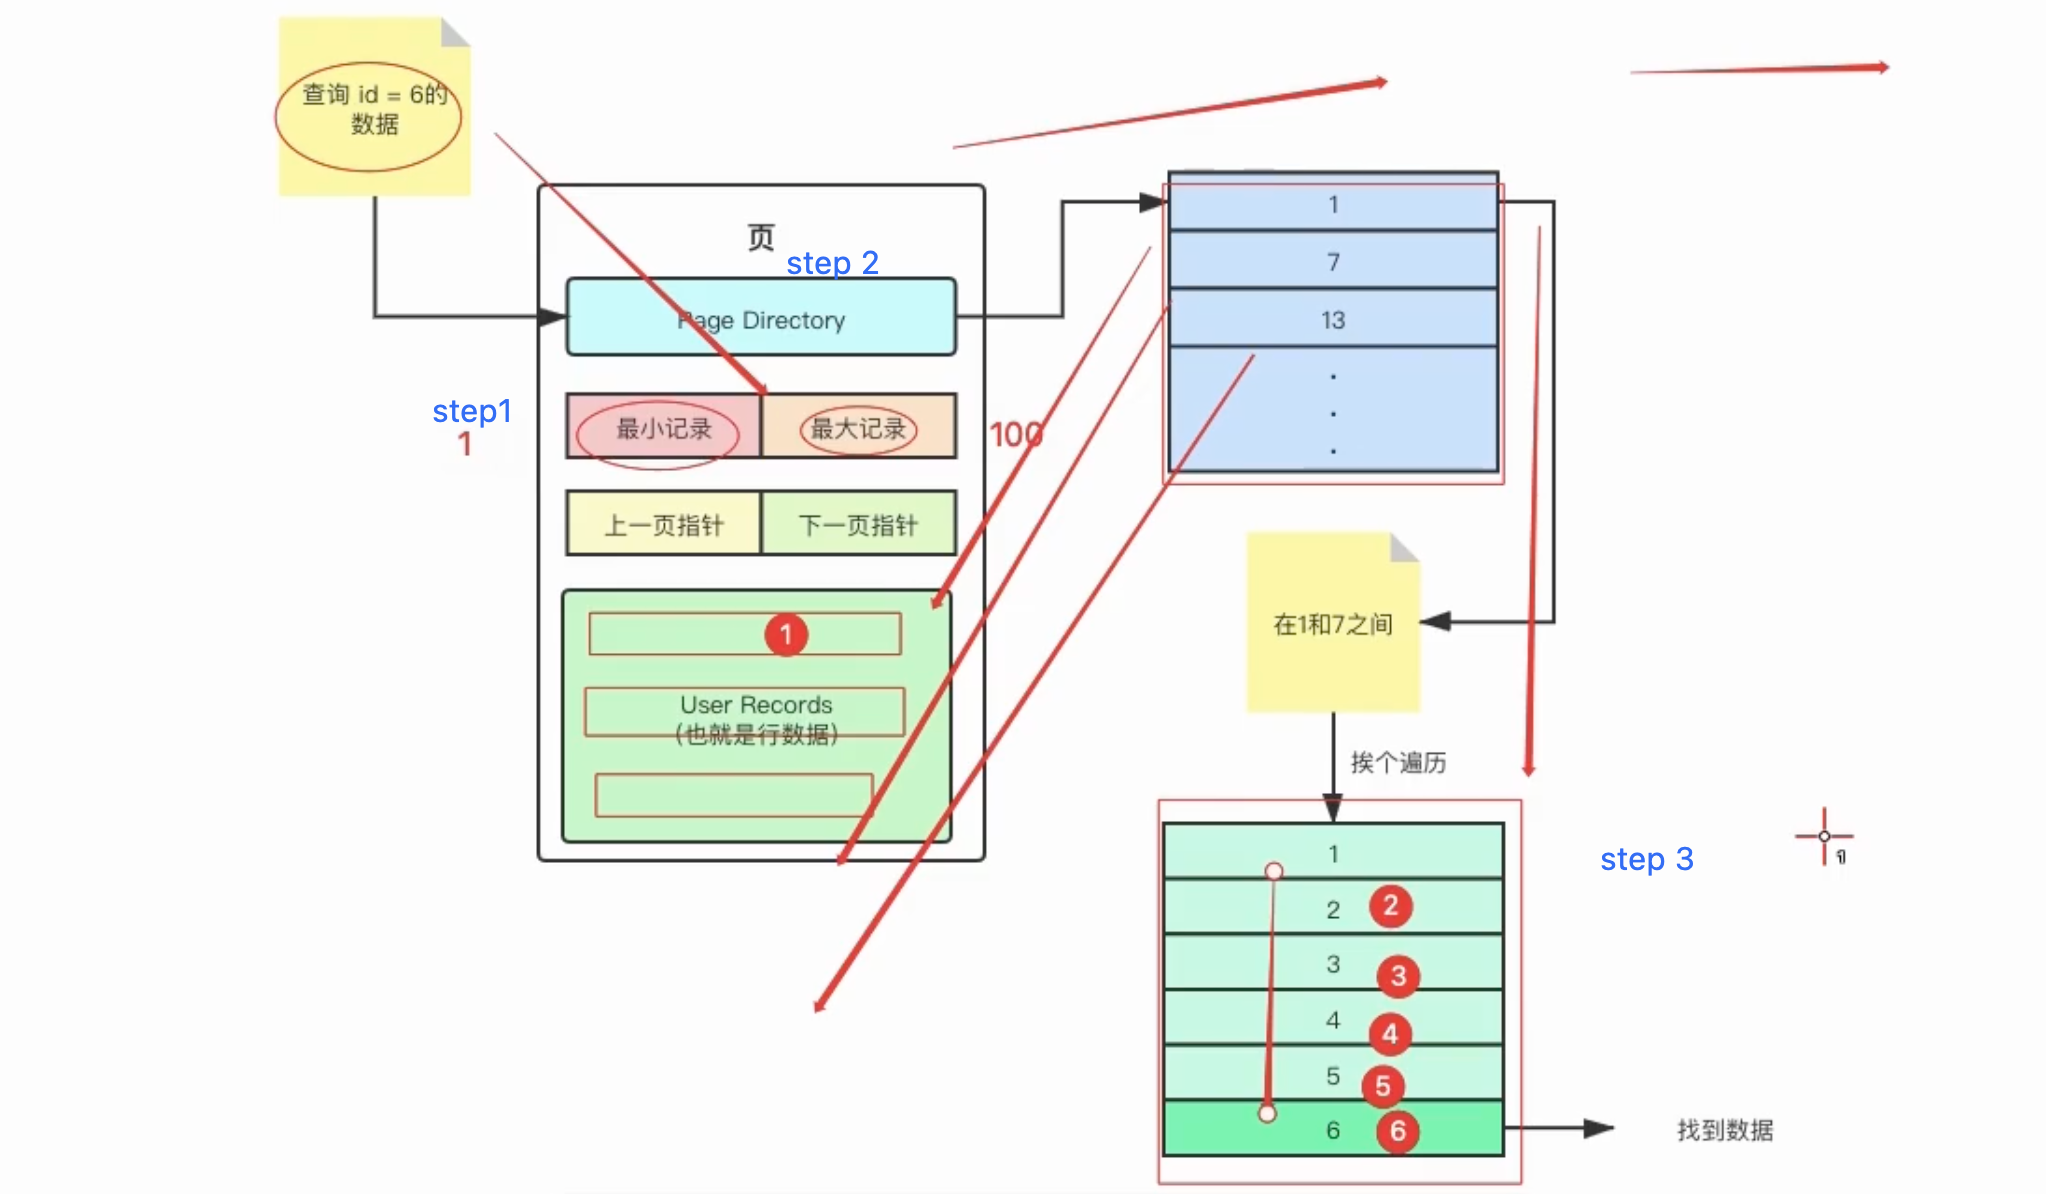
在当前页中,可以通过 User Records 中的连接每条记录的单链表来进行遍历,如果在当前页中没有找到,则可以通过下一页指针快速的跳到下一页进行查询。
有人可能会说了,你在 User Records 中还不是通过遍历来解决的,你就是简单的把数据分了个组而已。如果我的数据根本不在当前这个页中,那我难道还是得把之前的页中的每一条数据全部遍历完?这效率也太低了。
当然,MySQL 也考虑到了这个问题,所以实际上在页中还存在一块区域叫做 The Infimum and Supremum Records,代表了当前页中最大和最小的记录(在一个页中所有的记录默认都是连续的,比如1-100)。
(图示 1)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 +-------+ +--------+
| 1 | | 100 |
+-------+ +--------+
^ ^
| |
+---------------------------------------------------------+
| 页 |
| +-------------+ +-------------+ |
| | 最小记录 | | 最大记录 | |
| +-------------+ +-------------+ |
| |
| +-------------+ +-------------+ |
| | 上一页指针 | | 下一页指针 | |
| +-------------+ +-------------+ |
| |
| +---------------------------------------------------+ |
| | | |
| | User Records | |
| | (也就是行数据) | |
| | | |
| +---------------------------------------------------+ |
| |
+---------------------------------------------------------+
有了 Infimum Record 和 Supremum Record,现在查询不需要将某一页的 User Records 全部遍历完,只需要将这两个记录和待查询的目标记录进行比较。比如我要查询的数据 id = 101,那很明显不在当前页。接下来就可以通过下一页指针跳到下页进行检索。
使用Page Directory(Page目录):
问题: User Records 中是单链表,那么即使我知道我要找的数据在当前页,那最坏的情况下,也得挨个挨个的遍历100次才能找到想要的数据。你管这也叫效率高?
答案:为了解决这个问题,MySQL 又在页中加入了另一个区域 Page Directory 。
(图示 2)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28+-----------------------+
| 假设存储了 |
| 1-100的数据 |
+-----------------------+
+---------------------------+ +----------------+
| 页 | | 1 |
| | +----------------+
| +---------------------+ | | 7 |
| | Page Directory |--|--------->+----------------+
| +---------------------+ | | 13 |
| | +----------------+
| +---------+ +---------+ | | . |
| | 最小记录| | 最大记录| | | . |
| +---------+ +---------+ | | . |
| | +----------------+
| +---------+ +---------+ |
| |上一页指针| |下一页指针| |
| +---------+ +---------+ |
| |
| +---------------------+ |
| | | |
| | User Records | |
| | (也就是行数据) | |
| | | |
| +---------------------+ |
| |
+---------------------------+
顾名思义,Page Directory 是个目录,里面有很多个槽位(Slots),每一个槽位都指向了一条 User Records 中的记录。大家可以看到,每隔几条数据,就会创建一个槽位。图中给出的数据是非常严格按照其设定来的,在一个完整的页中,每隔6条数据就会有一个 Slot。
Page Directory 的设计不知道有没有让你想起另一个数据结构——跳表,只不过这里只抽象了一层索引。
MySQL 会在新增数据的时候就将对应的 Slot 创建好,有了 Page Directory ,就可以对一张页的数据进行粗略的二分查找。至于为什么是粗略,毕竟 Page Directory 中不是完整的数据,二分查找出来的结果只能是个大概的位置,找到了这个大概的位置之后,还需要回到 User Records 中继续的进行挨个遍历匹配。
查找过程
淘汰策略(算法)- LRU
- LRU:Least Recently Userd,最近最少使用
- FIFO:先进先出置换算法
- LFU:最少使用置换算法,移位寄存器(用来记录页被访问的频率)
- OPT:最佳置换算法
Buffer Pool的LRU算法是如何实现将最近没有使用过的数据给过期的。
传统的LRU:
核心思想:末尾淘汰法,新数据从链表头部加入,释放空间时从末尾淘汰。
① 页已经在缓冲池里:那就只做移至LRU头部的动作,而没有页被淘汰
(图示1)1
2
3
4 head tail
| |
v v
[ LRU ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 4 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] -> [ 20 ] -> [ 40 ] -> [ 7 ]
假如管理缓冲池的LRU长度为10,缓冲了页号为1,3,5…,40,7的页。
假如,接下来要访问的数据在页号为4的页中:
(图示2)1
2
3
4 head tail
| |
v v
[ LRU ] -> [ 4 ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] -> [ 20 ] -> [ 40 ] -> [ 7 ]
- 页号为4的页,本来就在缓冲池里。
- 把页号为4的页,放到LRU的头部即可,没有页被淘汰。
② 页不在缓冲池里:除了做放入LRU头部的动作,还要做淘汰LRU尾部页的动作。
假如,再接下来要访问的数据在页号为50的页中:
(图示3)1
2
3
4 head tail
| |
v v
[ LRU ] -> [ 50 ] -> [ 4 ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] -> [ 20 ] -> [ 40 ] -> [ 7 ]
- 页号为50的页,原来不在缓冲池里;
- 把页号为50的页,放到LRU头部,同时淘汰尾部页号为7的页;
传统LRU对于MySQL的劣势:
预读失效
由于预读(Read-Ahead),提前把页放入了缓冲池,但最终MySQL并没有从页中读取数据,称为预读失效。
- 什么是预读
磁盘读写,并不是按需读取,而是按页读取,一次至少读一页数据(16K),如果未来要读取的数据就在页中,就能够省去后续的磁盘IO,提高效率。 - 为什么预读
数据访问,通常都遵循“集中读写”的原则,使用一些数据,大概率会使用附近的数据,这就是所谓的“局部性原理”,它表明提前加载是有效的,确实能够减少磁盘IO。 - 按页读取,和InnoDB的缓冲池设计有啥关系?
磁盘访问按页读取能够提高性能,所以缓冲池一般也是按页缓存数据。
预读机制启示了我们,能把一些“可能要访问”的页提前加入缓冲池,避免未来的磁盘IO操作。
MySQL缓冲池污染
为什么呢?
因为实际生产环境中会存在全表扫描的情况(大部分时候我们希望不做全表扫描的,依赖索引),如果数据量较大,可能会将Buffer Pool中存下来的热点数据给全部替换出去,而这样就会导致该段时间MySQL性能断崖式下跌。
对于这种情况,MySQL有一个专用名词叫缓冲池污染。所以MySQL对LRU算法做了优化。
预读失效优化
Buffer Pool预读机制:
预读是mysql提高性能的一个重要的特性。预读就是 IO 异步读取多个页数据读入 Buffer Pool 的一个过程,并且这些页被认为很快就会被读取到的。InnoDB使用两种预读算法来提高I/O性能:线性预读(Linear Read-Ahead)和随机预读(Random Read-Ahead)
为了区分这两种预读的方式,我们可以把线性预读放到以extent为单位,而随机预读放到以extent中的page为单位。线性预读着眼于将下一个extent提前读取到buffer pool中,而随机预读着眼于将当前extent中的剩余的page提前读取到buffer pool中。
(1)Linear线性预读
线性预读的单位是extend,一个extend中有64个page。线性预读的一个重要参数是innodb_read_ahead_threshold,是指在连续访问多少个页面之后,把下一个extend读入到buffer pool中,不过预读是一个异步的操作。当然这个参数不能超过64,因为一个extend最多只有64个页面。
MySQL InnoDB逻辑存储结构:
所有数据都会被逻辑地存储在空间中,成为表空间。表空间对应的物理结构就一个在磁盘上一个个的文件,日志、数据等等。
表空间的逻辑组成:段(Segment)、区(extent)、页(Page)组成。页也有称为块(Block)。
表空间是有各个段组成,常见段有数据段、索引段、回滚段。
区是由连续的页组成的,在任何情况下每个区的大小都是1MB,为了保证页连续性,InnoDB每次从磁盘上一次申请4-5区。页大小16K,一个区有多少个页? (1MB/16K = 64)
例如,innodb_read_ahead_threshold = 56,就是指在连续访问了一个extend的56个页面之后把下一个extend读入到buffer pool中。在添加此参数之前,InnoDB仅计算当它在当前范围的最后一页中读取时是否为整个下一个范围发出异步预取请求。
1 | show variables like '%innodb_read_ahead_threshold%'; |
(2)Random随机预读
随机预读方式则是表示当同一个extent中的一些page在buffer pool中发现时,Innodb会将该extent中的剩余page一并读到buffer pool中。由于随机预读方式给innodb code带来了一些不必要的复杂性,同时在性能也存在不稳定性,在5.5中已经将这种预读方式废弃,默认是OFF。若要启用此功能,即将配置变量设置innodb_random_read_ahead为ON(不建议启用)。
1 | SET GLOBAL innodb_random_read_ahead='ON'; |
LRU具体结构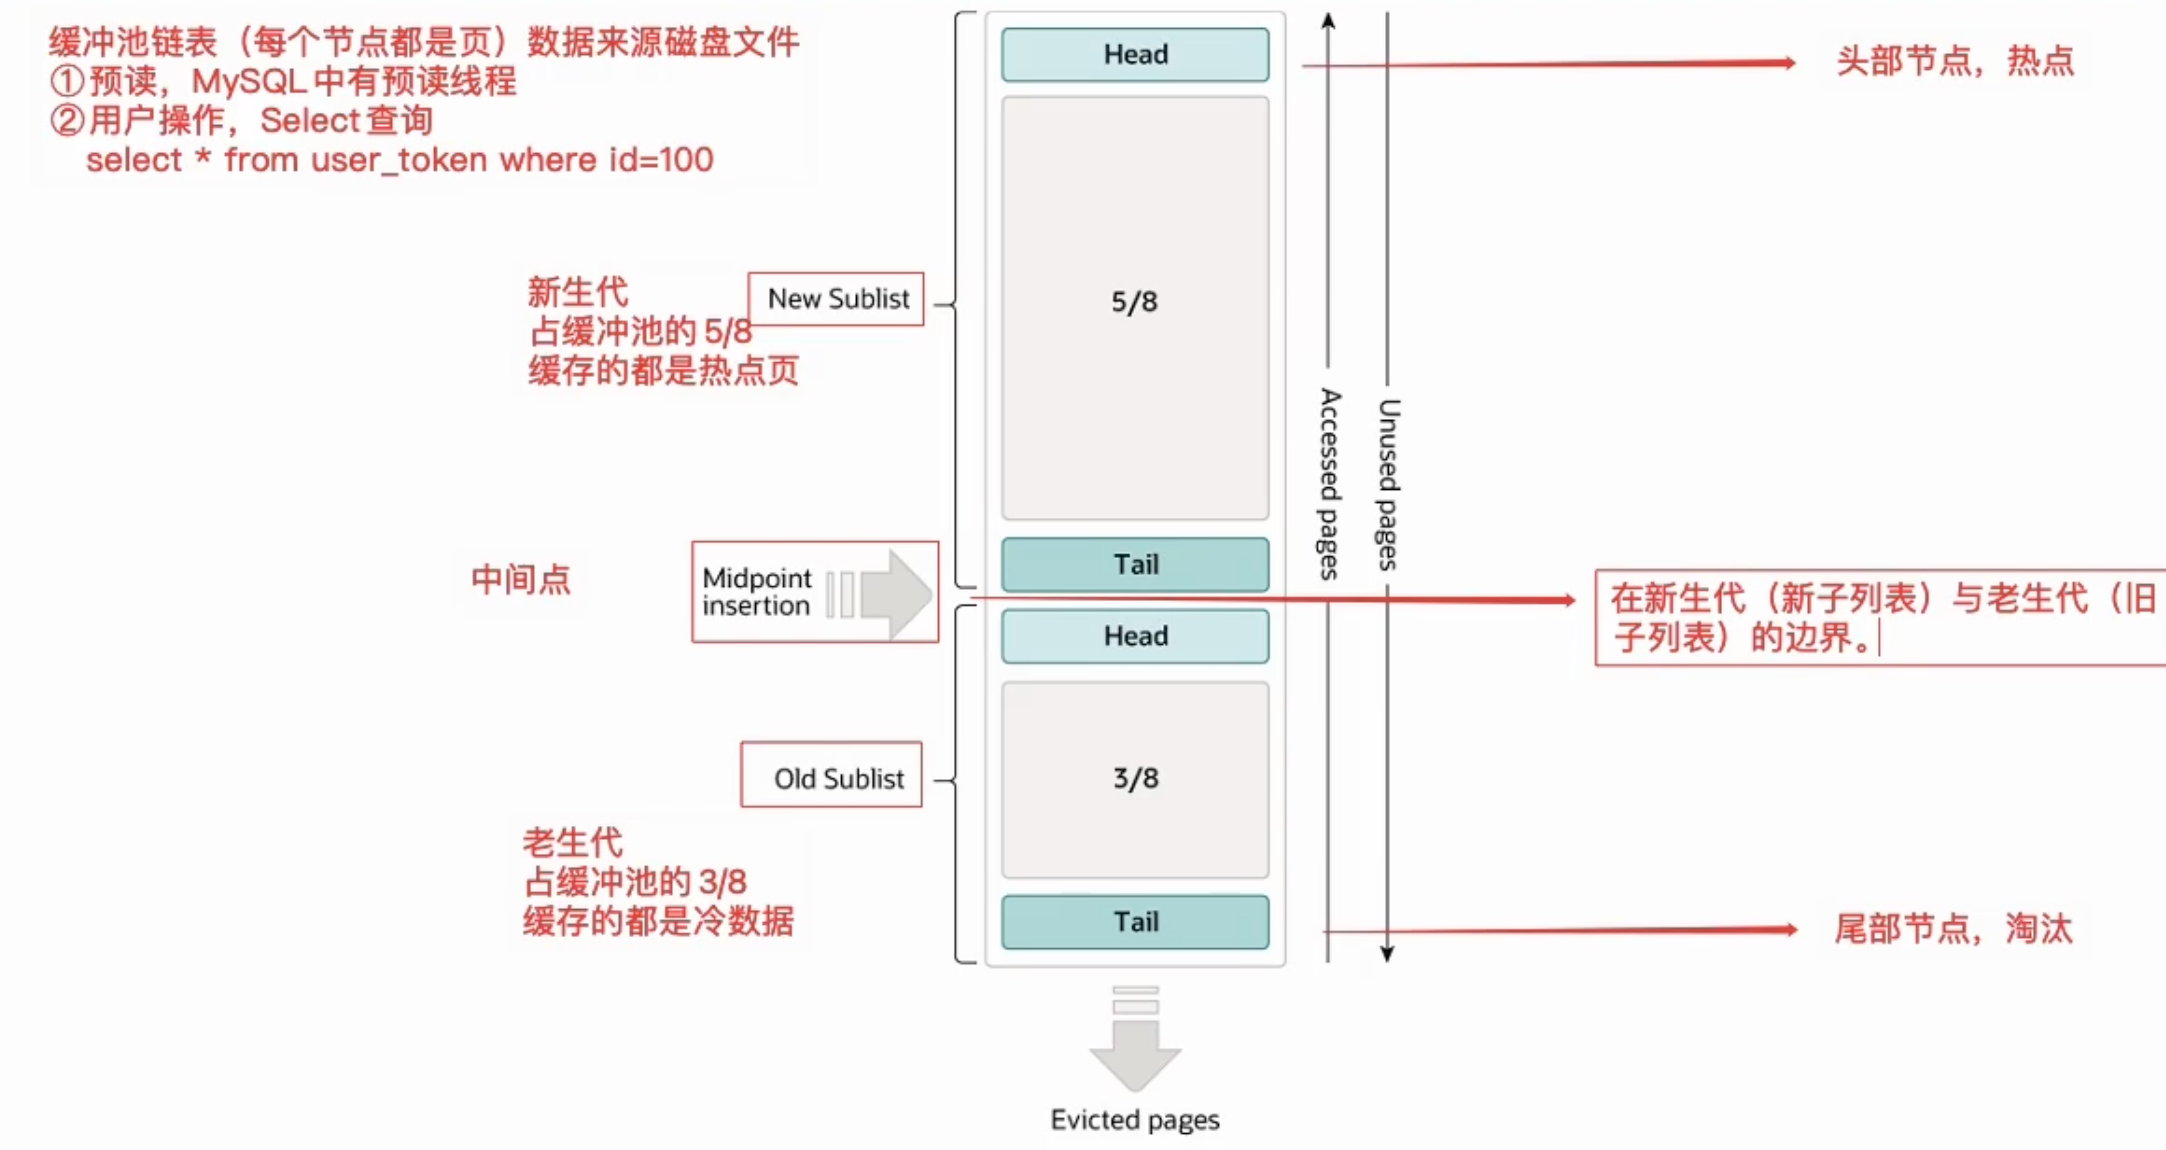
该算法将常用的Page页面保留在新生代(New Sublist)中。老生代(Old Sublist)包含较少使用的Page页面;Old Sublist中的Page页面,会在后续Buffer Pool剩余空间不足、或者有新的页加入时被移除掉。
该链表存储的数据来源有两部分,分别是:
- MySQL的预读线程预先加载的数据。
- 用户的操作,例如Query查询。
预读失效的处理:
要优化预读失效,思路是:
(1)让预读失败的页(通过预读加载到缓冲池的数据页没有被检索),停留在缓冲池LRU里的时间尽可能短。
(2)让真正被读取的页,才挪到缓冲池LRU的头部(新生代的头部New SubList的头部)
默认情况下,由用户操作影响而进入到Buffer Pool中的数据,会被立即放到链表的最前端(New SubList),也就是New Sublist 的 Head 部分。
如果是MySQL启动时预加载或者预读的数据,则会放入MidPoint中,如果这部分数据被用户访问过之后,才会放到链表的最前端,如果没有被访问过,就会被移动到后3/8的 Old Sublist中去,直到被清理掉。
解决流程
① 预读的数据或者MySQL启动时加载的数据,不放入New SubList的头部,而是放入到MidPoint中,如果被用户访问到了才放入New SubList的头部,如果没有被访问到,放入到Old SubList中
② 用户查询加载的数据页(一定会被立刻访问的),直接放入到New SubList的头部(热点数据)。
③ 随着时间的推移,New SubList中冷数据会逐渐放入到OldSubList中,如果Old Sublist中的数据被用户访问了,这次会立刻放入到New SubList的头部
污染优化
缓冲池污染处理:
MySQL缓冲池加入了一个【老生代停留时间窗口】的机制:
(1)假设 T 代表老生代停留时间窗口;
(2)插入老生代头部的页,即使立刻被访问,并不会立刻放入新生代头部;
(3)只有满足【被访问】并且【在老生代停留时间 > T】,才会被放入新生代头部;
假设批量数据扫描,有51,52,53,54,55等五个页面将要依次被访问:
(图示1)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 head new-sublist tail
| |
v v
[ LRU ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 4 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] -> [ 20 ] -> [ 40 ] -> [ 7 ]
^ ^
| |
head tail
old-sublist
^
|
[ 51 ] <-- 大批量扫描,即将[依次]被访问的页
[ 52 ]
[ 53 ]
[ 54 ]
[ 55 ]
如果没有“老生代停留时间窗口”的策略,这些批量被访问的页面,会换出大量热数据:
(图示2)1
2
3
4
5
6
7
8
9 head new-sublist tail
| |
v v
[ LRU ] -> [ 55 ] -> [ 54 ] -> [ 53 ] -> [ 52 ] -> [ 51 ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 4 ] -> [ 2 ] ( 10 ) ( 30 ) [ 20 ] -> [ 40 ] -> [ 7 ]
批量扫码会导致大量热数据被换出
^ ^
| |
head tail
old-sublist
加入“老生代停留时间窗口”策略后,短时间内被大量加载的页,并不会立刻插入新生代头部,而是优先淘汰那些,短期内仅仅访问了一次的页:
(图示3)1
2
3
4
5
6
7
8
9
10 head new-sublist tail
| |
v v
[ LRU ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 4 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] -> [ 55 ] -> [ 54 ] -> [ 53 ] [ 52 ] [ 51 ] [ 20 ] -> [ 40 ] -> [ 7 ]
批量扫描,页面即使被访问,依然被淘汰
^ ^
| |
head tail
old-sublist
即使都被立刻访问,也没有立刻移动到新生代头部(整个LRU头部)
而只有在老生代呆的时间足够久,停留时间大于T,才会被插入新生代头部:
(图示4)1
2
3
4
5
6
7
8
9 head new-sublist tail
| |
v v
[ LRU ] -> [ 55 ] -> [ 54 ] -> [ 53 ] -> [ 1 ] -> [ 3 ] -> [ 5 ] -> [ 4 ] -> [ 2 ] -> [ 10 ] -> [ 30 ] [ 52 ] [ 51 ] [ 20 ] -> [ 40 ] -> [ 7 ]
^ ^
| |
head tail
old-sublist
在老生代停留时间>T,才会移动到新生代
相关参数优化
参数:innodb_buffer_pool_size
介绍:配置缓冲池的大小,在内存允许的情况下,DBA往往会建议调大这个参数,越多数据和索引放到内存里,数据库的性能会越好。【建议70% -80% ,监控sql执行效率,然后再设置最合适的值】
参数:innodb_old_blocks_pct
介绍:老生代占整个LRU链长度的比例,默认是37,即整个LRU中新生代与老生代长度比例是63:37。若把这个参数设为100,就退化为普通LRU了。【建议用默认值】
参数:innodb_old_blocks_time
介绍:老生代停留时间窗口,单位是毫秒,默认是1000,即同时满足“被访问”与“在老生代停留时间超过1秒”两个条件,才会被插入到新生代头部。【建议用默认值】
修改配置:
1 | SET GLOBAL innodb_buffer_pool_size=402653184; |
页和链表
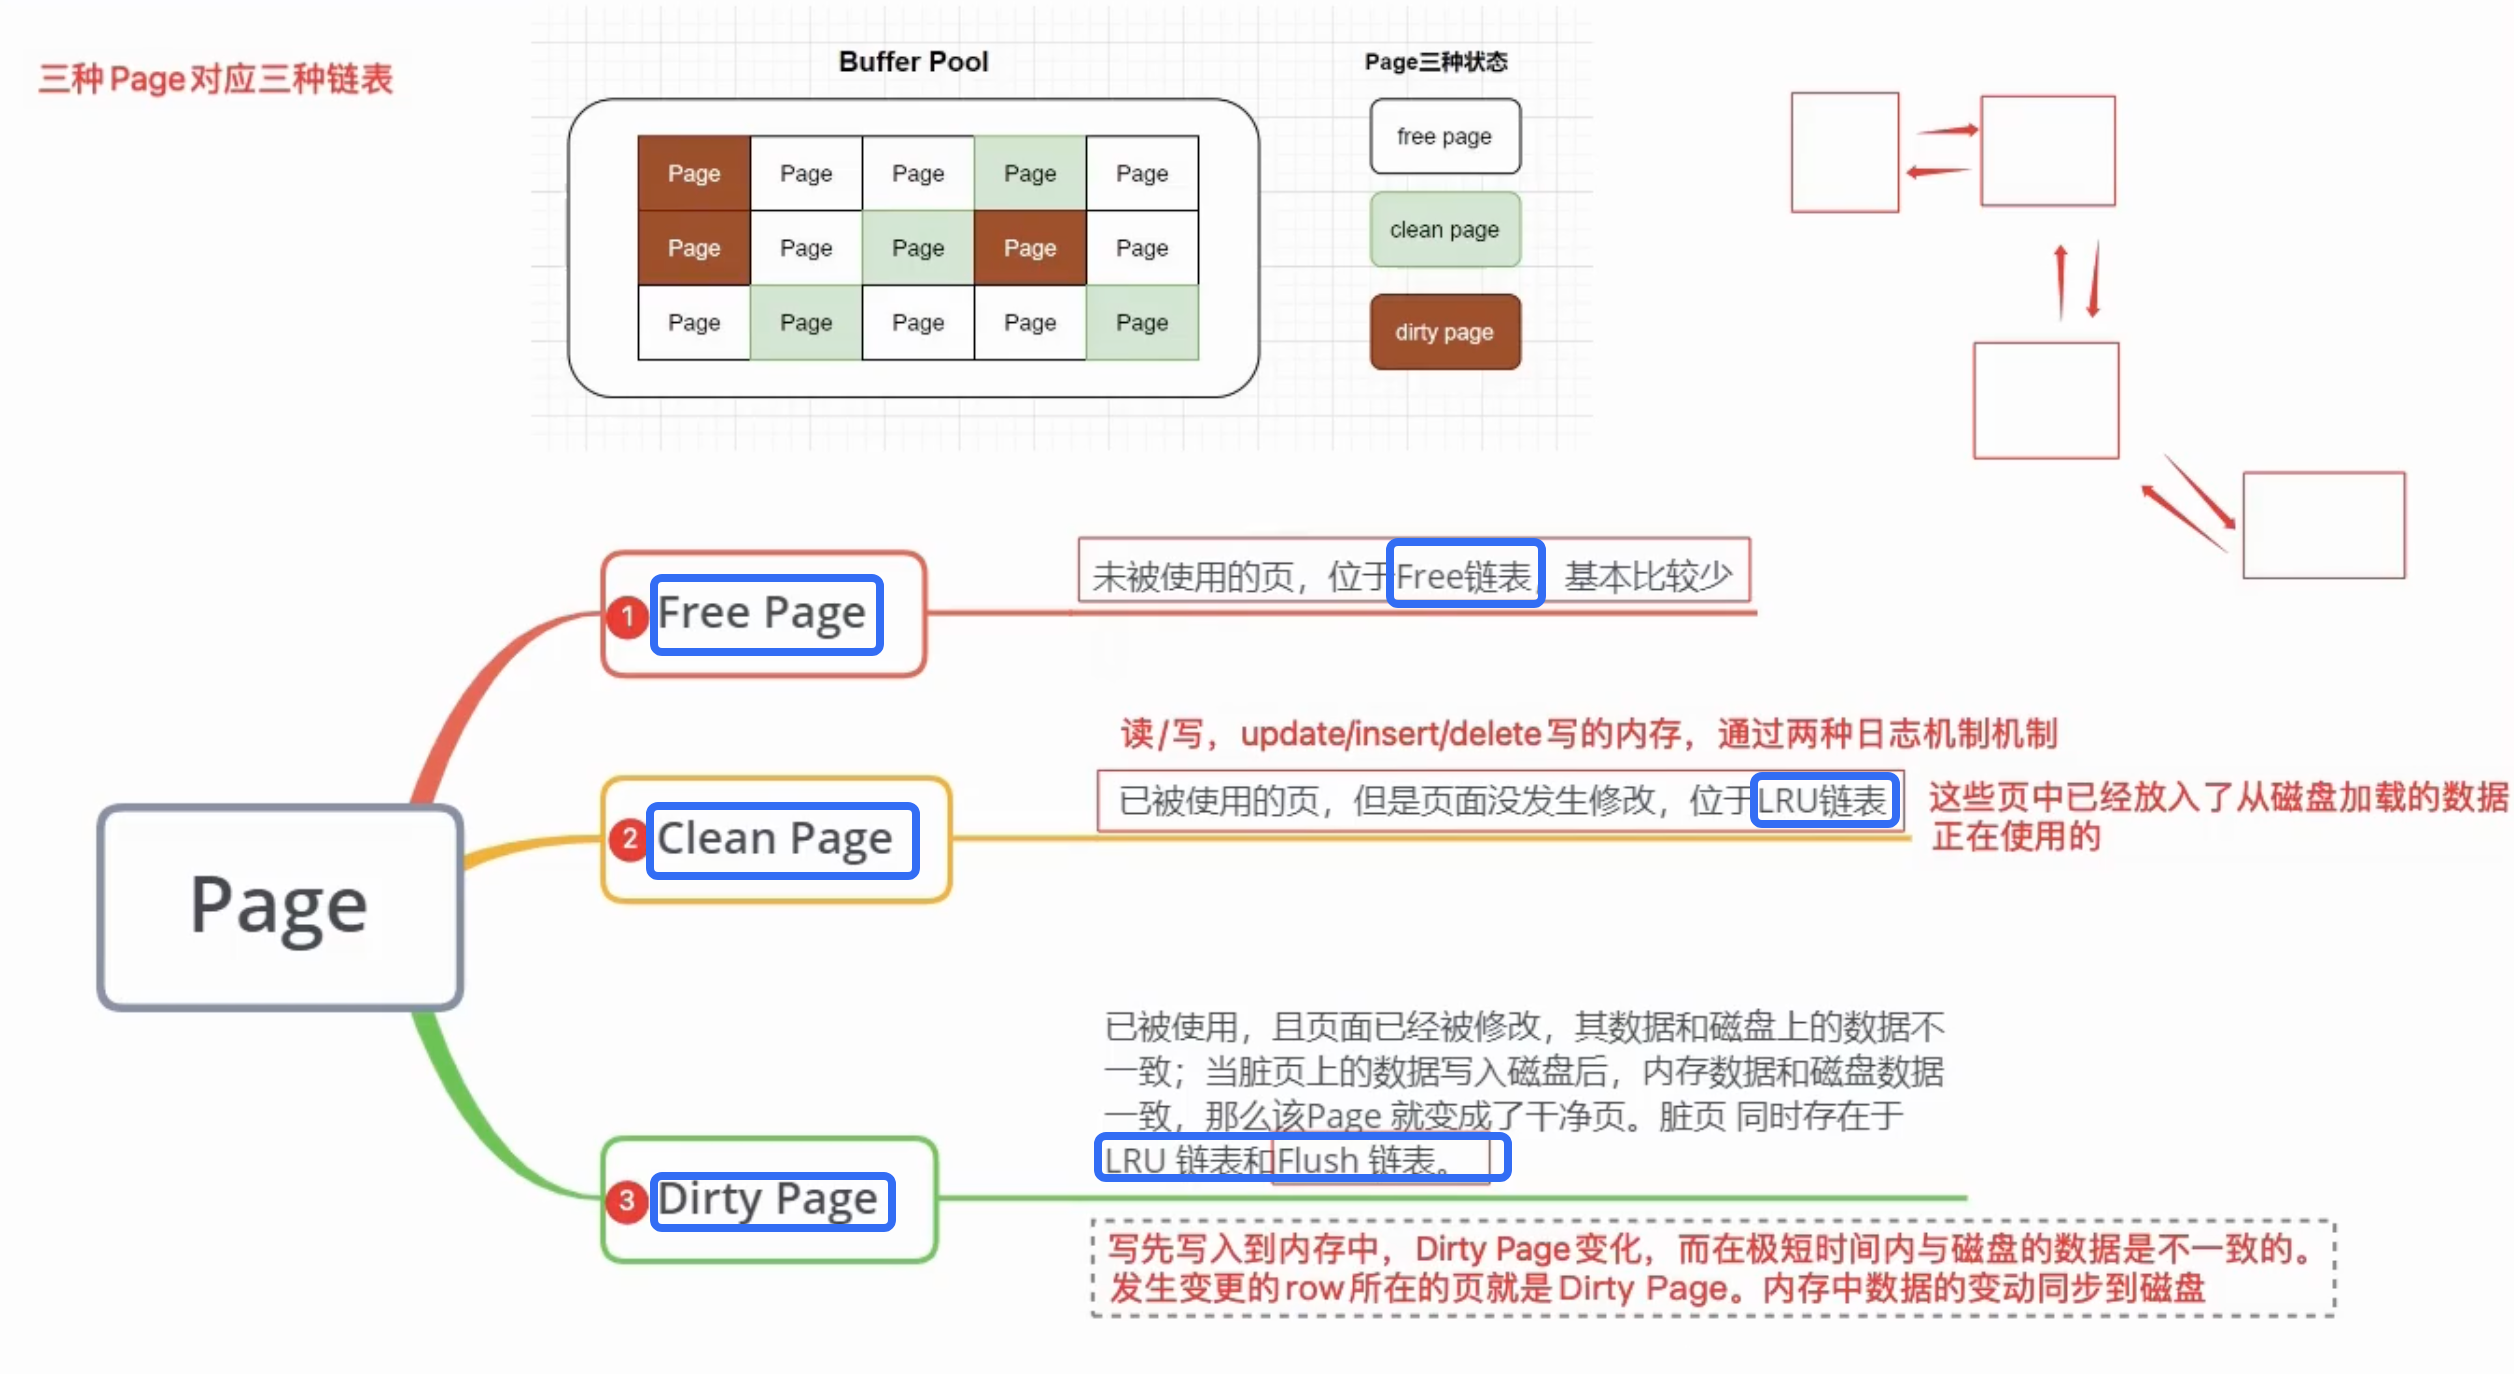
三种页
(1) Free List
- Free 链表存放的是空闲页面,缓冲池初始化过程中(在MySQL启动时进行初始化),向操作系统申请连续的内存空间,然后划分成若干个【控制块&缓冲页】的键值对。
- Free List是把所有空闲的缓冲页对应的控制块作为一个个的节点放到一个链表中,这个链表便称之为free链表。
- 基节点: free链表中只有一个基节点是不记录缓存页信息(单独申请空间),它里面就存放了free链表的头节点的地址、尾节点的地址、还有free链表里当前有多少个节点,等于是存放的自身的描述信息/元数据。
- 在执行SQL的过程中,每次成功load 页面到内存后,会判断Free 链表的页面是否够用。如果不够用的话,就刷新 LRU 链表(将冷数据页从内存中释放)和Flush 链表来释放空闲页(将数据变动写入磁盘)。如果够用,就从Free 链表里面删除对应的页面,在LRU 链表增加页面,保持总数不变。
磁盘加载页的流程:
- 从Free链表中取出一个空闲的控制块(对应缓冲页)。
- 把该缓冲页对应的控制块的信息填上(例如:页所在的表空间、页号之类的信息)。
- 把该缓冲页对应的Free链表节点(即:控制块)从链表中移除,表示该缓冲页已经被使用了。
(2) Flush List
表示需要刷新到磁盘的缓冲区,管理脏页(Dirty Page)内部Page按修改时间排序。
InnoDB引擎为了提高处理效率,在每次修改缓冲页后,并不是立刻把修改刷新到磁盘上,而是在未来的某个时间点进行刷新操作。所以需要使用到flush链表存储脏页,凡是被修改过的缓冲页对应的控制块都会作为节点加入到Flush链表。Flush链表的结构与free链表的结构相似。
- Flush 链表里面保存的都是脏页,也会存在于LRU 链表。
- 当有页面被修改的时候,对应的Page进入Flush 链表
- 如果当前页面已经是脏页,就不需要再次加入Flush List,否则是第一次修改,需要加入Flush 链表
- 当Page Cleaner线程执行Flush操作的时候,从尾部开始Scan,将一定的脏页写入磁盘,推进检查点,减少Recover的时间
Change Buffer
Chnage Buffer,又称写缓冲区、变更/更改缓冲区。
更改缓冲区是一种特殊的数据结构,当辅助索引/次要索引(非唯一索引)页面不在缓冲池中时,它会缓存对这些页面的更改。当页面通过其他读取操作加载到缓冲池时,缓冲更改可能由INSERT、UPDATE或DELETE操作(DML)而合并。
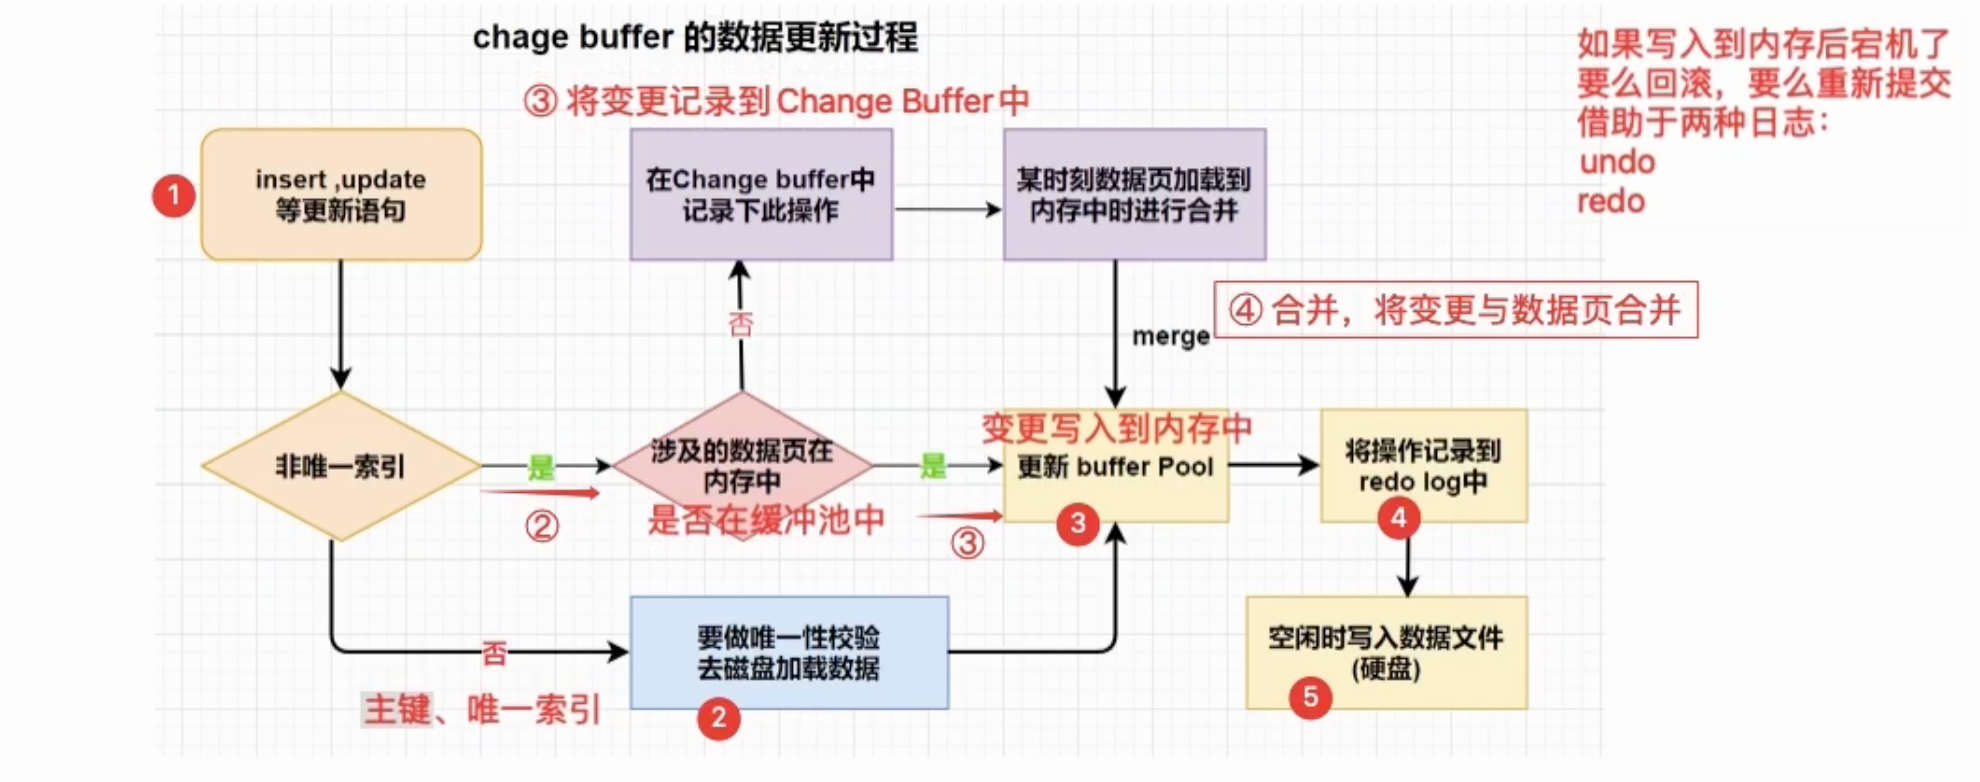
Change Buffer更新机制:
情况1:对于唯一索引来说,需要将数据页读入内存,判断到没有冲突,插入这个值,语句执行结束;
情况2:对于普通索引来说,则是将更新记录在 Change Buffer,流程如下:
- 更新一条记录时,该记录在BufferPool存在,直接在BufferPool修改,一次内存操作。
- 如果该记录在Buffer Pool不存在(没有命中),在不影响数据一致性的前提下,InnoDB 会将这些更新操作缓存在 Change Buffer 中不用再去磁盘查询数据,避免一次磁盘IO。
- 当下次查询记录时,会将数据页读入内存,然后执行Buffer Pool中与这个页有关的操作,通过这种方式就能保证这个数据逻辑的正确性。
什么情况下进行 merge ?
将 Change Buffer 中的操作应用到原数据页,得到最新结果的过程称为merge 。
变更写入到Change Buffer后,此时变只是在Change Bufer这(此刻并没有将数据写入到磁盘),而Buffer Pool中没有该数据对应的数据页。将有查询进来加载到变更数据对应的数据页(没有修改),此时会将Change Buffer中的变更信息与加载到缓冲池中的数据页进行合并。
合并的意义:
Buffer Pool可以将变动刷到磁盘(数据同步,线程异步)
将变动从Change Pool写入到Buffer Pool
提升效率,减少磁盘IO。
思考:如果不在内存中(Buffer Pool),把数据页加载到Buffer Pool中,在Buffer Pool中更新不好吗?为什么要多个Change Buffer呢?
因为非唯一对应的数据是很长多的,有可能涉及到非常多的数据页,去磁盘进行大量的扫描工作。 (效率极低)
Change Buffer,实际上它是可以持久化的数据。也就是说:Change Buffer在内存中有拷贝,也会被写入到磁盘上,以下情况会进行持久化:
- 访问(Select)这个数据页会触发 merge
- 系统有后台线程会定期 merge。
- 在数据库正常关闭(shutdown)的过程中,也会执行 merge 操作。
写缓冲区,仅适用于非唯一普通索引页,为什么?
如果在索引设置唯一性,在进行修改时,InnoDB必须要做唯一性校验,因此必须查询磁盘,做一次IO操作。
会直接将记录查询到Buffer Pool中,然后在缓冲池修改,不会在ChangeBuffer操作。
配置缓冲区:
当在表上执行INSERT、UPDATE和DELETE操作时,索引列的值(特别是辅助键的值)通常按未排序顺序排列,需要大量的I/O才能使辅助索引更新。当相关页面不在缓冲池中时,更改缓冲区缓存对辅助索引条目的更改,从而通过不立即从磁盘读取页面来避免昂贵的I/O操作。当页面加载到缓冲池时,缓冲更改会合并,更新后的页面稍后会刷新到磁盘。当服务器几乎处于空闲状态和缓慢关机期间,InnoDB主线程合并缓冲更改。
由于更改缓冲可以减少磁盘读写,因此更改缓冲对I/O绑定的工作负载最有价值;例如,具有大量DML操作(如批量插入)的应用程序受益于写缓冲(Change Buffers)。
然而,更改缓冲区占据了缓冲池的一部分,减少了可用于缓存数据页面的内存。如果工作集几乎适合缓冲池,或者如果你的表的辅助索引相对较少,则禁用更改缓冲可能会有用。如果工作数据集完全适合缓冲池,则更改缓冲不会施加额外的开销,因为它仅适用于不在缓冲池中的页面。
innodb_change_buffering变量控制InnoDB执行更改缓冲的程度。您可以启用或禁用插入的缓冲、删除操作(当索引记录最初标记为删除时)和清除操作(当索引记录被物理删除时)。更新操作是插入和删除的组合。
1 | show variables like '%innodb_change_buffering%'; |
允许innodb_change_buffering值包括:
- all
默认值:缓冲区插入、删除标记操作和清除。 - none
不要缓冲任何操作。 - inserts
缓冲区插入操作。 - deletes
缓冲区删除标记操作(当索引记录最初被标记为删除时,不是物理删除)。 - changes
缓冲插入和删除标记操作。 - purges
缓冲在后台发生的物理删除操作。
配置更改缓冲区最大大小:
通过innodb_change_buffer_max_size变量可以更改缓冲区(Change Buffer)的最大大小配置为缓冲池总(Buffer Pool)大小的百分比。默认情况下,innodb_change_buffer_max_size占Buffer Pool的25%,最大设置为50%。
考虑在具有大量插入、更新和删除活动的MySQL服务器上增加innodb_change_buffer_max_size,其中更改缓冲区合并与新的更改缓冲区条目跟不上进度,导致更改缓冲区达到最大大小限制。
考虑在MySQL服务器上使用数据经常用于查询,或者如果更改缓冲区占用与缓冲池共享的内存空间过多,导致页面比预期更快地从缓冲池中老化,则考虑减少innodb_change_buffer_max_size。
自适应哈希索引
基于二级索引的热点查询缓存
InnoDB存储引擎会监控对表上索引页(二级索引,非主键的索引,比如在name列创建的索引)的查询,自动建立合适的Hash索引,提升数据页的访问效率。
特点:
- 哈希索引,查询消耗O(1),非常高的
- 降低对二级索引树的频繁访问
- 自适应(不用开发者自己去维护,由InnoDB引擎去维护)
缺点:
- Hash自适应索引会占用Buffer Pool
- 只适合与等值查询
- select * from table where index_col = “郭德纲”;
- 范围查询不可以
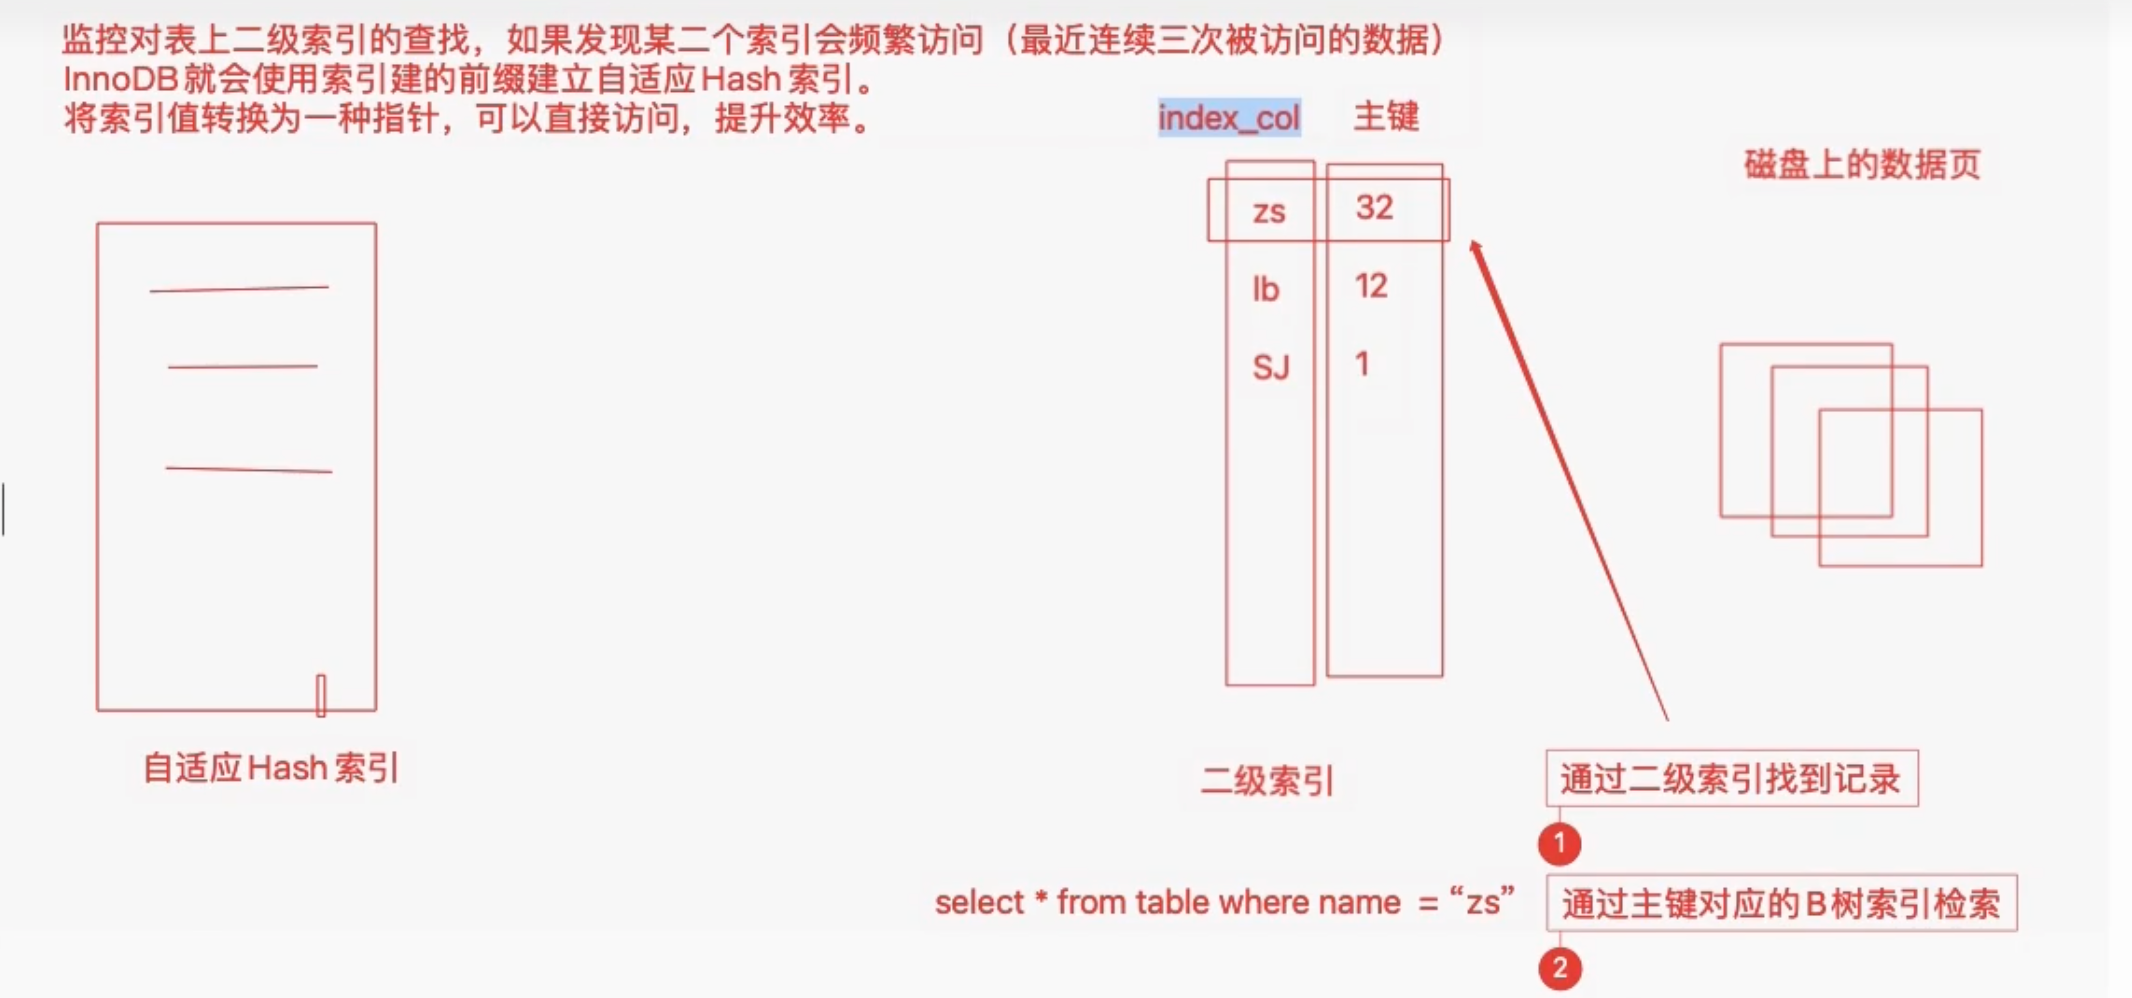
自适应散列索引使InnoDB能够在具有适当组合工作负载和缓冲池充足内存的系统上运行更像内存数据库(接近于Redis),而不会牺牲事务功能或可靠性。自适应哈希索引由innodb_adaptive_hash_index变量启用,或在服务器启动时由--skip-innodb-adaptive-Hash-index关闭。
1 | show variables like '%innodb_adaptive_Hash_index%'; |
Log Buffer
Log Buffer:日志缓冲区,主要是用于记录InnoDB引擎日志,在DML操作时会产生Redo和Undo日志,该缓冲区是写入磁盘上日志文件的数据的内存区域,用来保存要写入磁盘上Log文件(Redo/Undo)的数据,日志缓冲区的内容定期刷新到磁盘Log文件中。日志缓冲区满时会自动将其刷新到磁盘,当遇到BLOB或多行更新的大事务操作时,增加日志缓冲区可以节省磁盘I/O。
参数配置:
日志缓冲区大小由innodb_log_buffer_size变量定义。默认大小为16MB。日志缓冲区的内容定期刷新到磁盘。
- 日志缓冲区使事务能够运行,而无需在事务提交之前将重做(Redo)日志数据写入磁盘。
- 如果有更新、插入或删除许多行的事务,增加日志缓冲区的大小将保存磁盘I/O。
innodb_flush_log_at_trx_commit变量控制日志刷新频率,默认为1
- 0:每隔1秒写日志文件(从内存写入到磁盘,Log Buffer–> OS Cache–>刷盘OS Cache—>判断)和刷盘操作,最多丢失1秒数据
- 1:事务提交,立刻写日志文件和刷盘,数据不丢失,但是会频繁IO操作
- 2:事务提交,立刻写日志文件,每隔1秒钟进行刷盘操作
磁盘
表空间
表空间(Tablespaces):用于存储表结构和数据(含索引)。
表空间又分为系统表空间、独立表(每表 File-Per)空间、通用表空间、临时表空间、Undo表空间等多种类型;
系统表空间(The System Tablespace)
系统表空间是Change Buffer在磁盘上的存储区域。
如果表格是在系统表空间中创建的,而不是独立表空间或通用表空间中创建的,它也可能包含表和索引数据。
在之前的MySQL版本中,系统表空间还包含双写缓冲区,此存储区域位于MySQL 8.0.20的单独双写文件中。
系统表空间可以包含一个或多个数据文件。默认情况下,在数据目录中创建一个名为ibdata1的系统表空间数据文件。系统表空间数据文件的大小和数量由innodb_data_file_path启动选项定义。
1 | show variables like '%innodb_data_file_path%'; |
ibdataba1: 文件名
12M: 默认文件大小
autoextend: 自动扩展,当指定autoextend属性时,数据文件的大小会自动增加64MB的增量
例如,此表空间有一个自动扩展的数据文件:1
2innodb_data_home_dir =
innodb_data_file_path = /ibdata/ibdata1:10M:autoextend
假设随着时间的推移,数据文件已增长到988MB。这是修改大小属性以反映当前数据文件大小后,以及在指定新的50MB自动扩展数据文件后,innodb_data_file_path设置:1
2innodb_data_home_dir =
innodb_data_file_path = /ibdata/ibdata1:988M;/disk2/ibdata2:50M:autoextend
独立表空间(File-Per-Table Tablespaces)
独立表空间(每表表空间)文件表空间包含单个InnoDB表的数据和索引,并存储在文件系统中的单个数据文件中。
每个表在该表空间都有一个对应的文件,包括该表的数据和索引信息。
按表文件表空间配置:
InnoDB默认情况下,在每个表文件表空间中创建表。
此行为由innodb_file_per_table变量控制。
禁用innodb_file_per_table会导致InnoDB在系统表空间中创建表。
这个选项直接控制数据的物理存储方式:
开启时(=1,默认):每个 InnoDB 表都会创建一个独立的 .ibd 数据文件,用于存放该表的数据和索引。
关闭时(=0):所有表的数据和索引都混在一起,存放在共享的 系统表空间(通常是 ibdata1 文件)中。
innodb_file_per_table设置可以在配置文件中指定,
也可以在运行时使用SET GLOBAL语句配置。
在运行时更改设置需要足以设置全局系统变量的特权。
默认开启:
1 | show variables like '%innodb_file_per_table%'; |
选项文件:1
2[mysqld]
innodb_file_per_table=ON
在运行时使用SET GLOBAL:1
mysql> SET GLOBAL innodb_file_per_table=ON;
在MySQL数据目录下的模式目录中的.ibd数据文件中创建每个表空间文件空间。.ibd文件以表命名(table_name.ibd)
通用表空间(General Tablespaces)
共享表空间包括 InnoDB 系统表空间和通用表空间,可以被多个表所共享。
默认情况下在使用InnoDB引擎时创建的表其实使用的独立(File-Per-Table)表空间。
功能:
- 与系统表空间类似,通用表空间是能够为多个表存储数据的共享表空间(需要显式指定)。
- 与独立表空间相比,通用表空间具有潜在的内存优势。
- 服务器在表空间的寿命周期内将表空间元数据保存在内存中。与独立表空间中单独文件的相同数量的表相比,较少的通用表空间中的多个表对表空间元数据消耗的内存更少。
- 通用表空间数据文件可以独立于MySQL数据目录。
- 通用表空间支持所有表行格式和相关功能。
1 | /* 创建通用的表空间 */ |
撤销表空间(Undo Tablespaces)
撤销表空间存储Undo日志(Undo Log通常用于事务回滚),由多个包含Undo日志文件组成。在MySQL 5.7版本之前Undo占用的是System Tablespace共享区,从5.7开始将Undo从System Tablespace分离了出来。
在MySQL8.0.23之前对于数据页为16K,默认撤销表空间的初识大小是10M,在MySQL8.0.23及其之后的版本中初识大小是16M。
可以通过 innodb_undo_directory属性 查看回滚表空间的位置。默认路径是mysql的数据存储路径。
1 | mysql> show variables like 'innodb_undo_directory'; |
MySQL实例最多支持127个撤销表空间,包括初始化MySQL实例时创建的两个默认撤销表空间。
1 | mysql> show variables like '%innodb_undo_tablespace%'; |
要查看撤销表空间名称和路径:
1 | mysql> SELECT TABLESPACE_NAME, FILE_NAME FROM INFORMATION_SCHEMA.FILES |
临时表空间(Temporary Tablespaces)
InnoDB使用会话临时表空间(Session Temporary Tablespaces)和全局临时表空间(Global Temporary Tablespace)。
会话临时表空间
会话临时表空间存储用户创建的临时表和优化器创建的内部临时表,
外部临时表
create temporary table,创建的表就是临时表,会话结束,就自动清理。show tables不显示临时表的信息。
内部临时表
执行复杂查询的时候,比如:Group By、Order By、Distinct、Union等,执行计划中包含Using Temporary,还有就是在执行Undo回滚的时候,如果空间不足的情况下,MySQL内部将使用自动生成的临时表。
从MySQL 8.0.16开始用于磁盘内部临时表的存储引擎是InnoDB,以前是MYISAM引擎。
服务器启动时,会创建一个由10个临时表空间组成池(文件后缀为.ibt),当会话断开连接时,其占用的临时表空间将被释放回池中。池的大小永远不会缩小,磁盘空间会根据需要自动添加到池中。
临时表空间池在正常关机或初始化中止时被删除。innodb_temp_tablespaces_dir变量定义了创建会话临时表空间的位置。默认位置是数据目录中的#innodb_temp目录。如果无法创建临时表空间池,则拒绝启动。
1 | mysql> show variables like '%innodb_temp_tablespaces_dir%'; |
1 | $> cd BASEDIR/data/#innodb_temp |
它的关键机制是按需分配、用完即还:每个会话首次需要创建磁盘临时表时,才会从预分配的池中获取一个表空间;当会话断开连接时,它占用的临时表空间会被截断(清空数据)并释放回池中,等待下一个会话使用。这样可以有效隔离各会话的临时数据,并实现资源的循环利用。
全局临时表空间
全局临时表空间(ibtmp1)存储对用户创建的临时表进行更改的回滚段。innodb_temp_data_file_path变量定义了全局临时表空间数据文件的相对路径、名称、大小和属性。如果没有为innodb_temp_data_file_path指定值,默认行为是在innodb_data_home_dir目录中创建一个名为ibtmp1的自动扩展数据文件。初始文件大小略大于12MB。
全局临时表空间在正常关机或中止初始化时被删除,并在每次启动服务器时重新创建。全局临时表空间在创建时会收到动态生成的空间ID。如果无法创建全局临时表空间,则拒绝启动。如果服务器意外停止,则不会删除全局临时表空间。在这种情况下,数据库管理员可以手动删除全局临时表空间或重新启动MySQL服务器。重新启动MySQL服务器会自动删除并重新创建全局临时表空间。
默认情况下,全局临时表空间数据文件会自动扩展,并根据需要增加大小。
1 | mysql> SELECT @@innodb_temp_data_file_path; |
要检查全局临时表空间数据文件的信息:1
2
3
4
5
6
7
8
9mysql> SELECT FILE_NAME, TABLESPACE_NAME, ENGINE, INITIAL_SIZE, TOTAL_EXTENTS*EXTENT_SIZE
-> AS TotalSizeBytes, DATA_FREE, MAXIMUM_SIZE FROM INFORMATION_SCHEMA.FILES
-> WHERE TABLESPACE_NAME = 'innodb_temporary';
+-----------+-------------------+--------+--------------+----------------+-----------+--------------+
| FILE_NAME | TABLESPACE_NAME | ENGINE | INITIAL_SIZE | TotalSizeBytes | DATA_FREE | MAXIMUM_SIZE |
+-----------+-------------------+--------+--------------+----------------+-----------+--------------+
| ./ibtmp1 | innodb_temporary | InnoDB | 12582912 | 12582912 | 6291456 | NULL |
+-----------+-------------------+--------+--------------+----------------+-----------+--------------+
1 row in set (0.00 sec)
要限制全局临时表空间数据文件的大小,请将innodb_temp_data_file_path为指定最大文件大小。例如:1
2[mysqld]
innodb_temp_data_file_path=ibtmp1:12M:autoextend:max:500M
配置innodb_temp_data_file_path需要重新启动服务器。
在一个临时表上执行修改操作(如 INSERT、UPDATE、DELETE)时,用于支持事务回滚的“撤销数据”就存放在这里。
它的生命周期与服务器实例绑定:正常关闭时会被删除,每次启动时重新创建。
双写缓冲区(Double Write Buffer)
双写缓冲区是一个存储区域,InnoDB将数据页写入到 InnoDB 数据文件之前,会写入从缓冲池中刷新的页面。如果页面写入过程中存在操作系统、存储子系统或意外的mysqld进程退出,InnoDB可以在崩溃恢复期间从双写缓冲区找到数据页的副本。
在MySQL 8.0.20之前,双写缓冲区位于 InnoDB 系统表空间中。从MySQL 8.0.20起,双写缓冲区位于双写文件中。
什么是写失效(部分页失效)
InnoDB的页(16K)和操作系统的页大小不一致,InnoDB页大小一般为16K,操作系统页大小为4K,InnoDB的页写入到磁盘时,一个页需要分4次写。如果存储引擎正在写入页的数据到磁盘时发生了宕机,可能出现页只写了一部分的情况,比如只写了4K,就宕机了,这种情况叫做部分写失效(partial page write),可能会导致数据丢失。
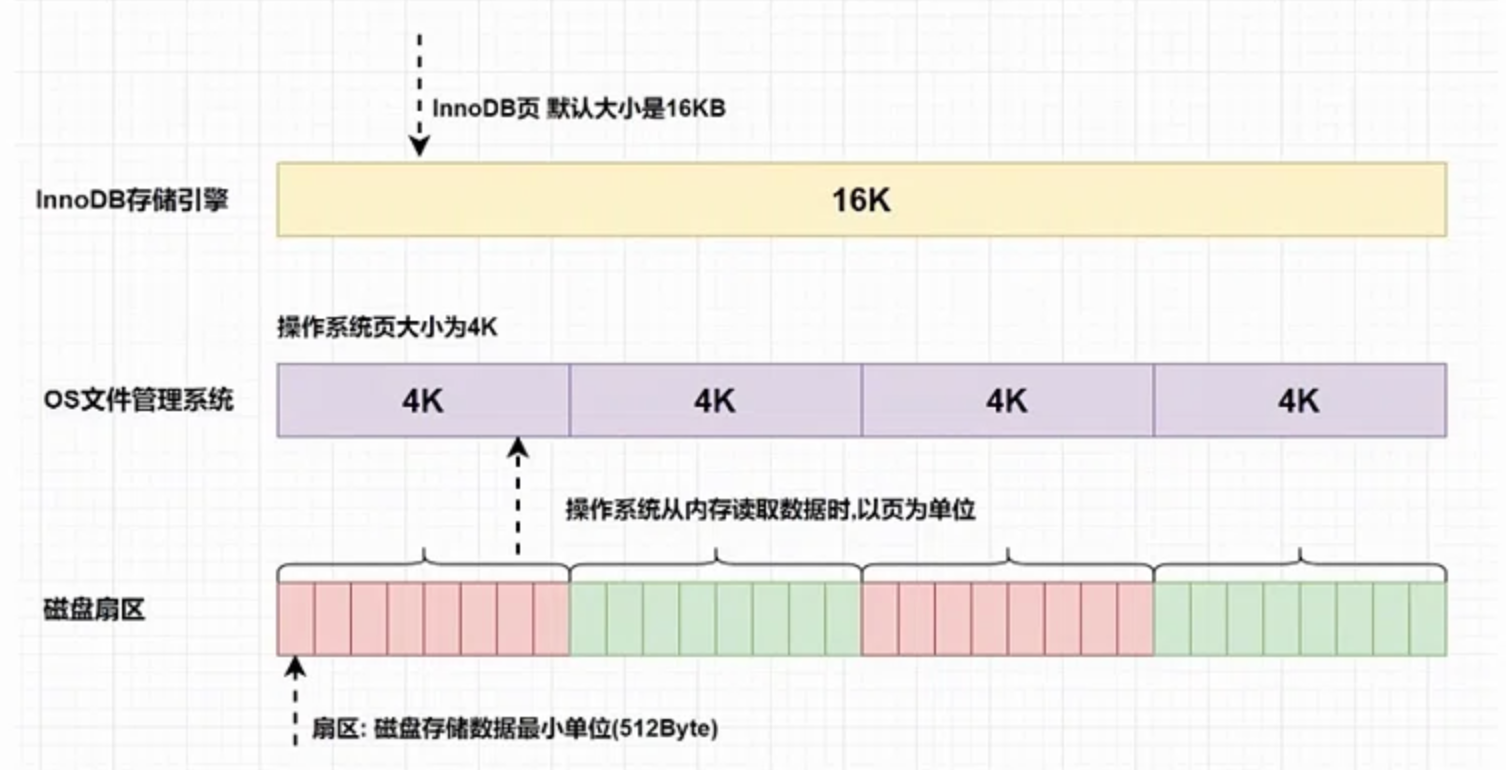
为了解决写失效问题,InnoDB实现了Double write buffer Files。在Buffer Pool的page页刷新到磁盘真正的位置前,会先将数据存在Double write 缓冲区。这样在服务器宕机重启时,如果出现数据页损坏,那么在应用Redo Log之前,需要通过该页的副本来还原该页,然后再进行Redo Log重做,Double Write实现了InnoDB引擎数据页的可靠性。
在MySQL 8.0.20之前,双写缓冲区位于 InnoDB 系统表空间中。从MySQL 8.0.20起,双写缓冲区位于双写文件中。
1 | show variables like '%innodb_doublewrite%'; |
innodb_doublewrite变量控制是否启用doublwrite缓冲区。在大多数情况下,默认情况下启用它。
innodb_doublewrite_batch_size变量(在MySQL 8.0.20中引入)控制批量写入的双写页数。此变量用于高级性能调优。默认值应该适合大多数用户。
innodb_doublewrite_dir变量(在MySQL 8.0.20中引入)定义了InnoDB创建双写文件的目录。如果没有指定目录,则在innodb_data_home_dir目录中创建双写文件,如果未指定,该目录默认为数据目录。
innodb_doublewrite_files变量定义了doublewrite文件的数量。默认情况下,为每个缓冲池实例创建两个双写文件
innodb_doublewrite_pages变量(在MySQL 8.0.20中引入)控制每个线程的最大双写页面数量。如果没有指定值,innodb_doublewrite_pages将设置为innodb_write_io_threads值。此变量用于高级性能调优。默认值适合大多数用户。
重做日志,Redo Log。
WAL(Write-Ahead Logging)策略:
WAL的全称是 Write-Ahead Logging,中文称预写式日志(写前日志),是一种数据安全写入机制。就是先写日志,然后再写入磁盘,这样既能提高性能又可以保证数据的安全性,MySQL中的Redo Log就是采用WAL机制。
写后日志:先将数据写入到磁盘,然后将数据写入到日志,这种策略不适合MySQL中使用,适合的场景是内存型数据库的备份。比如Redis的AOF的持久化策略(记录操作命令),宕机恢复进行AOF日志的回放,该方式本质上就是写入日志。
- InnoDB首先将重做(Redo Log)日志信息先放到重做日志缓存
- 按一定频率刷新到重做日志文件(Redo Log File)
为什么使用WAL?
磁盘的写(使用SQL语句执行编辑操作)操作是随机IO,比较耗性能,所以如果把每一次的更新操作都先写入Log中,那么就成了顺序写操作(效率远远高于随机IO),实际更新操作由后台线程再根据Log异步写入。这样对于Client端,延迟就降低了。并且,由于顺序写入大概率是在一个磁盘块内,这样产生的IO次数也大大降低。所以WAL的核心在于将随机写转变为了顺序写,降低了客户端的延迟,提升了吞吐量。
Redo Log 基本概念:
InnoDB引擎对数据的更新,是先将更新记录写入Redo Log日志,然后会在系统空闲的时候或者是按照设定的更新策略再将日志中的内容更新到磁盘之中。这就是所谓的预写式技术(Write Ahead logging)。这种技术可以大大减少IO操作的频率,提升数据刷新的效率。
Redo Log:被称作重做日志,包括两部分:一个是内存中的日志缓冲:Redo Log Buffer,另一个是磁盘上的日志文件:Redo Log file 。默认情况下,重做日志在磁盘上由两个名为ib_logfile0和ib_logfile1的文件物理表示。
MySQL 每执行一条 DML 语句,先将记录写入Redo Log Buffer(Redo日志记录的是事务对数据库做了哪些修改)。后续某个时间点再一次性将多个操作记录写到 Redo Log File 。当故障发生致使内存数据丢失后,InnoDB会在重启时,经过重放Redo,将Page恢复到崩溃之前的状态 通过Redo Log可以实现事务的持久性 。
Redo Log数据落盘流程:
将内存中的数据页持久化到磁盘,需要下面的两个流程来完成:
1 | +-----------------------------------------------------------------------------------+ |
当进行数据页的修改操作时: 首先修改在缓冲池中的页,然后再以一定的频率刷新到磁盘上。
Redo Log Buffer刷新到Redo Log File ,下面三种情况刷新:
- Master Thread每一秒将重做日志缓冲刷新到重做日志文件
- 每个事务(Commit)提交时会将重做日志缓冲刷新到重做日志文件
- 当重做日志缓冲池剩余空间小于1/2时,重做日志刷新到重做日志文件
补充上述三种情况第二种,触发写磁盘过程由参数innodb_flush_log_at_trx_commit控制,表示提交(commit)操作时,处理重做日志的方式。
1 | show variables like '%innodb_flush_log_at_trx_commit%'; |
参数innodb_flush_log_at_trx_commit有效值有0、1、2
- 0表示当提交事务时,并不将事务的重做日志写入磁盘上的日志文件,而是等待主线程每秒刷新。
- 1表示在执行commit时将重做日志缓冲同步写到磁盘(数据安全性有保障,MySQL Server),即伴有fsync的调用
- fsync函数式Linux系统的写入磁盘的函数
- 兼顾了效率和安全性
- 默认值 ,不建议修改
- 2表示将重做日志异步写到磁盘,即写到文件系统的缓存中,不保证commit时肯定会写入重做日志文件。
0,当数据库发生宕机时,部分日志未刷新到磁盘,因此会丢失最后一段时间的事务。
2,当操作系统宕机时,重启数据库后会丢失未从文件系统缓存刷新到重做日志文件那部分事务。
Undo Logs
Undo Logs是一种用于撤销回退的日志,在数据库事务开始之前,MySQL会先记录更新前的数据到 Undo Logs日志文件里面,当事务回滚时或者数据库崩溃时,可以利用 Undo Logs来进行回退。
Undo Log产生和销毁:Undo Log在事务开始前产生;事务在提交时,并不会立刻删除Undo Logs,InnoDB会将该事务对应的Undo Logs放入到删除列表中,后面会通过后台线程Purge Thread进行回收处理。
注意: undo log也会产生Redo Log,因为undo log也要实现持久性保护。
undo log的工作原理:
在更新数据之前,MySQL会提前生成Undo Logs日志,当事务提交的时候,并不会立即删除Undo Logs,因为后面可能需要进行回滚操作,要执行回滚(Rollback)操作时,从缓存中读取数据。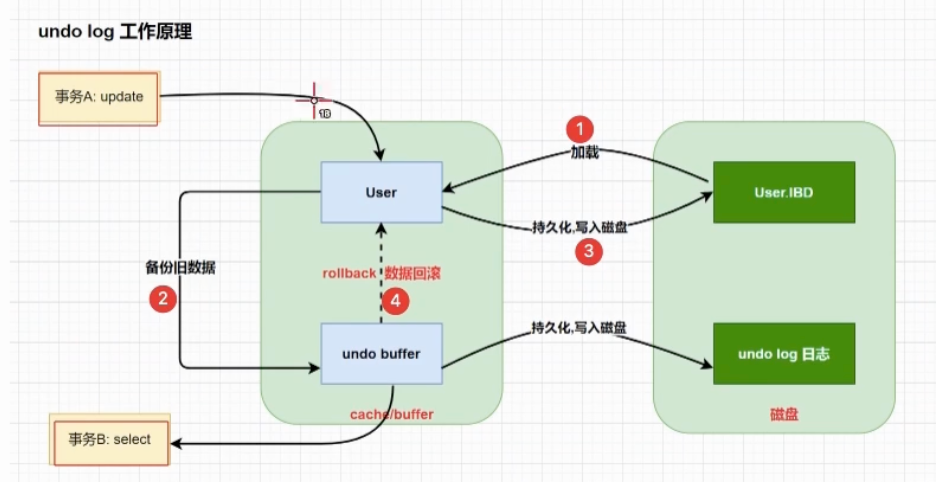
- 事务A执行Update更新操作,在事务没有提交之前,会将旧版本数据备份到对应的Undo Buffer中,然后再由Undo Buffer持久化到磁盘中的Undo Logs文件中,之后才会对User进行更新操作,然后持久化到磁盘.
- 在事务A执行的过程中,事务B对User进行了查询。
InnoDB 线程模型
InnoDB使用多线程模型,后台有多个不同的线程负责不同的任务。
(1) AIO Thread
异步IO(Async IO)广泛用于InnoDB存储引擎,以处理写入IO请求(读写处理),极大提高数据库的性能。IO Thread主要负责这些IO请求的回调。在InnoDB1.0版本之前共有4个IO Thread,分别是write,read,insert buffer和log thread,后来版本将read thread和write thread分别增大到了4个,一共有10个了。
- read thread:负责读取操作,将数据从磁盘(每个表都有一个数据文件)加载到缓存page页 (Buffer Pool),4个。
- write thread:负责写操作,将缓存脏页(Buffer Pool Dirty Pages)刷新到磁盘。
- log thread:负责将日志缓冲区内容刷新到磁盘。(处理log buffer –> 磁盘)
- insert buffer thread:负责将写缓冲内容刷新到磁盘。(处理change buffer–> 磁盘)
(2) 清除线程(Purge Thread)
提交事务后,可能不再需要它使用的撤销日志,因此需要清除线程来回收分配和使用的Undo页面。InnoDB支持多个清除线程,这加快了UNDO页面的恢复速度,提高了CPU使用率,并提高了存储引擎的性能。
1 | mysql> show variables like '%innodb_purge_threads%'; |
InnoDB1.2+(对应的MySQL的版本是5.6)开始,支持多个Purge Thread这样做的目的为了加快回收Undo页(释放内存)。
(3) 页面清洁线程(Page Cleaner Thread)
页面清理线程的作用是将脏页面刷新到磁盘(持久化),脏数据刷盘后相应的Redo Log也就可以覆盖,即可以同步数据,又能达到Redo Log循环使用的目的,会调用Write Thread线程处理。
1 | mysql> show variables like '%innodb_page_cleaners%'; |
(4) 主线程(Master Thread)
Master thread是InnoDB的主线程,负责调度其他各线程,优先级最高,它主要负责从缓冲池到磁盘的数据异步刷新,以确保数据一致性。包含:脏页的刷新(Page Cleaner Thread)、Undo页回收(Purge Thread)、Redo日志刷新(Redo Log thread)、合并写缓冲等。刷新脏页数据到磁盘,根据脏页比例达到90%才操作(innodb_max_dirty_pages_pct)。
一致性日志
主要作用用于事务回撤、崩溃回复、主从同步或者数据同步(数据同步中间件Canal)。
在MySQL Server和 InnoDB 引擎中和一致性相关的有重做日志(Redo Log)、回滚日志(Undo log)和二进制日志(BinLog)。其中Redo Log属于物理日志,Undo log和BinLog属于逻辑日志。
- Redo 和Undo Log是属于InnoDB引擎层的日志
- BinLog是属于服务层
日志分类
物理日志和逻辑日志在存储内容上有很大区别,存储内容是区分它们的最重要手段。
物理日志
- 存储内容:存储数据库中特定记录的变更,通常是 page oriented(面向数据页,记录的日志都是基于数据页),即描述具体某一个 Page 的修改操作;
- 例子:一条更新请求对应的初始值(original value)以及更新值(after value);
逻辑日志:
- 存储内容:存储事务中的一个操作;
- 例子:事务中的 UPDATE、DELETE 以及 INSERT 操作。
更新操作作用于Page42,将字段“Kemera”修改为“camera”。更新操作对应的日志为:
"Page 42:image at 367,2; before:'Ke';after:'ca'"
其中:
- Page 42 用于说明更新操作作用的page;
- 367:用于说明更新操作相对于page的offset;
- 2:用于说明更新操作的作用长度,即length,2代表仅仅修改了两个字符;
- before:’Ke’:这里表示Undo information,也可以称为Undo log;
- after:’ca’:这里表示Redo information,也可以称为Redo Log;
当然,一条物理日志可以有多个字段的修改,下面是一个抽象版本:
" (Page ID, Record Offset,length, (Filed 1, Value 1) ... (Filed i, Value i) ... )"
注意事项:
- 物理日志实际上以字节编码落盘,而不是字符编码,因此通常肉眼不可见
- image的含义通常指代镜像,但这里不是说对page做整个镜像,而是对更改或增量(change/delta)操作做镜像,before image代表写操作作用之前的字段副本,after image代表写操作作用之后的字段副本
物理日志中的一条记录对应某一个Page页上的某些字段做了什么改动的落盘。
逻辑日志
逻辑日志又被称为High-Level Logging,这是相对于物理日志而言的。
有一张CameraLingo表,我们试图纠正itemID为0的拼写错误,即将“Kemera”修改为“Cemera”。逻辑日志的格式如下:
CameraLingo:update(0,'Kermera'=>'camera')
逻辑日志被称为high level的原因是其更抽象,其不需要指明更新操作具体作用于哪一块page,因此也对底层少了一些限制。如果利用物理日志进行宕机后的数据恢复,那么需要确保page不能够改变,但利用逻辑日志并不在乎底层page是否改变。
逻辑日志与SQL语句非常类似,逻辑日志的本质就是对更新语句(update query)本身的落盘。
例子中,只需要指明在哪一张表上的哪一行,对哪些字段进行什么修改即可。逻辑日志不用物理上的page,而用逻辑上的表。
undo log 工作原理
记录修改前的数据,方便发生意外时方便回滚
概述
Redo Log是重做日志,提供前滚操作(重做),Undo log是回滚日志,提供回滚操作(Rollback)。
Undo log有两个作用:提供回滚和多个行版本控制(MVCC Multi-Versioin Concurrency Control)。
事务回滚(日志回滚):
在设计数据库时,我们假设数据库可能在任何时刻,由于如硬件故障,软件Bug,运维操作等原因突然崩溃。这个时候尚未完成提交的事务可能已经有部分数据写入了磁盘,如果不加处理,会违反数据库对Atomic的保证,也就是任何事务的修改要么全部提交,要么全部取消。
数据库实现中通常会在正常事务进行中,就不断的连续写入Undo Log(每有一个DML语句执行,都会记录Undo Log),来记录本次修改之前的历史值。当Crash真正发生时,可以在Recovery过程中通过回放Undo Log将未提交事务的修改抹掉(恢复到修改之前的状态)。
既然已经有了在Crash Recovery时支持事务回滚的Undo Log,在正常运行过程中,死锁处理或用户请求的事务回滚也可以利用这部分数据来完成。
存储结构
Innodb存储引擎对Undo的管理采用段的方式。Rollback Segment 称为回滚段,每个回滚段中有1024个Undo Log Segment。每个Undo Log Segment对应一个回滚日志。
一个Rollback Segment = 1024 Undo Log Segment
默认支持128个Rollback Segment,即支持1281024个Undo操作,还可以通过变量 innodb_rollback_segments 自定义多少个Rollback Segment,默认值为128。
1 | mysql> show variables like '%innodb_Undo%'; |
回滚段支持的事务数量取决于回滚段中的撤销插槽数量以及每个事务所需的撤销日志数量。回滚段中的撤销插槽数量因InnoDB页面大小而异。
| InnoDB页面大小 | 回滚段中的撤销槽数量Undo Log Segment(InnoDB页面大小/16) |
|---|---|
| 4096(4KB) | 256 |
| 8192(8KB) | 512 |
| 16384(16KB) | 1024 |
| 32768(32KB) | 2048 |
| 65536(64KB) | 4096 |
存储机制
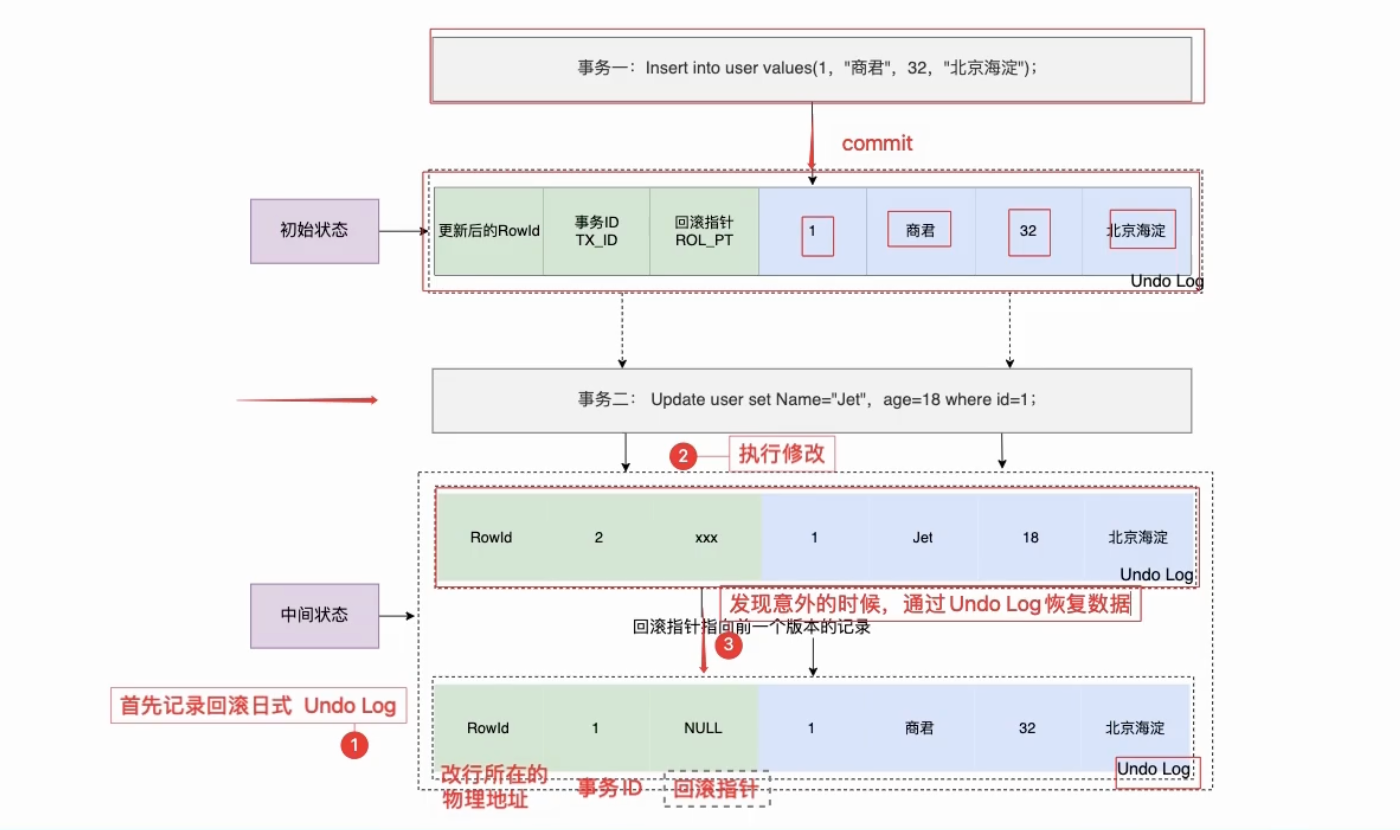
如上图,Undo Log日志里面不仅存放着数据更新前的记录,还记录着RowID、事务ID、回滚指针。其中事务ID每次递增,回滚指针第一次如果是Insert语句的话,回滚指针为NULL,第二次update之后的Undo Log的回滚指针就会指向刚刚那一条Undo Log日志,依次类推,就会形成一条Undo Log的回滚链,方便找到该条记录的历史版本。一旦执行Commit,提交事务,将变动信息真正的写入到磁盘,此时Uno Log也就没有意义,会被清理掉。
工作原理
在更新数据之前,MySQL会提前生成Undo log日志,当事务提交的时候,并不会立即删除Undo log,因为后面可能需要进行回滚操作,要执行回滚(rollback)操作时,从缓存中读取数据。Undo log日志的删除是通过通过后台purge线程进行回收处理的。
事务A手动开启事务,执行更新操作,首先会把更新命中的数据备份到 Undo Buffer 中。
事务B手动开启事务,执行查询操作,会读取 Undo 日志数据返回,进行快照读取。
Redo Log 工作原理
概述
Redo Log,重做日志,也叫重放日志。和Undo log回滚日志一样,都是在数据库发生意外时用来进行数据恢复的。
- Undo log记录的是数据更新前的样子,主要保证事务的原子性。
- 例如一个事务包含两个操作:update、update,如果第一个update执行了,但是数据库崩溃了,数据出现了中间状态,违反了事务的原子性,可以通过Undo Log回滚,将数据恢复到之前的样子。
- Redo Log则记录的是事务执行过程中的修改情况(记录的是修改之后),Redo Log主要保证事务的持久性
- 例如一个事务:insert,加入已经将事务提交了,修改数据页(Dirty Page),崩溃了,恢复就可以通过redo log进行回放,修改后的数据就恢复了。
当数据库对数据做修改的时候,需要把数据页从磁盘读到buffer pool中,然后在buffer pool中进行修改(从内存中修改快),那么这个时候buffer pool中的数据页就与磁盘上的数据页内容不一致,称buffer pool的数据页为dirty page 脏数据,如果这个时候发生非正常的DB服务重启,那么这些数据还没在内存,并没有同步到磁盘文件中(注意,同步到磁盘文件是个随机IO),也就是会发生数据丢失。
如果这个时候,能够在有一个文件,当buffer pool 中的数据页变更结束后,把相应修改记录记录到这个文件(注意,记录日志是顺序IO,效率非常高,不需要寻址),那么当DB服务发生crash,进行恢复DB的时候,可以根据这个文件的记录内容,重新持久化刷新到磁盘文件,保持数据的一致性。
这个文件其实就是Redo Log,用于记录数据修改后的记录,顺序记录,主要用于数据的持久化操作。写入到磁盘中的数据页中属于随机IO,效率低。
Redo Log的作用
1、保证事务的持久性
如果buffer pool缓冲池中的脏页【脏数据】还没有进行刷盘的时候,此时数据库发生crash,重启服务后,我们可以通过Redo Log日志找到需要重放到磁盘文件的那些数据记录。
2、提高事务提交的速度
buffer pool缓冲池中的数据直接刷新到磁盘,是一个随机IO,效率较差,而把buffer pool中的数据记录到Redo Log,是一个顺序IO,可以提高事务提交的速度。例如:
我们执行了一条更新语句:
1 | update User set name = '弼马温' where id = 1 --更新前name = '齐天大圣' |
此时Redo Log就会用来存在name = ‘弼马温’这条更新后的新纪录,如果在刷盘时发生异常,我们可以通过Redo Log找到这条记录,然后进行重放操作,以保证事务的持久性。
工作原理
和Undo log相反,Redo Log记录的是新数据的备份。在事务提交前,只要将Redo Log持久化即可,
不需要将数据持久化,不需要将数据持久化,不需要将数据持久化,重要的事情说三遍!。当系统崩溃时,虽然数据没有持久化,但是Redo Log已经持久化到磁盘中,系统可以根据Redo Log的内容,将所有数据恢复到最新的状态。
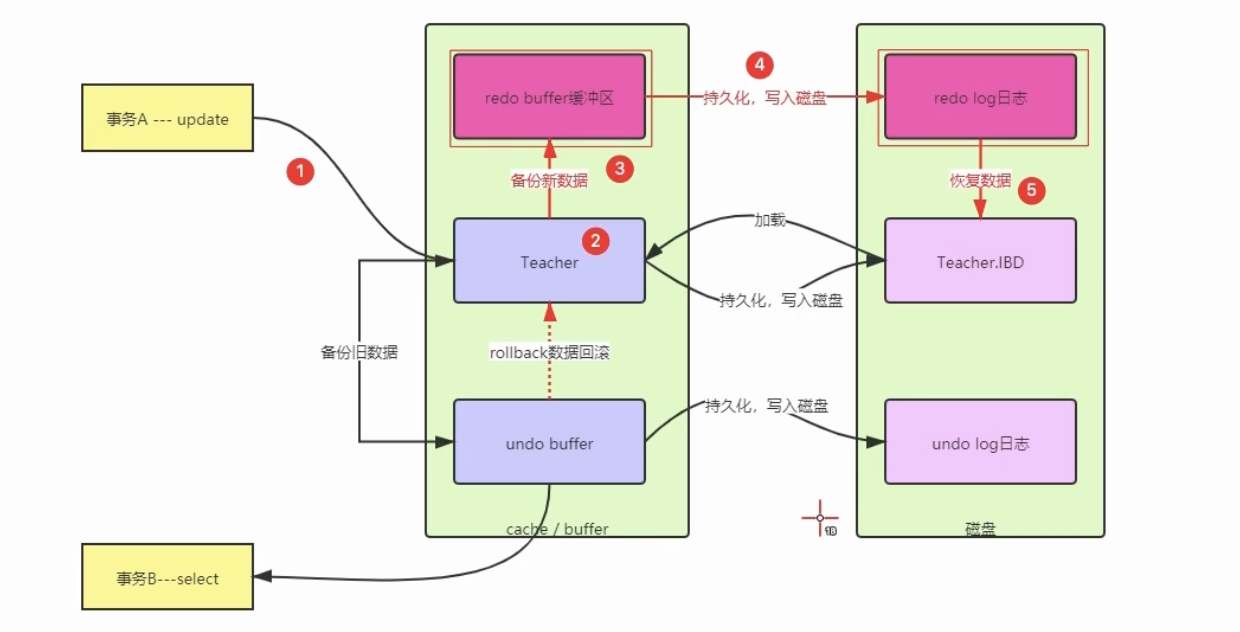
假设有A、B两个数据,值分别为1, 2,开始一个事务,事务的操作内容为:把1修改为3,2修改为4,那么实际的记录如下(简化):
- 事务开始.
- 记录A=1到Undo log.
- 修改A=3.
- 记录A=3到Redo Log.
- 记录B=2到Undo log. ——– 记录Undo log回滚日志
- 修改B=4. ——– 修改数据
- 记录B=4到Redo Log. ——– 记录Redo Log重做日志
- 将Redo Log写入磁盘。 ——– Redo Log刷盘持久化
- 事务提交 ——– 提交事务
如上过程,我们可以总结出来Undo + Redo事务的特点:
- 为了保证持久性,必须在事务提交前将Redo Log日志持久化。
- 数据不需要在事务提交前写入磁盘,而是缓存在内存中(数据页 Buffer Pool中的Dirty Page)。
- Redo Log保证事务的持久性。
- Undo log保证事务的原子性。
- 数据必须要晚于Redo Log写入持久存储。
Redo Log的相关参数
innodb_flush_log_at_trx_commit,控制commit动作是否刷新log buffer到磁盘。该变量有3种值:0、1、2,默认为1。
1 | mysql> show variables like '%innodb_flush_log_at_trx_commit%'; |
- innodb_flush_log_at_trx_commit=0:(延迟写)事务提交时不会将log buffer中日志写入到os buffer,然后每秒调用fsync()写入到log file on disk磁盘文件中。
- 这种情况下如果系统崩溃,会丢失1秒钟的数据。
- innodb_flush_log_at_trx_commit=1:(实时写,实时刷)事务每次提交,会保存到log buffer,接着保存到os buffer操作系统缓存,并调用fsync()刷到log file on disk磁盘文件中。
- 这种方式即使系统崩溃也不会丢失任何数据,但是因为每次提交都写入磁盘,IO的性能较差。
- innodb_flush_log_at_trx_commit=2:(实时写,延迟刷),每次事务提交,数据不写到log buffer,仅写入到os buffer,然后是每秒调用fsync () 将os buffer中的日志写入到log file on disk磁盘文件中。
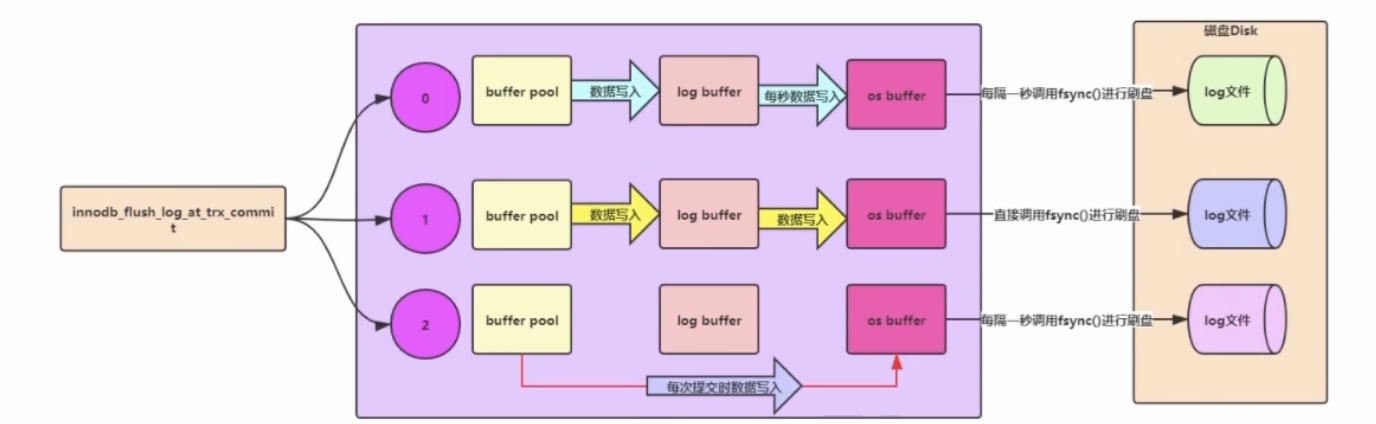
正常情况下,设置参数值为0或者2能提供插入的效率,但在故障的时候可能会丢失1秒钟数据。并且参数值为2和0的时候差距并不大,因为它们都是每秒从os buffer刷到磁盘,它们之间的时间差体现在log buffer刷到os buffer上。
因为将log buffer中的日志刷新到os buffer只是内存数据的转移,并没有太大的开销,所以每次提交和每秒刷入差距并不大。但值为1的性能却会差很多。
- innodb_log_buffer_size
- 指定 log buffer【Redo Log缓存区】的大小,默认16M。延迟事务日志写入磁盘,把Redo Log 放到该缓冲区,然后根据 innodb_flush_log_at_trx_commit参数的设置,再把日志从buffer中flush 到磁盘中。
- innodb_log_file_size
- 指定事务日志的大小,默认5M。
- innodb_log_files_in_group =2
- log group表示的是Redo Log group,一个组内由多个大小完全相同的Redo Log file组成。
- innodb_log_files_in_group指定事务日志组中的事务日志文件个数,默认2个,最大是100个。
BinLog
概述
Redo Log 和Undo Log是属于InnoDB引擎所特有的日志,而MySQL Server也有自己的日志,即 Binary log(二进制日志),简称BinLog。
BinLog是记录所有数据库表结构变更以及表数据修改的二进制日志,不会记录SELECT和SHOW这类操作。BinLog日志是以事件(Event)形式记录,还包含语句所执行的消耗时间。BinLog日志有以下两个重要的使用场景:
- 主从复制:在主库中开启BinLog功能(MySQL8版本中默认开启),这样主库就可以把BinLog传递给从库,从库拿到BinLog后实现数据恢复达到主从数据一致性(从库的数据与主库保持一致)
- 前提是必须在主服务器上开启BinLog
- 开发工作中的主要使用场景(为什么要使用MySQL集群,提升读写性能及可用性)
- 数据恢复:通过mysqlBinLog工具在备份文件恢复的基础上,通过BinLog日志,可以将数据库恢复到某一时间点。
- 操作审计:对所有更改数据的操作进行审计
BinLog数据格式:
MySQL的 BinLog 分为三种数据格式:statement、row 及 mixed 格式。
1 | create table my_table{ |
1.statement 格式
statement 格式是把每次执行的 SQL 语句记录到 BinLog 文件里,在主从复制时,基于 BinLog 里的 SQL 语句进行回放来完成主从复制。批量修改时,记录的不是单条SQL语句,而是批量修改的SQL语句事件。
执行SQL:1
update my_table set status='无效' where id =1
BinLog 中记录的便是上述这条具体的 SQL。
采用 SQL 格式的 BinLog 的好处是内容太少,传输速度快。由于它是记录执行语句,所以,为了让这些语句在Slave端也能正确执行,那么它还必须记录每条语句在执行的时候的一些相关信息,也就是上下文信息(Context),来保证所有语句在Slave端能够得到和在Master端相同的执行结果。
优点:日志量小,减少磁盘IO,提升存储和恢复速度
缺点:在某些情况下会导致主从数据不一致,比如last_insert_id () 、now () 等函数。
2. row 格式
row 格式的 BinLog 会把当次执行的 SQL 命中的那条数据库行的变更前和变更后的内容,都记录到 BinLog 文件里。以上述 statement 格式里的 SQL 作为示例,该 SQL 在 row 格式下执行后会产生如下的数据:
1 | { |
优点:能清楚记录每一个行数据的修改细节,能完全实现主从数据同步和数据的恢复。而且不会出现某些特定情况下存储过程或function,以及trigger的调用和触发器无法被正确复制的问题。
缺点:批量操作,会产生大量的日志,尤其是alter table会让日志暴涨。
3. mixed 模式
mixed(混合)模式是上述两种模式的动态结合。采用 mixed 模式的 BinLog 会根据每一条执行的 SQL 动态判断是记录为row 格式还是 statement 格式。
比如一些 DDL 语句,如新增加字段的 SQL,就没有必要记录为 row 模式,记录为 statement 即可,因为它本身并没有涉及数据变更。对于STATEMENT模式无法复制的操作使用ROW模式保存BinLog。
在实际应用中,推荐使用 row 模式或者 mixed 模式,主要有以下两个原因。
原因一:这两种格式的数据量全,可以让你做更多的逻辑。因为随着业务需求的发展,同步逻辑会出现非常多的个性化需求,越多信息的数据,在编写代码时会越简单。
原因二:row 模式无须解析SQL,实现复杂度非常低。在执行的 SQL 非常复杂时,对 statement 模式里记录的 SQL 的解析需要耗费大量开发精力,越复杂的解析越容易产生 Bug,所以推荐更加简单的 row 模式的数据格式。
1 | show variables like 'binlog_format' |
BinLog日志配置
索引文件:binlog.index,记录哪些日志文件正在被使用
日志文件:binlog.000001等等,记录数据库所有的DDL和DML事件
1 | /* 查看配置 */ |
filename 参数指定二进制文件的文件名,其形式为 filename.number,number 的形式为 000001、000002 等。每次重启MySQL 服务后,都会生成一个新的二进制日志文件,这些日志文件的文件名中 filename 部分不会改变,number 会不断递增。
BinLog落盘策略
BinLog的写入顺序:BinLog cache (write) -> OS cache -> (fsync) disk.
BinLog的写入逻辑比较简单:
事务执行过程中,先把日志写到BinLog cache,这个操作会调用write方法,并没有把数据持久化到磁盘,速度比较快;事务提交的时候,再把BinLog cache写到BinLog文件中,这步会调用fsync将数据持久化到磁盘,速度比较慢。
write表示:写入文件系统缓存,fsync表示持久化到磁盘的时机。
BinLog刷数据到磁盘由参数sync_BinLog进行配置
- sync_BinLog=0的时候,表示每次提交事务都只 write,不 fsync;
- sync_BinLog=1的时候,表示每次提交事务都会执行 fsync;
- sync_BinLog=N(N>1)的时候,表示每次提交事务都 write,但累积 N 个事务后才 fsync。
1 | mysql> show variables like '%sync_BinLog%'; |
注意: 不建议将这个参数设成 0,比较常见的是将其设置为 100~1000 中的某个数值。如果设置成 0,主动重启丢失的数据不可控制。设置成 1,效率低下,设置成N(N>1),则主机重启,造成最多N个事务的BinLog日志丢失,但是性能高,丢失数据量可控。
在出现IO瓶颈的场景中,将sync_BinLog设置成一个比较大的值,可以提升性能。实际业务场景中,通常设置为100~1000中的某个数值。这样做对应的风险是:如果主机发生一场重启,会丢失最近N个事务的BinLog。
如果是核心业务,那么建议1,如果是非核心(非黄金链路)可以容忍部分数据的丢失,可以将值设置为100-1000,如果是我们的日志系统,那么该值可以设置的更大,根本上取决于业务对数据丢失的容忍程度。
和BinLog一样,Redo Log也是先写到Redo Log buffer,然后再合适的时间持久化到磁盘。
InnoDB提供了配置参数innodb_flush_log_at_trx_commit。
1 | mysql> show variables like '%innodb_flush_log_at_trx_commit%'; |
- 设置为0的时候,表示每次事务提交时都只是把Redo Log留在Redo Log buffer中。
- 设置为1的时候,表示每次事务提交时都将Redo Log直接持久化到磁盘。
- 设置为2的时候,表示每次事务提交时都只是把Redo Log写到page cache。
- InnoDB有一个后台线程,每隔1s就会把Redo Log buffer中的日志,调用write写到文件系统的page cache,然后调用fsync持久化到磁盘。
通常我们说MySQL的“双1”配置,指的就是sync_BinLog和innodb_flush_log_at_trx_commit都设置成1.也就是说,一个事务完整提交前,需要等待两次刷盘,一次是Redo Log(prepare阶段),一次是BinLog。
1 | // Redo Log crash-safe |
我们可以看到,WAL机制是减少磁盘写,可是每次提交事务都要写Redo Log和BinLog,磁盘读写次数并没有减少,但是性能有提高,WAL主要得益于Redo Log和BinLog都是顺序写,磁盘的顺序写比随机写速度要快。
日志对比
- Redo Log是InnoDB引擎特有的;BinLog是MySQL的Server层实现的,所有存储引擎都可以使用
- Redo Log是物理日志,记录的是“在XXX数据页上做了XXX修改”;BinLog是逻辑日志,记录的是原始逻辑,其记录是对应的SQL语句
- Redo Log是循环写的,空间一定会用完,需要write pos和check point搭配;BinLog是追加写,写到一定大小会切换到下一个,并不会覆盖以前的日志
- Redo Log作为服务器异常宕机后事务数据自动恢复使用,BinLog可以作为主从复制和数据恢复使用。BinLog没有自动crash-safe能力
Crash Safe指MySQL服务器宕机重启后,能够保证:
所有已经提交的事务的数据仍然存在。
所有没有提交的事务的数据自动回滚。
思考问题
Q1: 数据库是如何根据BinLog 的三种数据格式进行数据恢复的
数据库使用 Binlog 进行恢复时,核心流程是统一的:先用全量备份恢复到某个时间点,然后用 mysqlbinlog 解析出 Binlog 中的事件,重放到数据库里,完成增量恢复。
三种格式的区别,主要体现在 Binlog 里记录了什么,以及 mysqlbinlog 如何解析和重放。
📝 STATEMENT 格式的恢复方式
记录内容:直接记录修改数据的 SQL 语句本身,比如 UPDATE orders SET status=1 WHERE id=100;。
恢复原理:mysqlbinlog 解析出来的就是原始的 SQL 语句。恢复时,直接重新执行这些 SQL 即可。
关键风险:如果原 SQL 包含非确定性函数(如 NOW()、RAND()、UUID()),或者依赖特定的会话变量、执行顺序(如 DELETE ... LIMIT 1 未加 ORDER BY),在恢复环境重新执行时,很可能得到与原始执行不同的结果,导致数据不一致。
📝 ROW 格式的恢复方式
记录内容:不记录 SQL 语句,而是记录每一行数据被修改前后的镜像(前镜像/后镜像)。比如,一个 UPDATE 影响 10 万行,Binlog 里就会有 10 万条行变更记录。
恢复原理:mysqlbinlog 配合 --base64-output=decode-rows -v 参数,可以解析出行变更的详细信息。恢复时,基于这些行数据变更事件,在数据库内部直接应用修改,不涉及重新执行原始 SQL。
关键特性:因为直接记录数据本身的变化,完全避免了 STATEMENT 模式的不确定性问题,恢复结果最可靠。此外,ROW 格式还支持 “闪回”:通过解析 Binlog 生成反向 SQL(如把 DELETE 事件转换成 INSERT),可以精准恢复误删的数据。
📝 MIXED 格式的恢复方式
记录内容:由 MySQL 自动选择。对于安全的、确定性的语句,用 STATEMENT 格式记录;对于可能引起不一致的语句(如含不确定函数),则自动切换为 ROW 格式记录。
恢复原理:mysqlbinlog 解析时,根据每条事件实际的记录格式来决定如何处理。如果解析出的是 SQL,就重放 SQL;如果解析出的是行数据变更,就应用行变更。
实际效果:可以看作是 “智能的 STATEMENT”。它试图在 STATEMENT 的轻量和 ROW 的安全之间做平衡,但仍然以 STATEMENT 为基础,如果 MySQL 判断失误,仍然存在数据不一致的风险。
💡 给生产环境的建议
目前 MySQL 8.0.34 及以后版本已弃用 binlog_format 参数,默认且推荐使用 ROW 格式。因为 ROW 格式是唯一能保证主从/恢复数据绝对一致,并且支持闪回恢复的模式。对于需要精确、安全恢复的生产环境,务必使用 ROW 格式。
Q2: redo log 和 undo log 是怎么帮助数据库恢复数据的
Redo log 和 Undo log 的恢复机制,与 Binlog 有本质区别:Binlog 是逻辑日志,用于”重放”已提交事务;而 Redo/Undo 是物理/逻辑物理日志,用于保证数据库的崩溃恢复(Crash Recovery)和事务原子性。
下面分别说明两者的恢复原理。
一、Redo Log:崩溃恢复的”重做”
1. 核心作用
Redo Log 记录的是“在某个数据页上做了什么修改”(物理逻辑日志),用于保证 已提交事务的持久性(Durability)。
关键机制是 WAL(Write-Ahead Logging):事务提交时,先写 Redo Log(顺序写,快),再异步刷脏页到磁盘(随机写,慢)。只要 Redo Log 落盘,即使数据页还没刷盘,事务也算提交成功。
2. 恢复原理
当数据库异常崩溃后重启,InnoDB 会进入崩溃恢复流程,Redo Log 负责 “重做”:
- 扫描 Redo Log:从最近一次 Checkpoint(检查点)位置开始,向后扫描。
- 重放已提交事务:对于已经提交但数据页尚未刷盘的事务,根据 Redo Log 中的记录,重新应用到数据页上,使数据恢复到崩溃前的状态。
- 保证持久性:这样,已提交的事务不会因为崩溃而丢失。
3. 关键概念:LSN 与 Checkpoint
- LSN(Log Sequence Number):全局递增的日志序列号,标识 Redo Log 的位置。
- Checkpoint:表示”此 LSN 之前的所有脏页都已经刷盘”。恢复时只需从 Checkpoint 之后开始扫描,无需重放全部日志,大大缩短恢复时间。
二、Undo Log:事务回滚与 MVCC 的”撤销”
1. 核心作用
Undo Log 记录的是数据被修改前的旧版本,用于:
- 事务回滚(Rollback):保证原子性(Atomicity)。
- MVCC(多版本并发控制):为读操作提供历史版本,实现一致性读。
2. 恢复原理
Undo Log 的”恢复”分两种场景:
场景 A:事务主动回滚
当事务执行 ROLLBACK 时,InnoDB 会根据 Undo Log 中的记录,反向执行:
INSERT→ 对应DELETEDELETE→ 对应INSERTUPDATE→ 用旧值覆盖新值
从而将数据恢复到事务开始前的状态。
场景 B:崩溃恢复时的回滚
数据库崩溃重启后,Redo Log 会先 “重做” 所有已提交和未提交的事务(因为崩溃时可能有些事务只写了一半)。然后,InnoDB 会检查 Undo Log,找出崩溃时尚未提交的事务,对它们执行 “回滚”,撤销这些未完成事务的影响。
这就是为什么崩溃恢复分两个阶段:先 Redo 重做,再 Undo 回滚。
3. Undo Log 的存储与清理
- Undo Log 存放在 Undo Tablespace(如
undo_001、undo_002)中。 - 事务提交后,Undo Log 不会立即删除,因为 MVCC 可能还需要它提供历史版本。只有当没有更早的 Read View 需要它时,才会被 Purge 线程清理。
三、三者对比总结
| 日志类型 | 性质 | 主要作用 | 恢复方向 | 恢复时机 |
|---|---|---|---|---|
| Binlog | 逻辑日志(Server 层) | 主从复制、增量备份恢复 | 重放已提交事务 | 手动/增量恢复 |
| Redo Log | 物理逻辑日志(InnoDB 层) | 保证持久性 | 重做已提交事务 | 崩溃恢复第一阶段 |
| Undo Log | 逻辑日志(InnoDB 层) | 保证原子性、MVCC | 回滚未提交事务 | 崩溃恢复第二阶段 / 主动回滚 |
四、崩溃恢复的完整流程(一句话概括)
崩溃重启后,InnoDB 先根据 Redo Log 把所有”已提交但未刷盘”的修改重做一遍(保证持久性),再根据 Undo Log 把所有”崩溃时未提交”的事务回滚掉(保证原子性),最终使数据库达到一个一致状态。
这个机制就是经典的 WAL + ARIES 恢复算法 的核心思想:Redo 重做,Undo 回滚。
Q3: Redo Log 和undo log 存的是什么
Redo Log 和 Undo Log 存储的内容,本质区别在于:Redo 存的是”修改后的新值/操作”,Undo 存的是”修改前的旧值”。下面分开说明。
一、Redo Log 存的是什么
Redo Log 记录的是 “在某个数据页上做了什么修改”,属于物理逻辑日志(physiological log)。
具体内容
它记录的不是完整的行数据,而是页级别的修改操作,通常包含:
- 表空间 ID(space ID)
- 数据页号(page number)
- 页内偏移量(offset)
- 修改的具体操作(如”在偏移量 X 处写入值 Y”)
举例
假设执行 UPDATE orders SET status = 1 WHERE id = 100;,Redo Log 里记录的不是这条 SQL,而是类似:
1 | 在表空间 5、页号 20、偏移量 88 处,将值从 0 改为 1 |
关键特点
- 面向页:记录的是对数据页的物理修改。
- 只记新值:只记录”改成什么”,不关心”原来是什么”。
- 用于重做:崩溃恢复时,直接把这些修改重新应用到数据页上。
- 循环写:Redo Log 是固定大小的环形文件(如
ib_logfile0、ib_logfile1),写满后覆盖最旧的部分。
二、Undo Log 存的是什么
Undo Log 记录的是 “数据被修改前的旧版本”,属于逻辑日志。
具体内容
它记录的是反向操作所需的信息,即如何把数据改回去。具体取决于操作类型:
| 操作类型 | Undo Log 记录的内容 |
|---|---|
| INSERT | 记录新插入记录的主键值(回滚时按主键删除) |
| DELETE | 记录被删除记录的完整旧值(回滚时重新插入) |
| UPDATE | 记录被修改字段的旧值(回滚时用旧值覆盖新值) |
举例
同样是 UPDATE orders SET status = 1 WHERE id = 100;(假设原来 status = 0),Undo Log 里记录的是:
1 | id = 100 这条记录的 status 字段,旧值是 0 |
回滚时,就用旧值 0 覆盖回去。
关键特点
- 面向行:记录的是行级别的旧数据。
- 只记旧值:记录”原来是什么”,用于回滚和 MVCC。
- 用于回滚:事务回滚或崩溃恢复时,用旧值撤销修改。
- 支持 MVCC:为一致性读提供历史版本。
- 持久化存储:存放在 Undo Tablespace 中,不是环形覆盖,而是由 Purge 线程按需清理。
三、对比总结
| 维度 | Redo Log | Undo Log |
|---|---|---|
| 记录内容 | 修改后的新值 / 页修改操作 | 修改前的旧值 |
| 日志性质 | 物理逻辑日志 | 逻辑日志 |
| 粒度 | 页级别 | 行级别 |
| 主要作用 | 保证持久性(重做) | 保证原子性、MVCC(回滚) |
| 恢复方向 | 向前重做 | 向后回滚 |
| 存储方式 | 环形文件,循环覆盖 | Undo Tablespace,按需清理 |
四、一句话记忆
Redo Log 记”改成了什么”,用于崩溃后重做;Undo Log 记”原来是什么”,用于回滚和 MVCC。
两者配合,共同保证了 InnoDB 的 ACID 特性:Redo 保证 D(持久性),Undo 保证 A(原子性) 和 I(隔离性,通过 MVCC)。